
 语音小管家
文章来源于PaperWeekly,作者让你更懂AI
1. 风格建模和转换:高表现力语音具有高动态范围,通常难以控制和转换。许多合成模型只学到了输入数据的平均分布,并且缺乏细粒度风格建模能力;
2. 模型泛化:当预测时参考样本的声学风格分布与训练数据存在差异时,合成语音的质量和相似性往往会显著降低。
论文标题:
GenerSpeech: Towards Style Transfer for Generalizable Out-Of-Domain Text-to-Speech
https://arxiv.org/abs/2205.07211
https://github.com/Rongjiehuang/GenerSpeech
研究背景
可泛化语音合成的旨在生成域外风格(音色、情感和韵律)的语音,面临以下挑战:1)高表现力语音中的动态风格特征难以建模;2)模型应足够鲁棒以泛化于音色、情感和韵律未见的域外语音。
研究人员提出了几种建模和传递风格属性的方法:1)全局风格转换使用基于全局特征[1](Global Style Token)建模语音风格。2)细粒度隐变量风格则采用 VAE 来表示细粒度韵律变量,为每个音素提供不同的韵律特征。然而,这些方法在捕捉不同的风格特征方面非常有限,无法同时准确迁移的语者、情感和韵律波动。
研究人员研究了提高模型对未见风格(语者、韵律、情感等)语音泛化能力的方法:
1)数据驱动方法。提高模型鲁棒性的一种流行方法是在大数据集上进行预训练,以扩展数据分布。但这种数据饥饿的方法需要许多数据样本,这通常是昂贵的;
整体方案思路
域外未见语音(OOD; Out-Of-Distribution)的风格迁移,旨在生成与参考语音的风格(例如,说话者身份、情感和韵律)高度相似的样本,该域外参考语音具有与训练数据不同的声学条件,是训练不可见的。
实现更好泛化性的一种直观方法,是通过解耦表示学习将模型分解为领域不可知 (Domain-Agnostic)和领域特定(Domain-Specific)的部分。因此,为了提高文本到语音合成中的通用性,我们设计了几种方法来分别建模语音中的风格不可知(语言内容)和风格特定(例如,语者、情感和韵律)成分:
1)为了提升模型泛化性,我们提出了混合风格层(MSLN)来消除语言内容表示中的风格信息。
2)为了增强建模和传递风格属性,我们引入了多级(Multi-Level)风格编码器,该编码器由语者和情感特征的全局编码器,以及细粒度风格建模的三个(帧级、音素级和词级)局部编码器组成。
2.1 可泛化文本编码器
源域和目标域之间的分布差异通常阻碍了模型的泛化能力。我们提出的混合风格层归一化来消除语音序列中的风格信息,以防止来自具有域外(OOD)自定义语音的话语的风格转换中的退化,并预测风格不可知的韵律变化。
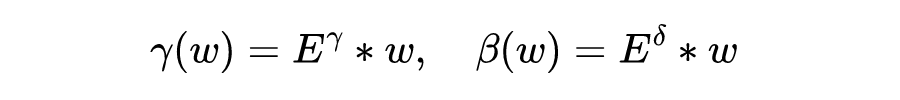
为了解耦风格信息并学习风格不可知的文本表征,一个简单的解决方案是以不匹配、混淆的的风格信息为条件扰动文本序列,并阻止其生成风格一致的文本表征。我们利用领域泛化的最新进展[4],通过扰动训练样本中的风格信息,设计了混合风格层归一化,以提升模型泛化性:
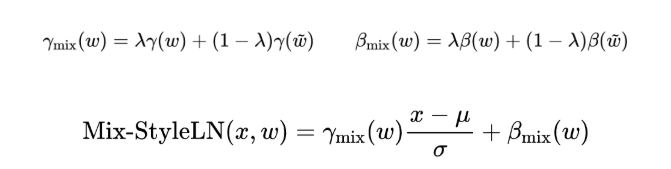
最后,我们采用音高预测器(Style-Agonistic Predictor)来预测风格不可知的韵律变化。通过在可泛化的文本编码器中使用混合风格层归一化,风格不可知(语言内容)和风格特定(例如,说话者身份、情感和韵律)信息相分离,提高语音合成模型的泛化性。
参考文献
[1] Wang Y, Stanton D, Zhang Y, et al. Style tokens: Unsupervised style modeling, control and transfer in end-to-end speech synthesis. In Proc. ICML 2018.
[2] Chen M, Tan X, Li B, et al. AdaSpeech: Adaptive Text to Speech for Custom Voice. In Proc. ICLR 2021
[3] Min D, Lee D B, Yang E, et al. Meta-stylespeech: Multi-speaker adaptive text-to-speech generation. In Proc. ICML 2021.
[4] Zhou K, Yang Y, Qiao Y, et al. Domain generalization with mixstyle. In Proc. ICLR 2021.
[5] Baevski A, Zhou Y, Mohamed A, et al. wav2vec 2.0: A framework for self-supervised learning of speech representations. In Proc. NeurIPS 2020.
[6] Wan L, Wang Q, Papir A, et al. Generalized end-to-end loss for speaker verification In Proc. ICASSP 2018.
[7] Ren Y, Liu J, Zhao Z. Portaspeech: Portable and high-quality generative text-to-speech. In Proc. NeurIPS 2021.
