本文介绍清华大学语音处理与机器智能实验室(Speech Processing and Machine Intelligence, SPMI)与中国移动研究院(CMRI)的联合工作——GUS:一种以预训练语言模型GPT-2为骨架,结合了用户目标状态跟踪的生成式用户仿真器,用于多领域对话系统的强化学习。对话系统与用户仿真器交互,左右互搏,显著提升对话系统性能!
该工作被EMNLP 2022 SereTOD Worshop录用,论文的作者是刘红、蔡予诚、欧智坚、黄毅、冯俊兰。
http://oa.ee.tsinghua.edu.cn/~ouzhijian/pdf/GUS_camera.pdf任务型对话系统与用户仿真器
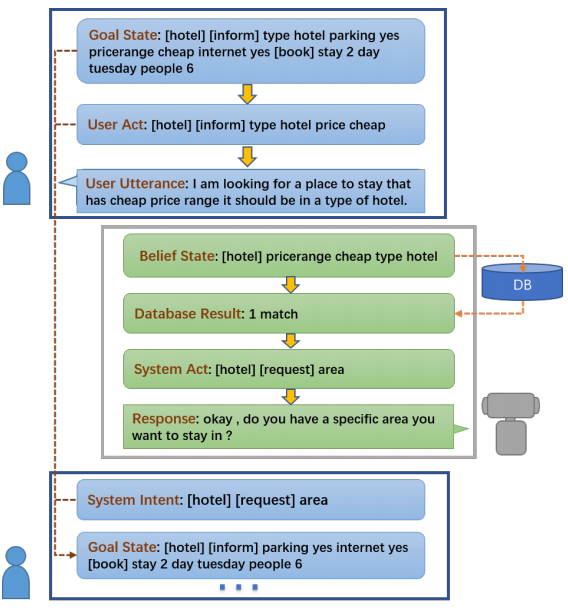
任务型对话系统(Task-oriented Dialog System)的主要目标是,帮助用户完成特定任务,例如预定旅馆、查询机票等。一个任务型对话系统在收到当前轮用户话语之后,需要结合之前的对话内容,理解用户话语(Natural Language Understanding)、跟踪对话状态(Dialogue State Tracking)、查询知识库(Knowledge Base)、决定系统动作(System Act)并生成回复(Natural Language Generation)给用户。对话系统的一个经典理论是,将对话系统表述为马尔可夫决策过程,并通过强化学习进行训练,以优化对话策略(Policy)。强化学习本质是,对话系统通过与用户交互获得奖励来实现学习。然而,直接让系统跟真实用户进行交互不仅成本巨大,而且十分耗时。由此,用户仿真器(User Simulator)应运而生。用户仿真器,顾名思义,其作用是替代真实用户与对话系统进行交互,从而大大降低优化对话系统时的人力和时间开销。一个用户仿真器在收到上一轮的系统回复后,需要理解系统回复,并根据预定义好的用户目标(User Goal)预测用户动作(User Act),再生成用户话语(User Utterance)给系统。用户仿真器可分为两类,基于规则的用户仿真器和数据驱动的用户仿真器。随着任务型对话系统的复杂性增大,数据驱动的用户仿真器显得更加灵活并且性能更加优异,本文主要研究的就是数据驱动的用户仿真器。
- 未有效利用近年来兴起的预训练语言模型,制约其语言理解能力和生成能力;
- 未充分重视用户仿真器中极为重要的部分——用户目标状态跟踪(goal state tracking)。
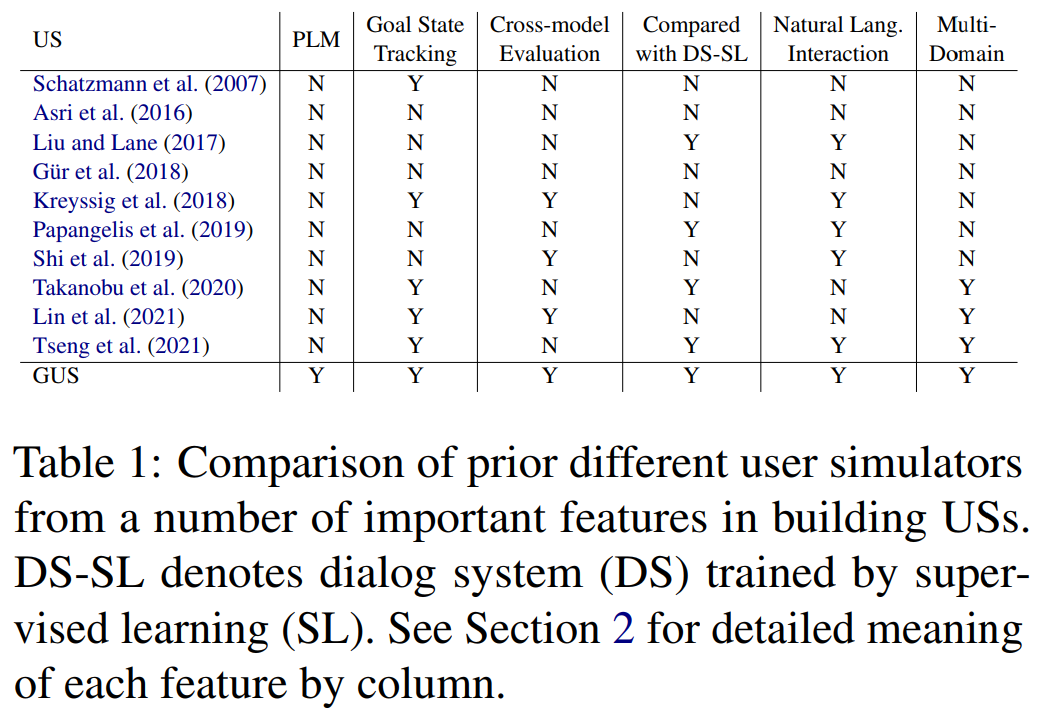
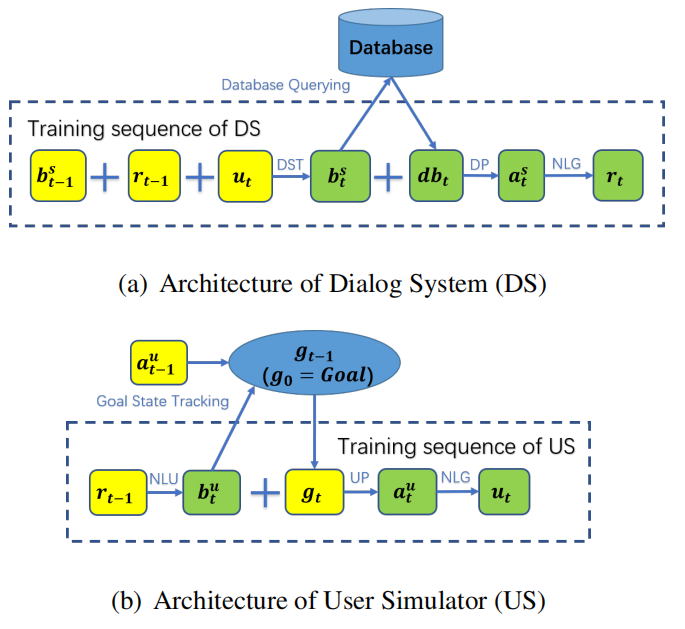
所谓目标状态跟踪,与对话系统的对话状态跟踪有异曲同工之妙。只不过后者是跟踪用户已经提及过的内容,而前者是跟踪在预定义好的用户目标中,用户尚未提及的内容(我们将之定义为目标状态)。目标状态跟踪,就是不断从预定义好的用户目标池中减去用户已提及的部分,得到每一轮的目标状态(例子见上图)。当目标状态为空时,说明用户已经提出所有需求,此时用户仿真器就应该结束对话。目标状态跟踪的好处是,能够保证用户仿真器前后行为的一致性,对预定义好的用户目标里的内容不重不漏。如何为多领域对话系统,构建一个具备目标状态跟踪能力的、端到端的用户仿真器是一个具有挑战性的问题。本文提出了GUS(Generative User Simulator)——生成式用户仿真器,一种以预训练语言模型GPT-2为骨架,具备显式目标状态跟踪能力的用户仿真器。GUS不仅解决了上述两个主要问题,而且如下表所示,GUS对用户仿真器进行了更加全面的研究和实验,超越了文献中的用户仿真器研究。总的来说,GUS的特点包括:- 比较了有监督训练的对话系统与基于用户仿真器的强化对话系统,来评估用户仿真器;
- 能够生成丰富的自然语言,而不仅仅是在语义层面交互或者基于人工制定的模板进行回复;
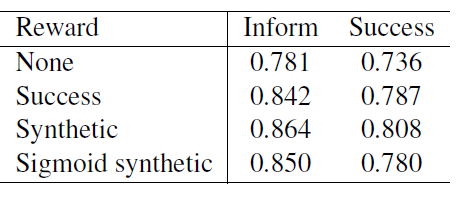
GUS采用马尔可夫生成架构(Markovian Generative Architecture,MGA),仅使用上一轮的信息来做当前轮的生成。具体而言,GUS首先根据上一轮的系统回复来预测上一轮的系统意图,然后利用上一轮的系统意图和上一轮的用户动作去更新目标状态(即从上一轮的目标状态中减去相应的内容),最后模型利用更新后的目标状态去预测用户动作,生成用户话语。在训练时,模型的输入和输出会被序列化并拼接在一起作为一个训练样本,用于微调预训练语言模型GPT-2。当GUS模型训练好后,一般通过进行强化学习实验来验证GUS的系统性能,也就是说,利用强化对话系统(相比纯粹有监督的对话系统而言)的性能提升,来评估用户仿真器的性能。对话系统仍然采用MGA架构的GPT-2对话系统,首先将在数据集上以有监督方式训练对话系统,然后对话系统再与GUS进行交互,并在强化学习下进行优化。在强化学习时,需要对每轮对话设置一个奖励值(reward),并不断朝着奖励值增大的方向优化对话系统。在本文中,奖励值由三部分组成:
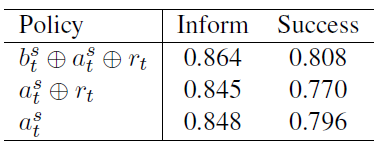
对于每一轮对话,当系统和用户仿真器交互完成后,计算其奖励值,然后使用策略梯度(policy gradient)的方法去优化对话系统,由此得到强化的对话系统。值得注意的是,一般的策略梯度方法优化对话系统时,仅仅优化了其策略模块,而其他模块,包括对话状态跟踪和自然语言生成模块则保持不变。而本文中这三个模块都被整合到了一个端到端的GPT-2模型,使用策略梯度的方法联合优化这三个模块,取得了更好的性能。
本文将GUS与经典的、基于规则的用户仿真器ABUS进行了对比,并通过比较用户仿真器训练出来的强化对话系统的性能,来比较用户仿真器的性能。实验数据集是通用的英文多领域数据集MultiWOZ2.1。为了更全面地评估性能,本文不仅对用户仿真器进行了交叉评估(cross evaluation),同时还对其训练出来的对话系统进行了人工评估。
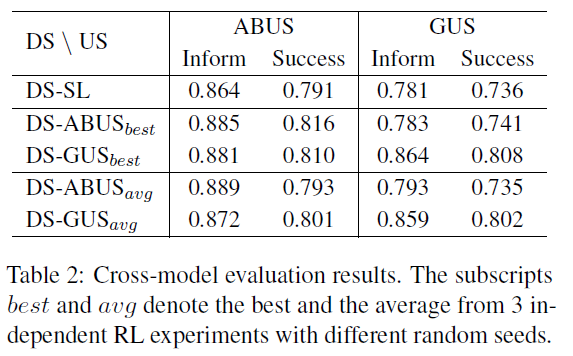
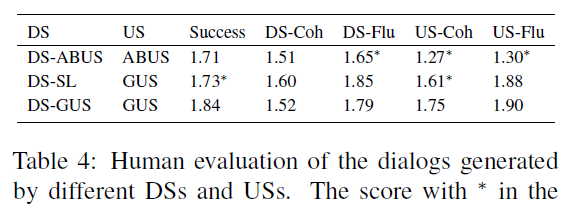
所谓交叉评估,是指将每个对话系统(由不同的用户仿真器训练得到)分别与每个用户仿真器进行交互。一个好的用户仿真器,其训练出来的对话系统应该在与各个用户仿真器的交互中都维持一个较好的表现。对上表的结果逐行比较可以看出,在交叉评估中,DS-GUS(由GUS训练出来的对话系统)无论是同ABUS交互还是同GUS交互,都取得了很好的结果,其表现明显优于由ABUS训练出来的系统DS-ABUS,以及仅经过有监督训练的系统DS-SL。这反映了GUS性能的优越性。在人工评估中,DS-GUS在成功率,逻辑性,流畅性上也取得了不弱于或者优于其他两个系统的性能,这进一步说明了由GUS训练出来的对话系统的强大性能,反映了GUS的优势。除了上述主实验结果外,本文还进行了多种消融实验,包括是否添加对话状态跟踪,奖励值的设置,策略优化模块等。由此验证了前文所述的GUS构建中各设计的合理性。
本文提出了一种以预训练语言模型GPT-2为骨架,结合了用户目标状态跟踪的生成式用户仿真器(GUS),用于多领域任务型对话系统的强化学习。实验结果表明,GUS对于优化对话系统大有裨益,显著优于仅进行有监督学习的基线系统以及由传统用户仿真器ABUS训练出来的对话系统。GUS仍有许多进步的空间,进一步的研究方向,包括但不限于:- 研究策略梯度方法之外的其他强化学习方法来优化对话系统。
GUS的代码已在GitHub上开源,欢迎大家使用!https://github.com/thu-spmi/GUS
 语音小管家