
 语音小管家
在过去的一段时间里,Azure 神经网络文本转语音服务(Neural TTS)已经在声音质量方面取得了快速发展,实现了在句子级别媲美真人的水平(查看详情[1])。但是在实际应用中,语音合成除了单句合成,也经常应用于生成长文本的段落音频,比如朗读网页的长篇幅内容、制作有声书或者视频配音等。
通常,TTS 语音合成是基于单个句子生成长段落音频的。也就是在每个句子合成后,将它们拼接成段落。基于句子级别的语音合成只考虑单个句子的信息,而不考虑该句子之前或之后的内容,即使在长格式上下文中也是如此。无论上下文如何变化,用这种方法生成当前句子的音频听起来都是一样的。众所周知,有声读物或发声朗读的网页内容等场景通常由许多带有上下文的段落组成。听众通常会期望在不同的上下文里合成的语音能够在音高、节奏和语调上有动态的变化,从而让句子间的起承转合更连贯。如果在建模的时候不考虑上下文信息,句子级别的合成语音可能会相对更单调,表现力也不够,以至于降低听众的沉浸感。
在本博客中,我们介绍了一项新的技术创新,该创新引入上下文信息来模拟段落或长篇内容朗读的 TTS 语音。这项新技术使用段落 MOS(平均意见得分)作为指标,显著提高了 AI 语音在合成长音频时的连贯性和表现力。借助这项新技术,我们推出了新声音 Roger 和 Steffan 的公共预览版。Roger 和 Steffan 是美式英语的长文本声音模型,它们可以自动识别上下文,帮助客户生成更具表现力和自然感的长格式语音内容。
Roger 和 Steffan:新的上下文语音模型
在语音合成的过程中,Roger 和 Steffan 能够理解段落内容并且考虑上下文信息。因此,它们可以根据上下文调整音高、节奏和语调等,并在朗读段落时根据需要插入自然停顿。
下面的样例展示了 Roger 和 Steffan 是如何富有表现力地朗读段落的,同时我们提供了几个使用单句模型合成的声音样例作为对比,你可以比较这些样例在句子内部和交叉句子中的停顿、语调、节奏等方面的差异。
脚本1:
A druid was a man of mystery and power, respected by all save the most arrogant churchmen and lords. "Why have we been brought here, druid? " Farrel asked. "No doubt we will learn that in time," Valin said. "But I sense our circle is not yet complete. Look, another joins us." With his short wooden wand he gestured down the hill, to where a maiden was stepping among the fallen stones. She wore a gown of white linen, loose and frayed.
脚本2:
He then gazed at every soldier on that trench giving each of them a nod. "Do and die boys, do and die!" The twenty-eight repeated the chant as the sound of the ghastly GEOMs began to resound. "Do and Die!" their voices drowning the GEOM swarm, taunting the monsters to finish them off.
可以看出,通过整合上下文信息,长文本模型生成的语音在当前句内和句子间的连接处听起来更具表现力和连贯性,而对于有着丰富变化和高表现力的内容,从上下文模型合成的语音会更稳定和自然。
背后的技术
神经网络 TTS 建模引入上下文信息
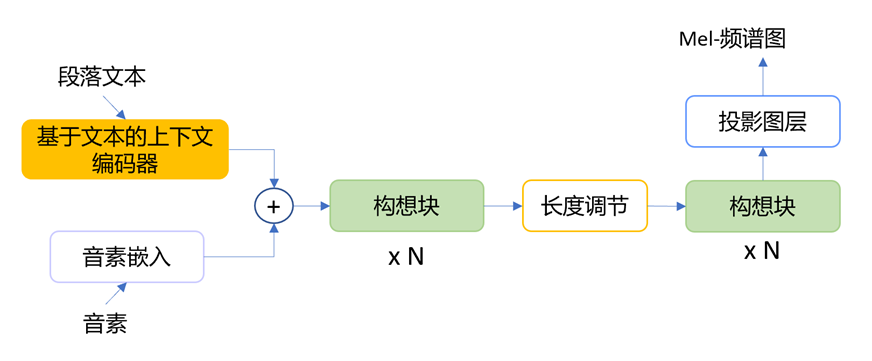
图 1.上下文语音模型的整体体系结构
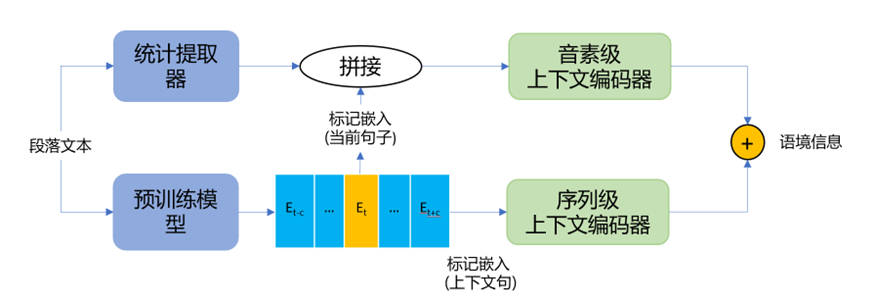
图 2.基于文本的上下文编码器
| 段落 MOS 的指标定义 | |
总体印象 | 考虑到句内和句子间的连接,您对阅读内容的总体印象如何?考虑声音是否清晰、自然、富有表现力、易于理解和令人愉悦。 |
段落 MOS 结果表明,上下文模型将段落 MOS 与真人录音的差距从-0.2(句子级模型)显著减小到 -0.06(上下文模型),段落MOS差距减少约 70%,在段落层面与真人水平非常接近。
以下是来自上下文模型 Roger 的合成语音和真人录音的样例对比,供您参考。
脚本
如何使用
支持上下文的美式英语新声音 Roger 和 Steffan 已经发布到 Azure 神经网络语音合成服务平台。用户可以从语音库[2]找到语音示例和示例代码。非开发人员也可以使用我们的有声内容生成工具[3]直接创建音频内容,而无需编写任何代码。建议在使用 Roger 或者 Steffan 生成音频内容时,提供长格式上下文(例如段落文本,而不是单个句子)作为文本输入。
更多信息
[1]:https://www.microsoft.com/research/blog/azure-ai-milestone-new-neural-text-to-speech-models-more-closely-mirror-natural-speech/
[2]:https://speech.microsoft.com/portal/voicegallery
[3]:https://docs.microsoft.com/en-us/azure/cognitive-services/speech-service/how-to-audio-content-creation
[4]:https://www.youtube.com/watch?v=a9FN11y9qEQ
[5]:https://insider.office.com/blog/new-natural-sounding-voices-come-to-read-aloud
[6]:https://techcommunity.microsoft.com/t5/outlook-blog/play-my-emails-in-outlook-and-get-time-back-in-your-day/ba-p/930243
[7]:https://www.youtube.com/watch?v=m-3-D7S0piw
[8]:https://docs.microsoft.com/azure/cognitive-services/speech-service/language-support?tabs=speechtotext#text-to-speech
[9]:https://speech.microsoft.com/customvoice
