
 语音小管家
130亿参数模型权重公布不久,UC伯克利LMSys org再次发布了70亿参数「小羊驼」。同在今天,Hugging Face也发布了70亿参数模型StackLLaMA。
自从Meta发布「开源版ChatGPT」LLaMA之后,学界可谓是一片狂欢。
先是斯坦福提出了70亿参数Alpaca,紧接着又是UC伯克利联手CMU、斯坦福、UCSD和MBZUAI发布的130亿参数Vicuna,在超过90%的情况下实现了与ChatGPT和Bard相匹敌的能力。
今天,「卷王」UC伯克利LMSys org又发布了70亿参数的Vicuna——
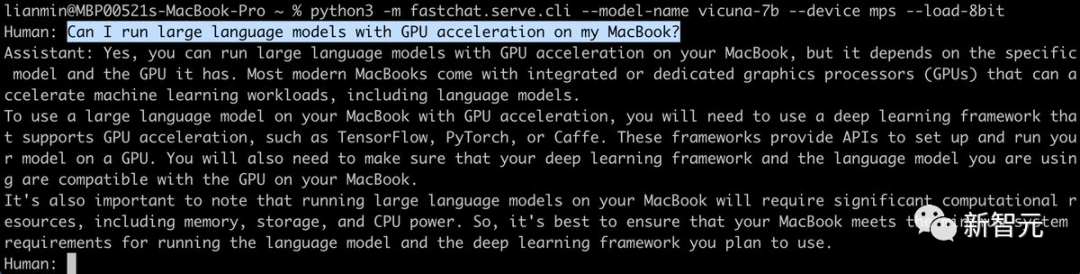
不仅体积小、效率高、能力强,而且只需两行命令就能在M1/M2芯片的Mac上运行,还能开启GPU加速!
恰在今天,Hugging Face的研究人员也发布了一个70亿参数的模型——StackLLaMA。这是一个通过人类反馈强化学习在LLaMA-7B微调而来的模型。
Vicuna-7B:真·单GPU,Mac就能跑
距离模型的发布不到一周,UC伯克利LMSys org便公布了Vicuna-13B的权重。
其中,单GPU运行需要大约28GB的显存,而在仅用CPU的情况下需要大约60GB的内存。
而这次发布的70亿参数版本,则要小巧得多——需求直接砍半。
也就是说,用单个GPU运行Vicuna-7B,只需14GB+显存;而纯CPU运行的话,则只需30GB+内存。
不仅如此,我们还可以通过Metal后端,在配备了苹果自研芯片或者AMD GPU的Mac上启用GPU加速。
我以为的单个GPU:4090 实际上的单个GPU:28GB显存及以上
现在,这个问题也有了新的解决方案——利用8位压缩直接减少一半左右的内存用量,只不过模型的质量会略有下降。
13B模型28GB显存瞬间变14GB;7B模型14GB显存瞬间变7GB,有没有!(但由于activation的缘故,实际占用会比这个高)
对此,LMSys org的研究人员表示,如果遇到内存或显存不够用的情况,可以通过在上述命令中加入--load-8bit来启用8位压缩。
而且,无论是CPU、GPU还是Metal,是7B模型还是13B模型,通通适用。
python3 -m fastchat.serve.cli --model-name /path/to/vicuna/weights --load-8bitStackLLaMA:超全RLHF训练教程
今天,Hugging Face研究人员发布了一篇博客StackLLaMA:用RLHF训练LLaMA的实践指南。
当前大型语言模型ChatGPT、GPT-4和Claude都使用了人类反馈强化学习(RLHF)来微调模型的行为,以产生更符合用户意图的响应。
在此,HF研究者通过以下方式组合使用,训练了LlaMa模型使用RLHF回答Stack Exchange上的所有步骤:
要注意了!
训练StackLLaMA的主要目标是提供一个教程和指南,介绍如何使用RLHF来训练模型,而不是主要关注模型的性能表现。
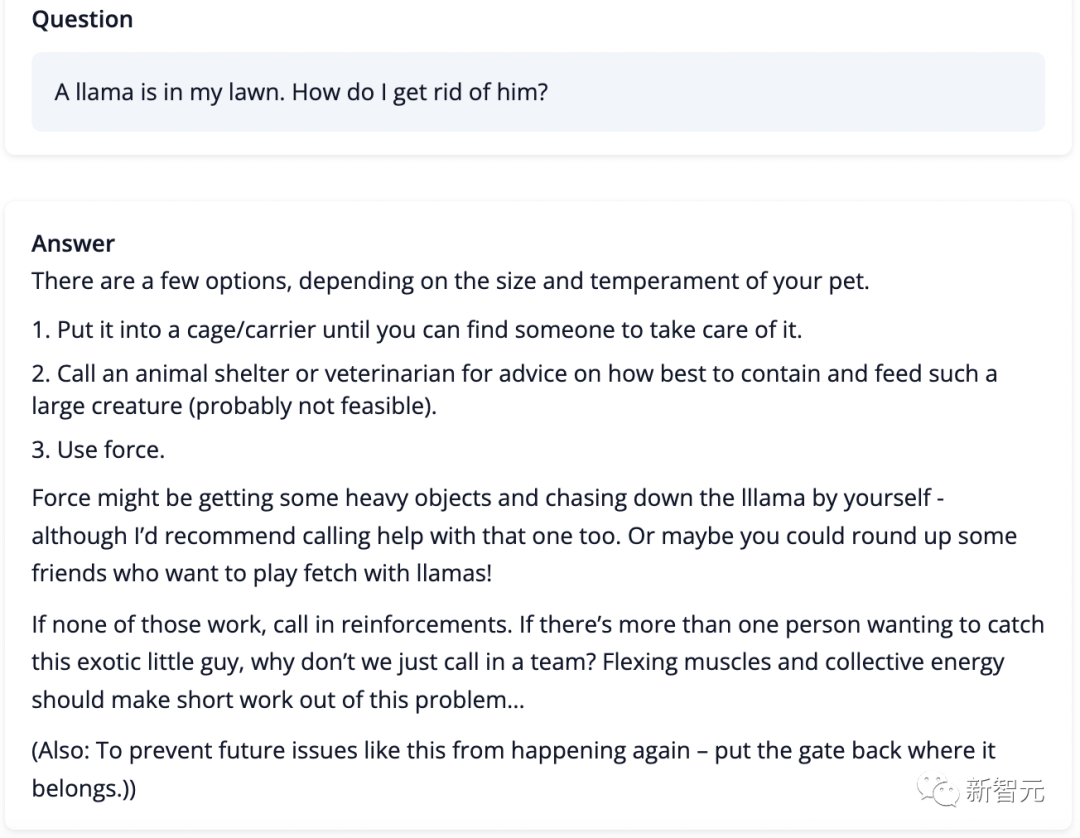
换句话说,该模型在生成答案方面非常滑稽,比如问它「我的花园里有一只骆驼,怎样才能把它赶走?」
StackLLaMA最后给出的一个总括「如果以上方法都不奏效,就要召集增援了。如果有不止一个人想抓住这个奇特的小家伙,为什么不召集一个团队呢?齐心协力,集中力量,这个问题应该很快就解决了」。
当前,Meta开源的LLaMA模型参数大小从7B到65B不等,并且在1T到1.4T的token上进行了训练,是目前开源比较强大的模型。
因此,研究人员使用7B模型作为后续微调的基础。
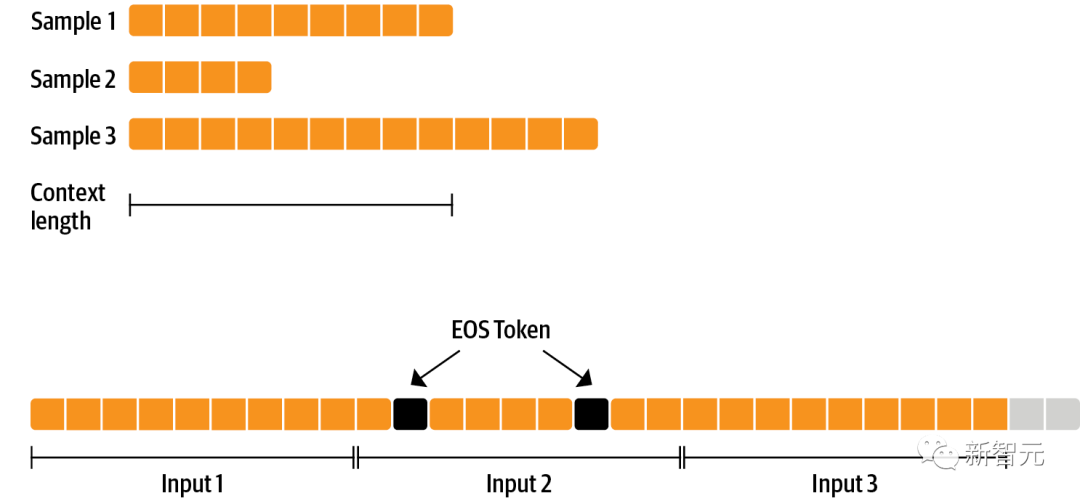
在数据集选用上,研究人员使用了StackExchange数据集,包括所有的问题和答案(还有StackOverflow和其他主题)。
选用该数据集的好处是,答案伴随着点赞数和接受答案的标签一起给出。
研究人员根据A General Language Assistant as a Laboratory for Alignment论文中描述的方法,给每个答案打分:
score = log2 (1 + upvotes) rounded to the nearest integer, plus 1 if the questioner accepted the answer (we assign a score of −1 if the number of upvotes is negative).训练策略
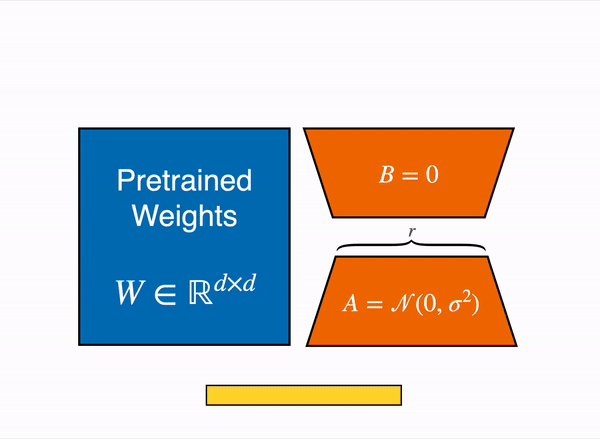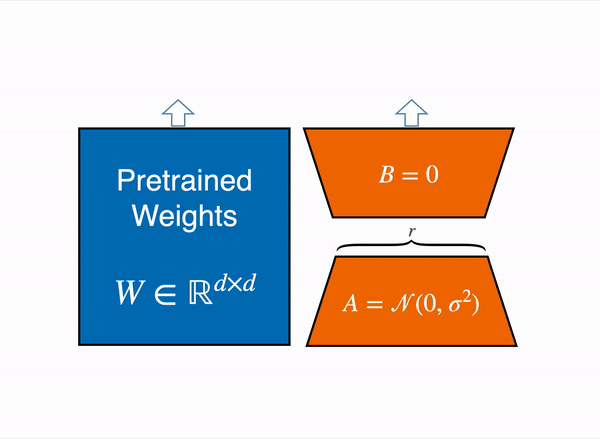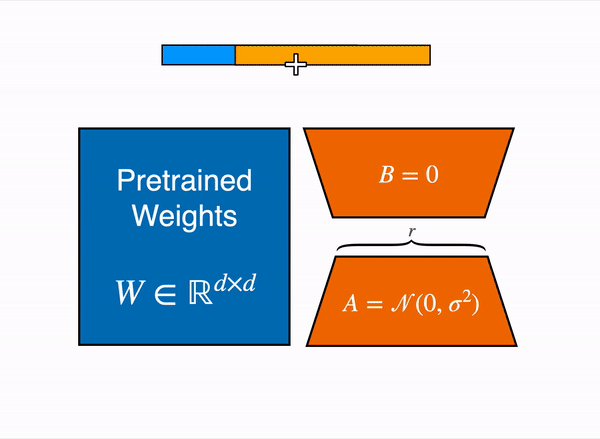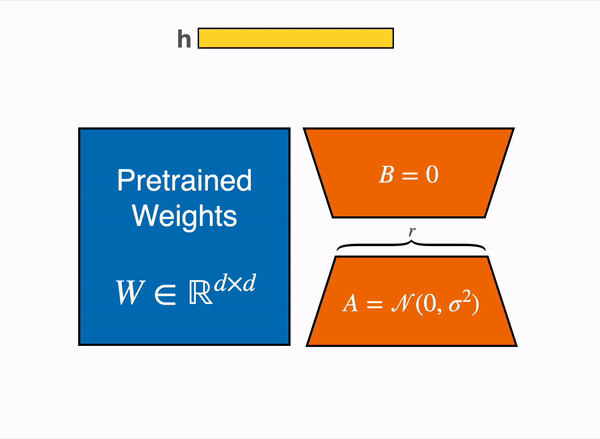
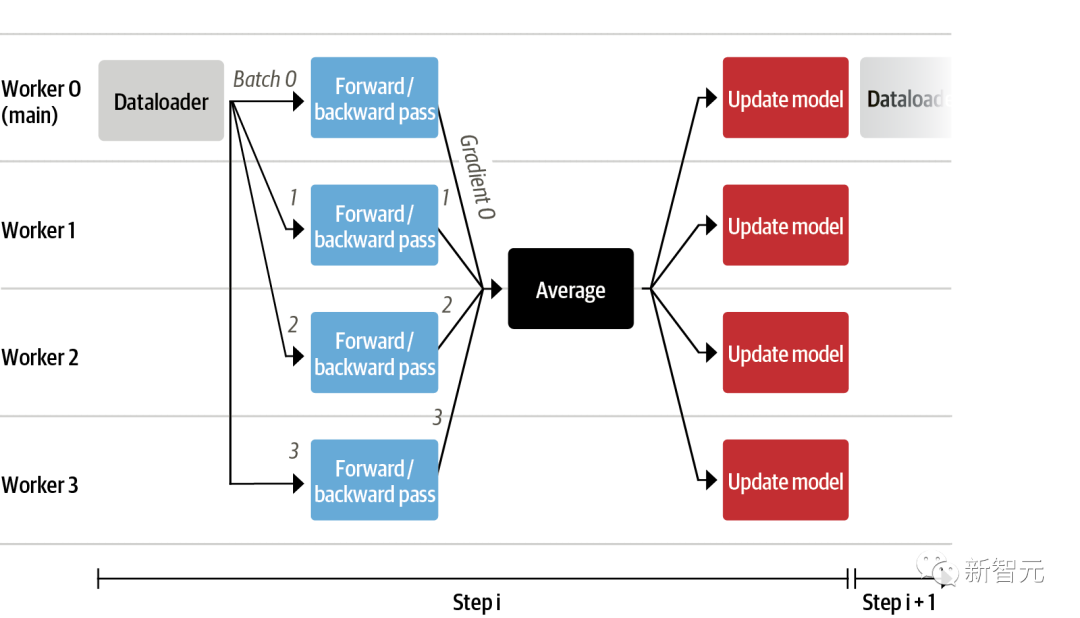
监督微调
奖励建模和人类偏好
 ,并且必须预测哪一个会被人类标注员评价更高。
class RewardTrainer(Trainer):def compute_loss(self, model, inputs, return_outputs=False):
        rewards_j = model(input_ids=inputs["input_ids_j"],  attention_mask=inputs["attention_mask_j"])[0]
        rewards_k = model(input_ids=inputs["input_ids_k"], attention_mask=inputs["attention_mask_k"])[0]
        loss = -nn.functional.logsigmoid(rewards_j - rewards_k).mean()
        if return_outputs:
            return loss, {"rewards_j": rewards_j, "rewards_k": rewards_k}
        return loss
研究人员利用100,000对候选子集,并在50,000对候选的支持集上进行评估。
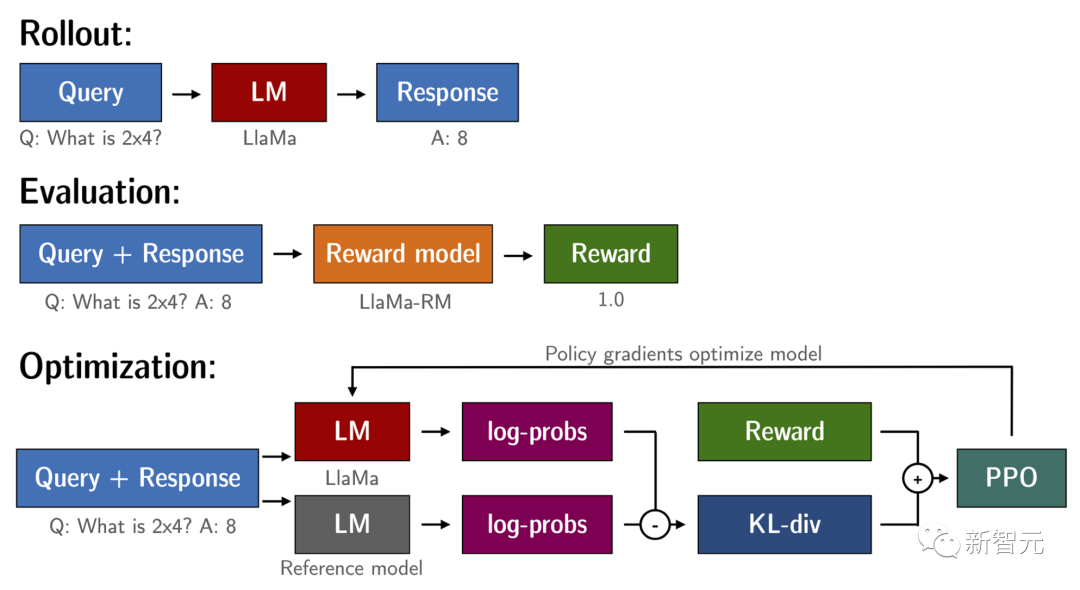
人类反馈强化学习
· 根据提示生成响应
· 根据奖励模型对回答进行评分
· 对评级进行强化学习策略优化
Question:
Answer:
使用RL训练语言模型的一个常见问题是,模型可以通过生成完全胡言乱语来学习利用奖励模型,从而导致奖励模型得到不合实际的奖励。
为了平衡这一点,研究人员在奖励中增加了一个惩罚:保留一个没有训练的模型进行参考,并通过计算 KL散度将新模型的生成与参考模型的生成进行比较。
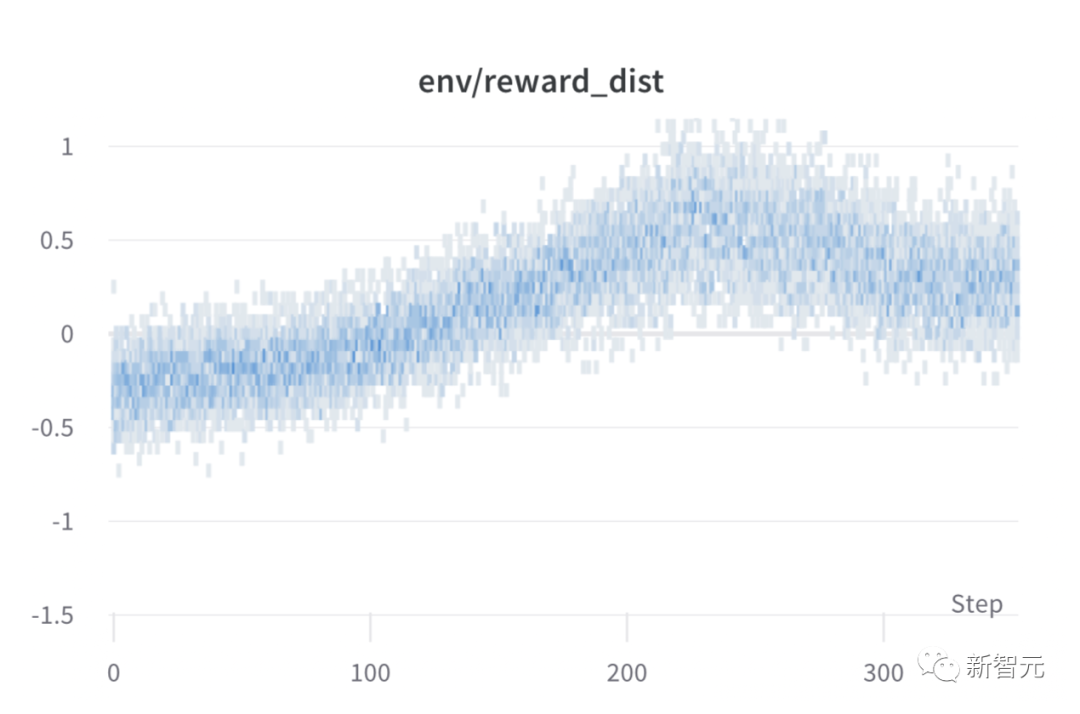
在训练期间对每个步骤进行批次奖励,模型的性能在大约1000个步骤后趋于稳定。
[1] https://twitter.com/lmsysorg/status/1644060638472470528?s=20
[2]https://huggingface.co/blog/stackllama
