语音小管家
缺数据不是问题,直接用GPT-4生成的指令就够了,标注员恐怕要失业了!
「指令」(Instruction)是ChatGPT模型取得突破性进展的关键因素,可以让语言模型的输出更符合「人类的偏好」。
但指令的标注工作需要耗费大量的人力,即便有了开源的语言模型,资金不足的学术机构、小公司也很难训练出自己ChatGPT.
最近微软的研究人员利用之前提出的Self-Instruct技术,首次尝试使用GPT-4模型来自动生成语言模型所需的微调指令数据。
训练数据
训练数据
数据收集
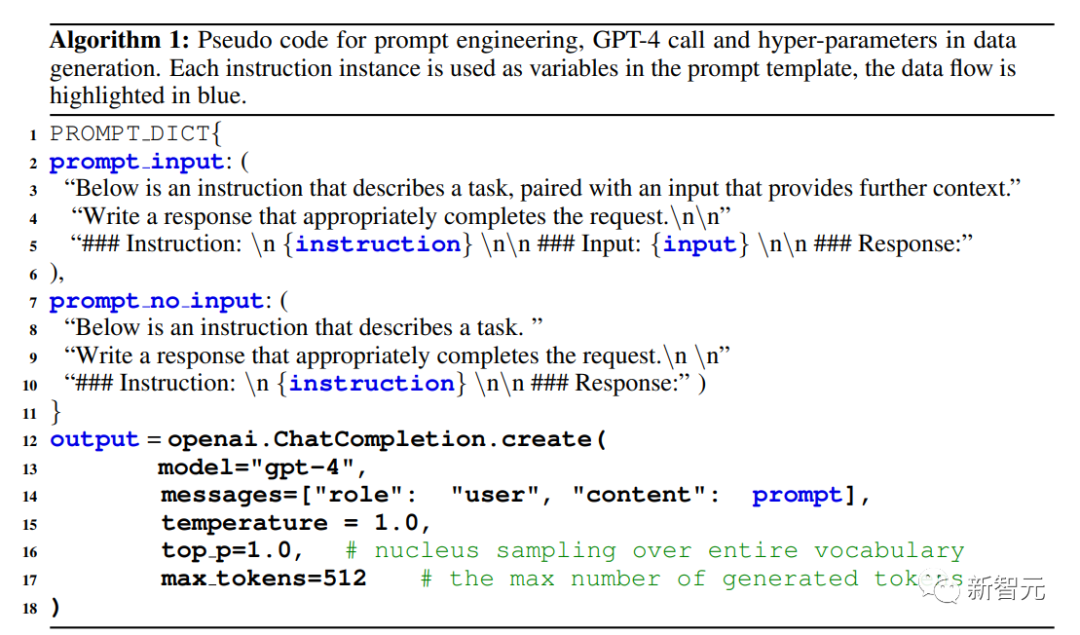
研究人员重用了斯坦福大学发布的Alpaca模型用到的5.2万条指令,其中每条指令都描述了模型应该执行的任务,并遵循与Alpaca相同的prompting策略,同时考虑有输入和无输入的情况,作为任务的可选上下文或输入;使用大型语言模型对指令输出答案。
在Alpaca 数据集中,输出是使用GPT-3.5(text-davinci-003)生成的,但在这篇论文中,研究人员选择使用GPT-4来生成数据,具体包括以下四个数据集:
1. 英文Instruction-Following Data:对于在Alpaca中收集的5.2万条指令,为每一条指令都提供一个英文GPT-4答案。
未来的工作为遵循迭代的过程,使用GPT-4和self-instruct构建一个全新的数据集。
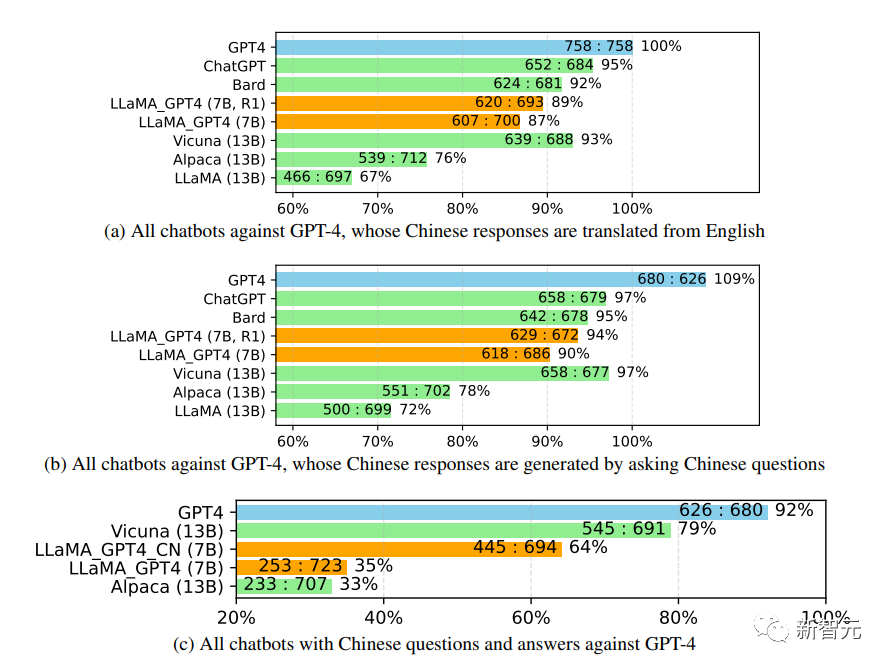
2. 中文Instruction-Following Data:使用ChatGPT将5.2万条指令翻译成中文,并要求GPT-4用中文回答这些指令,并以此建立一个基于LLaMA的中文instruction-following模型,并研究指令调优的跨语言泛化能力。
3. 对比数据(Comparison Data):要求GPT-4对自己的回复提供从1到10的评分,并对GPT-4, GPT-3.5和OPT-IML这三个模型的回复进行评分,以训练奖励模型。
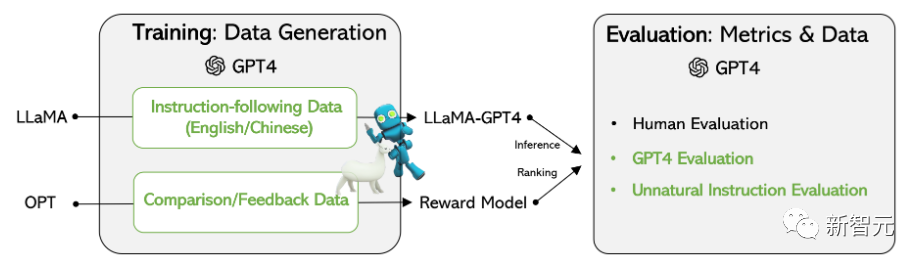
4. 非自然指令的答案:GPT-4的答案是在6.8万条(指令,输入,输出)三元组的数据集上解码的,使用该子集来量化GPT-4和指令调优后的模型在规模上的差距。
数据统计
研究人员对比了GPT-4和GPT-3.5的英语输出回复集合:对于每个输出,都提取了根动词(root verb)和直接宾语名词(direct-object noun),在每个输出集上计算了独特的动词-名词对的频率。
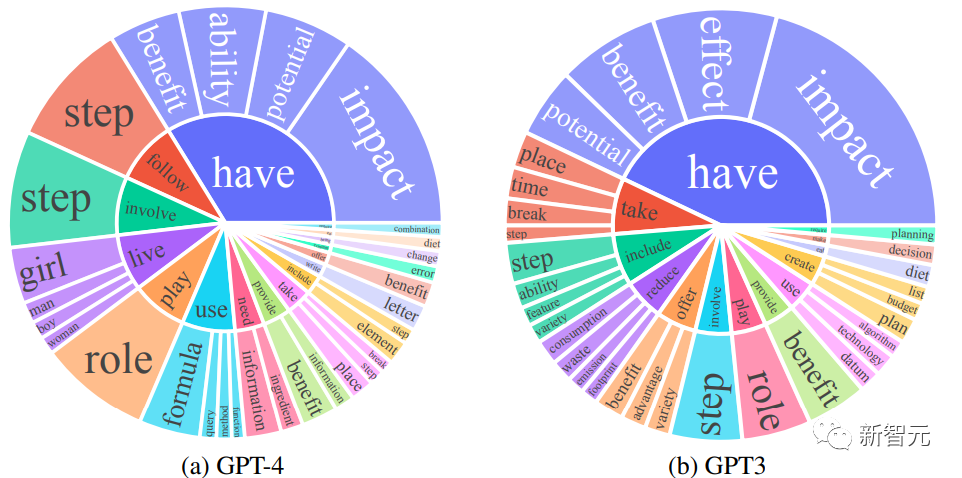
频率高于10的动词-名词对
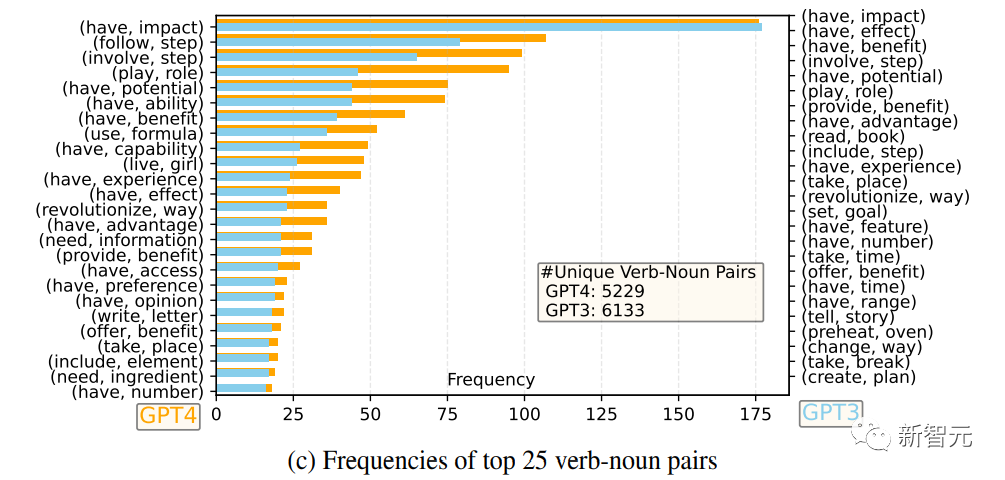
频率最高的25对动词-名词
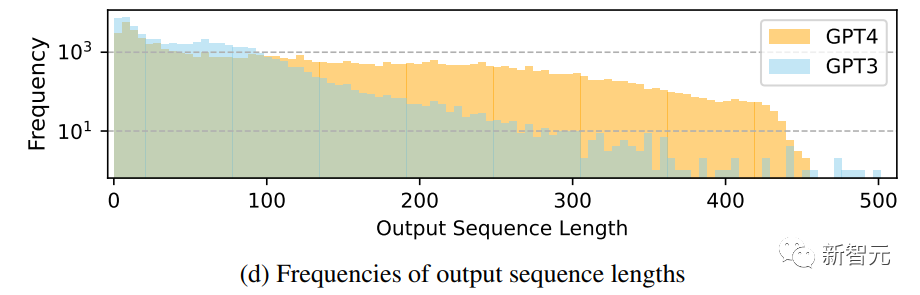
输出序列长度的频率分布对比
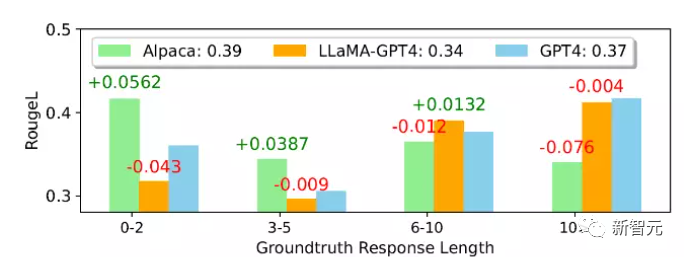
可以看到,GPT-4倾向于生成比GPT-3.5更长的序列,Alpaca中GPT-3.5数据的长尾现象比GPT-4的输出分布更明显,可能是因为Alpaca数据集涉及到一个迭代的数据收集过程,在每次迭代中去除相似的指令实例,在目前的一次性数据生成中是没有的。
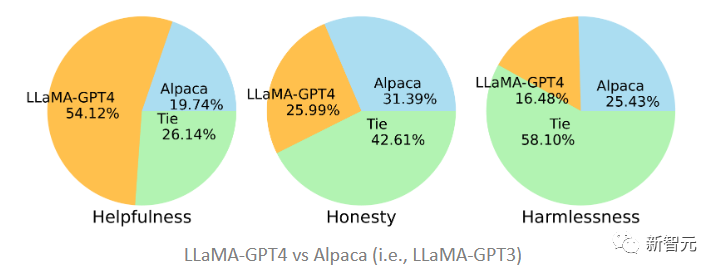
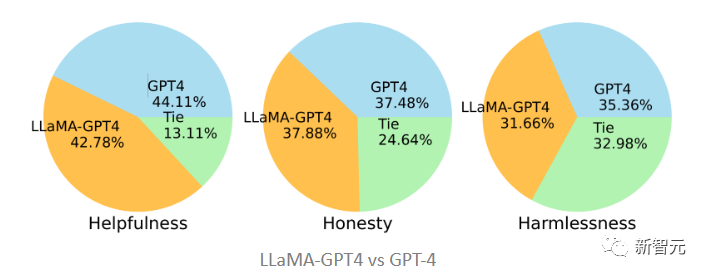
尽管这个过程很简单,但GPT-4生成的instruction-following数据表现出更强大的对齐性能。
指令调优语言模型
指令调优语言模型
Self-Instruct 调优
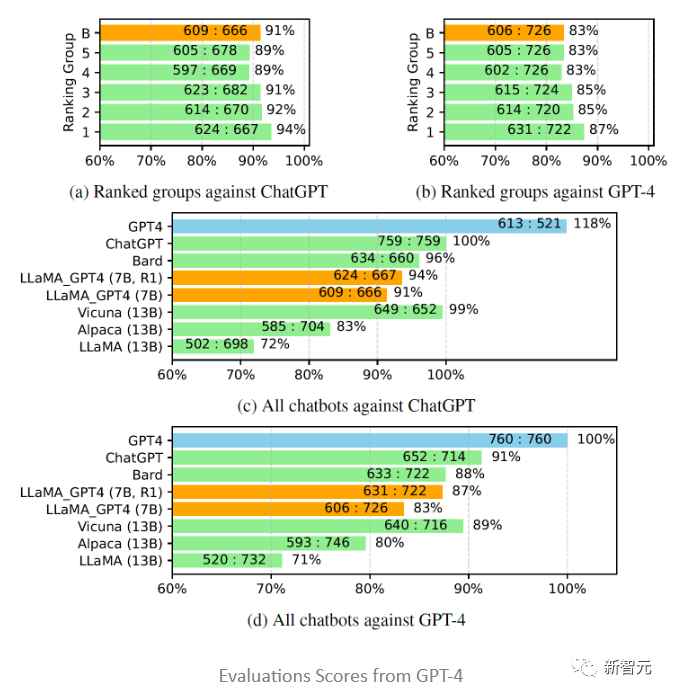
研究人员基于LLaMA 7B checkpoint有监督微调后训练得到了两个模型:LLaMA-GPT4是在GPT-4生成的5.2万条英文instruction-following数据上训练的;LLaMA-GPT4-CN是在GPT-4的5.2万条中文instruction-following数据上训练的。
两个模型被用来研究GPT-4的数据质量以及在一种语言中进行指令调优的LLMs时的跨语言泛化特性。
奖励模型
从人类反馈中进行强化学习(Reinforcement Learning from Human Feedback,RLHF)旨在使LLM行为与人类的偏好相一致,以使语言模型的输出对人类更加有用。
RLHF的一个关键组成部分是奖励建模,其问题可以被表述为一个回归任务,以预测给定提示和回复的奖励评分,该方法通常需要大规模的比较数据,即对同一提示的两个模型反应进行比较。
现有的开源模型,如Alpaca、Vicuna和Dolly,由于标注对比数据的成本很高,所以没有用到RLHF,并且最近的研究表明,GPT-4能够识别和修复自己的错误,并准确判断回复的质量。
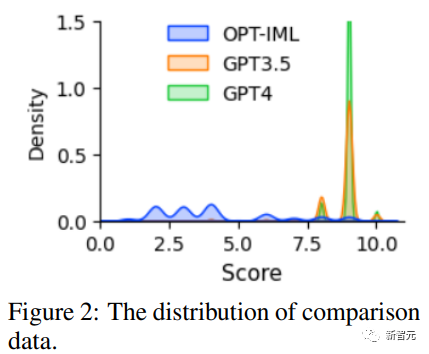
为了促进对RLHF的研究,研究人员使用GPT-4创建了对比数据;为了评估数据质量,研究人员训练一个基于OPT 1.3B的奖励模型,以对不同的回复进行评分:对一个提示和K个回复,GPT-4为每个回复提供一个1到10之间的评分。
实验结果
实验结果