
 语音小管家
文章来源于AINLPer,作者ShuYini
引言
说在前面
「部署环境」:CUDA Version 11.0,机器内存32G以上或者机器8G内存+8G显卡内存。
1、安装Miniconda
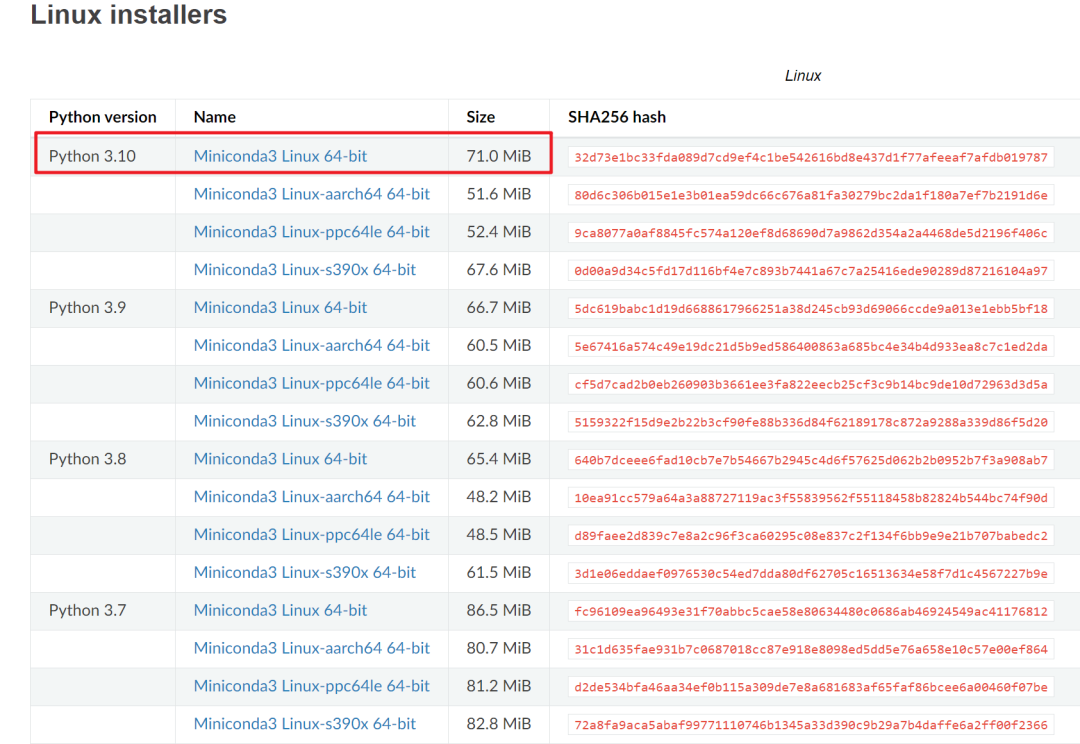
1.1 获取安装包
下载地址:https://docs.conda.io/en/latest/miniconda.html#linux-installers
具体截图如下。(如果不想自己麻烦,我也已经把它放到云盘里面了)。
1.2 安装 Miniconda
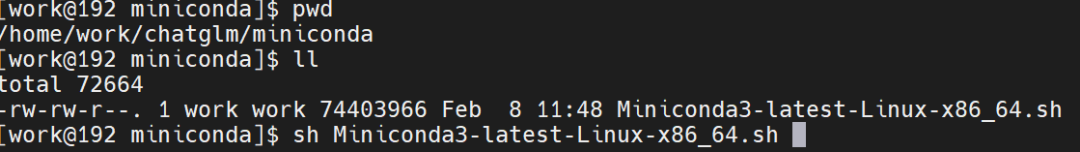
执行完之后按照提示进行回车(enter)就好了,注意:最后选择“yes”,这样每次启动,它都会自动给你切换到conda的base环境中。
1.3 创建虚拟机环境
miniconda支持创建多个虚拟环境,用来支撑不同版本(python)版本的代码,这里就为chatglm-6b创建一个单独的python虚拟机环境,名字叫:chatglm,后面会在该环境中安装跑chatglm-6b模型的所有依赖。下面是命令及截图:
conda create -n chatglm --clone base  (注:因为是离线安装这里选择clone的方式创建,直接创建会报错)
conda env list (获取环境列表)
conda activate chatglm (切换chatglm环境)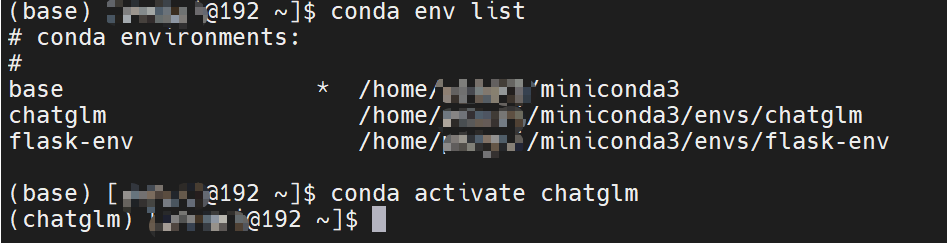
2、安装模型需要的所有依赖
chatglm-6b在centos上用到的所有依赖全都打包在packages里面了(在云盘中,获取方式放在最后),将其也放到/home/work/chatglm/packages下面,然后执行:
pip install --no-index --find-links=/home/work/chatglm/packages -r requirements.txt3、获取模型文件
「方法一」直接拉到文章最后(获取方式放在最后)。
链接地址:https://huggingface.co/THUDM/chatglm-6b/tree/main
不管通过以上哪种方法:将模型文件放到机器目录:/home/work/chatglm/chatglm_model下面。
4、获取项目webui
5、启动webui(最后一步)
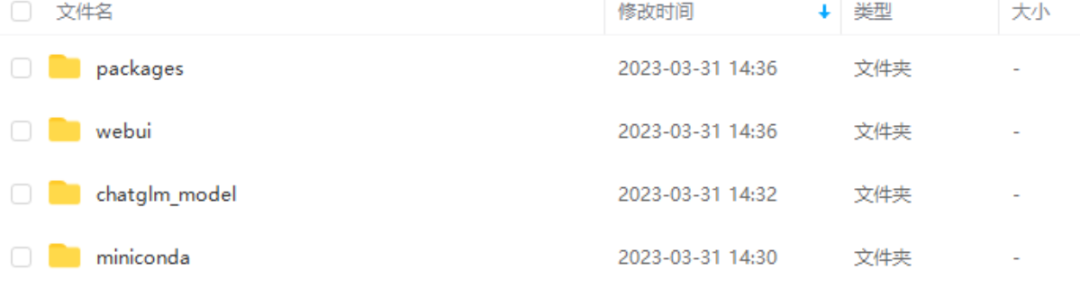
按照上面的操作,最终的文件夹目录如下:
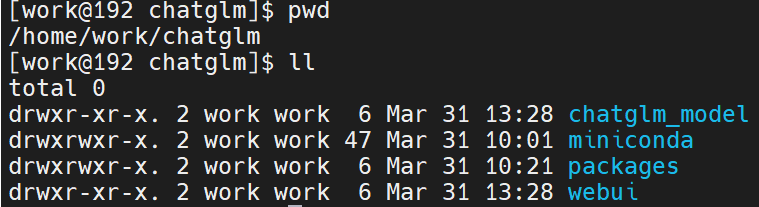
接着,进入到webui文件夹里面,执行如下命令:
python webui.py --model-path /home/work/chatglm/chatglm_model --listen --port 8898 --precision fp16上面参数主要是:模型路径、监听端口、以及模型工作模式;除此之外还有其它的几个参数没有用到。所有参数解释具体如下:
--model-path指定模型路径
--listen如果不加该参数,只能通过127.0.0.0本地访问。注意:在centos服务器上部署,该参数一定要加,不然没有办法通过IP加端口访问模型服务。
--port没有啥好说的,指定端口用的。
--share通过gradio进行分享,它会帮你生成一个域名链接,但是需要访问互联网。离线centos服务器部署用不到。
--precision精度参数有4个,分别是fp32(只用CPU,32G内存以上), fp16,(12G以上显存) int4(8G以下显存使用), int8(8G显存使用)
--cpu只应用CPU,无显卡的时候使用
语音之家公众号后台回复:chatglm6B
