语音小管家
文章来源于DataLearner,作者DataLearner
HuggingFace简介:https://www.datalearner.com/blog/1051636550099750
而HuggingFace上提供的流行的模型也是大家应当关注的内容。本文简单介绍一下2023年4月初的七天(当然包括3月底几天)的最流行的9个模型(为什么9个,因为我发现第10个是一个数据集!服了!)。让大家看看地球人都在关注和使用什么模型。
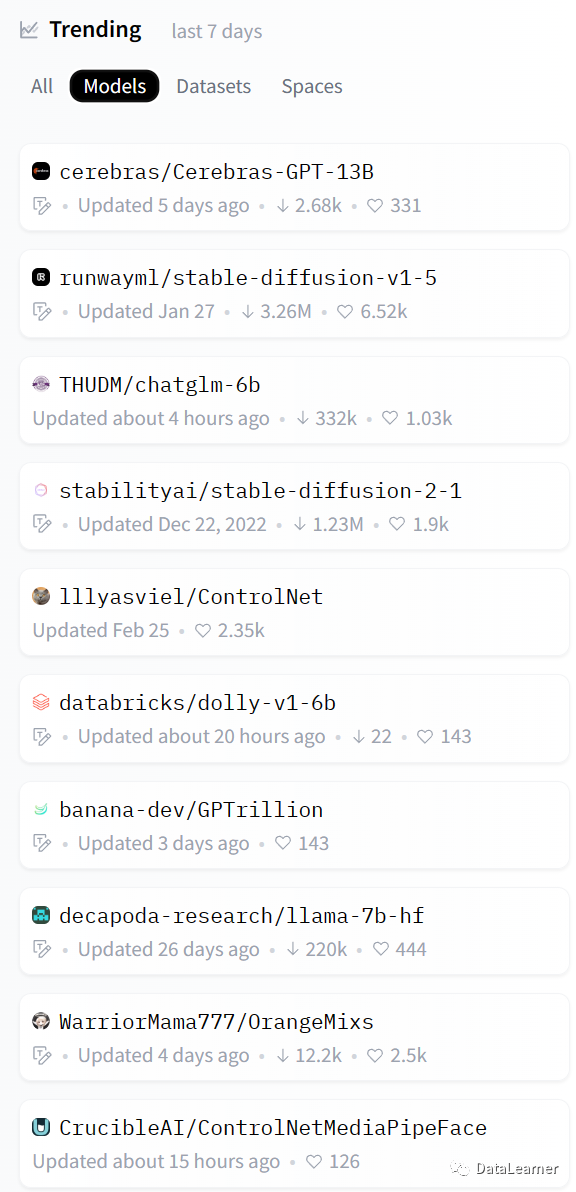
上图就是过去七天最流行的模型,我们分别简单介绍一下。
Cerebras-GPT-13B
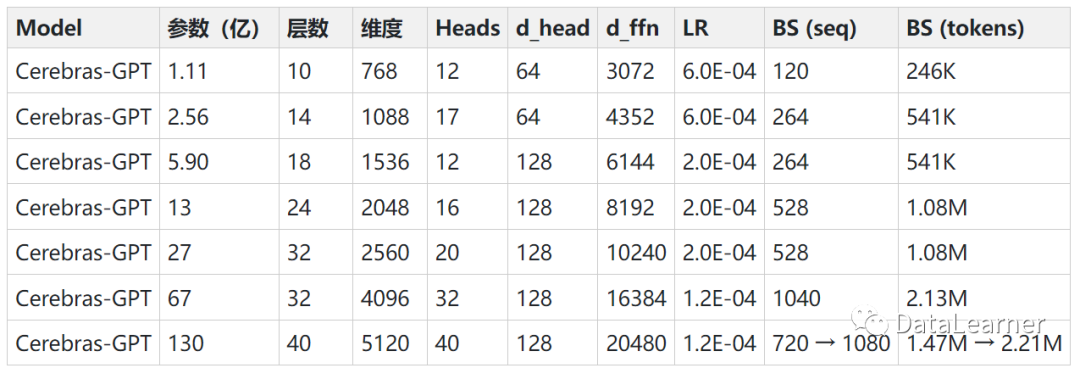
而排行榜第一的13B是其中最大的模型。过去七天它获得了2.68K的关注,当之无愧的第一名。
stable-diffusion-v1-5
著名的开源的Text-to-Image模型,是DALL·E2和Midjourney的免费替代品。Stable-Diffusion-v1-5的checkpoints使用Stable-Diffusion-v1-2的权重进行了初始化,随后在“laion-aesthetics v2 5+”上以512x512的分辨率进行了595k步的微调,并且降低了10%的文本调节来改善无分类器的引导采样。
尽管StableDiffusion2.1已经发布(Stable Diffusion2.0版本模型卡信息:
https://www.datalearner.com/ai-models/pretrained-models/stable-diffusion-2),这个1.5模型这么火热真没有想到(真实原因大概是1.5之后的版本在NSFW方面做了限制)。
清华大学的ChatGLM-6B
ChatGLM-6B模型卡信息:https://www.datalearner.com/ai-models/pretrained-models/ChatGLM-6B
stable-diffusion-v2-1
不多说了,Stable Diffusion的2.1版本。基于SD2.0版本做的进一步训练。于2022年12月7日发布。本次排行第四!
controlnet
ontrolNet是一种新的神将网络结构,由斯坦福大学的Lvmin Zhang和Maneesh Agrawala提出的可以用来增强扩散模型的方法。主要是基于已有的Text-to-Image预训练模型对特定数据进行微调以更加适合使用者的目的。这个结构最大的特点是可以在比较资源少的设备如个人PC上对大模型进行调整以获得更好的效果。
dolly-v1-6b
dolly-v1-6b是由Databricks创建的一个60亿参数的因果语言模型,它源自EleutherAI的GPT-J(于2021年6月发布),并在一个约为52,000个记录的指令语料库(Stanford Alpaca)(CC-NC-BY-4.0)上进行了微调,其中包括使用Self-Instruct论文中概述的技术生成的问答对。Dolly的原始版本是使用deepspeed ZeRO 3在Databricks机器学习平台上训练的,仅使用一台NDasrA100_v4机器和8个A100 40GB GPU,只需30分钟(1个epoch)即可完成。
Dolly的模型卡信息:https://www.datalearner.com/ai-models/pretrained-models/Dolly
GPTrillion
—-更正:GPTrillion是愚人节玩笑节目,里面的项目已经被删除!
llama-7b-hf
LLaMA模型卡信息:https://www.datalearner.com/ai-models/pretrained-models/LLaMA
OrangeMixs
这是一个宅男神器,是基于StableDiffusion做的生成美少女插画的模型集合。