 机器之心
从此,大模型可以在任何设备上编译运行。
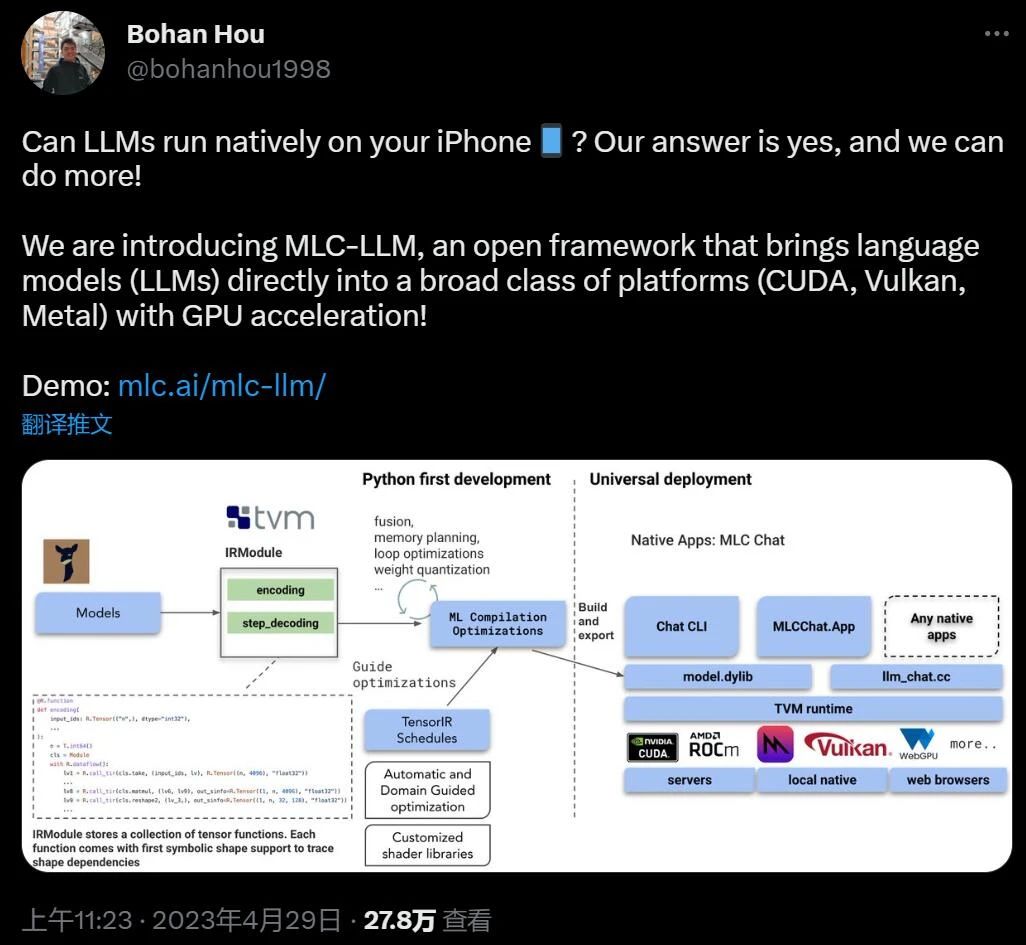
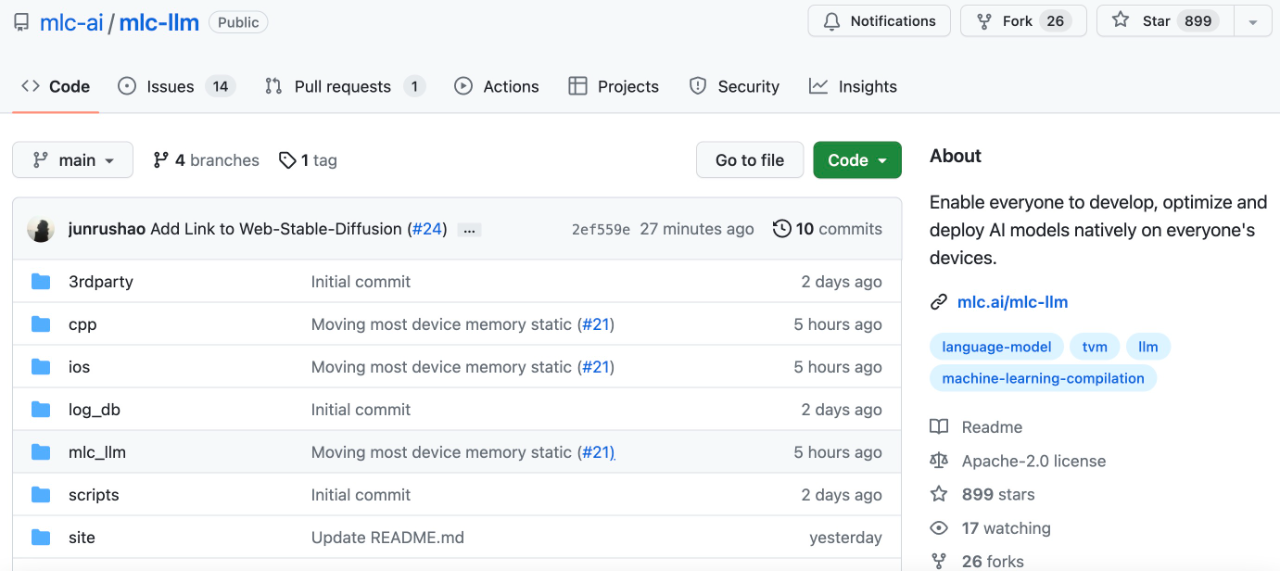
项目地址:https://github.com/mlc-ai/mlc-llm Demo:https://mlc.ai/mlc-llm/
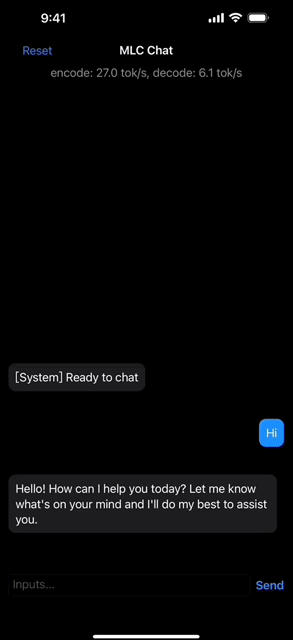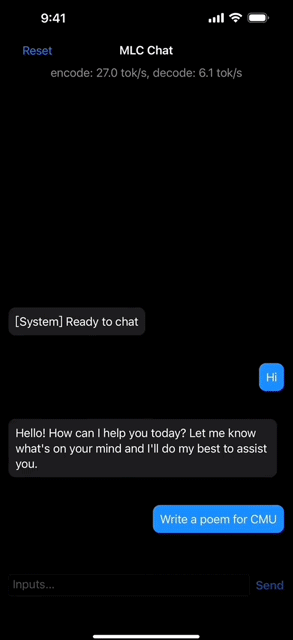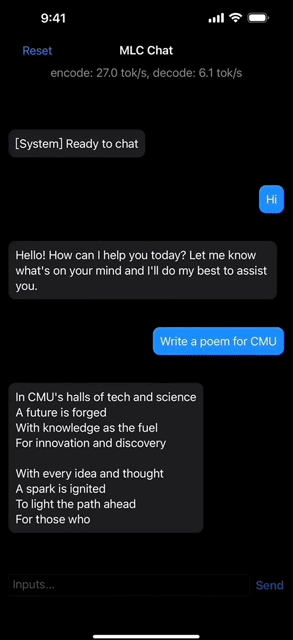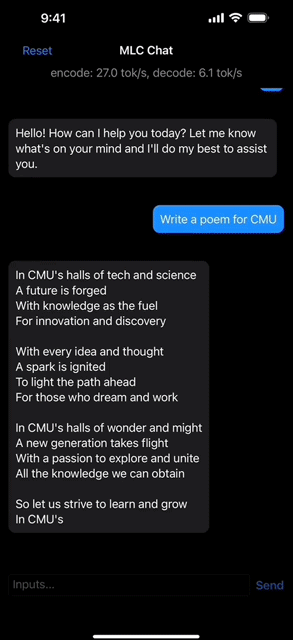
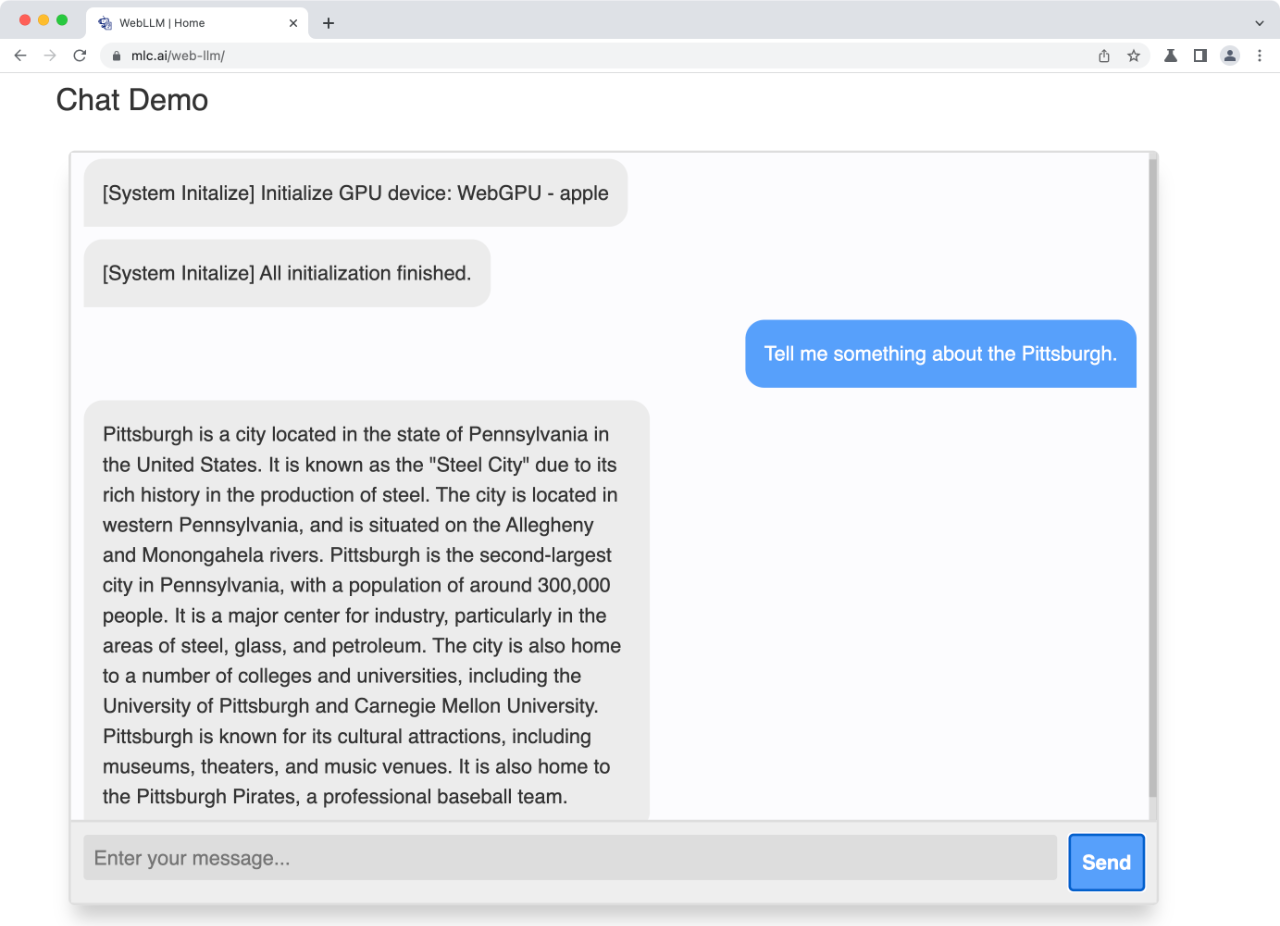
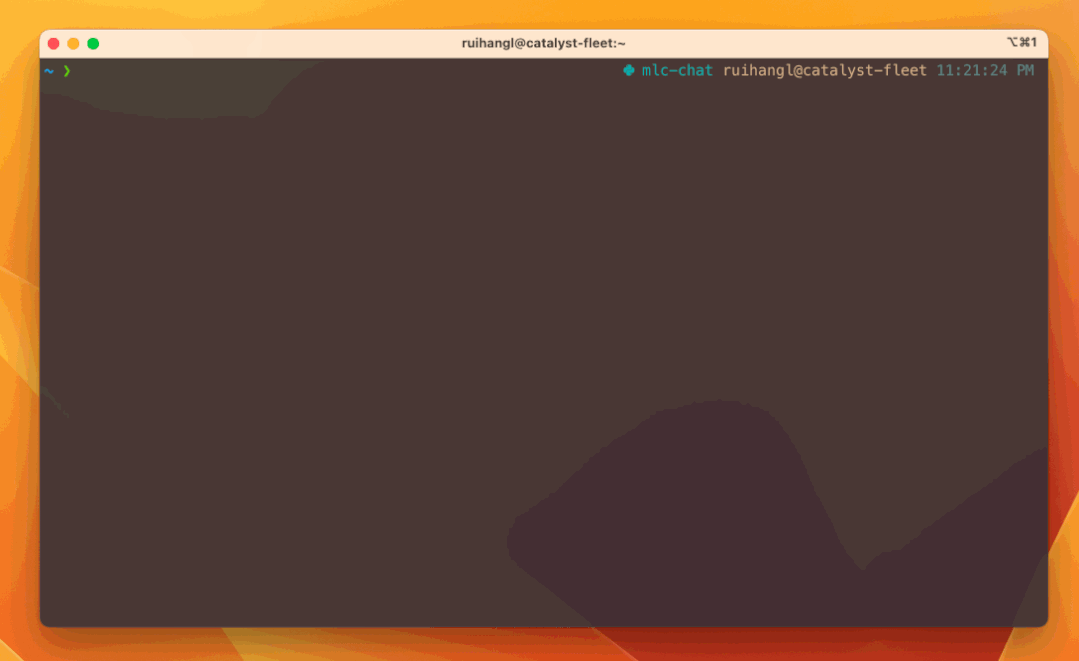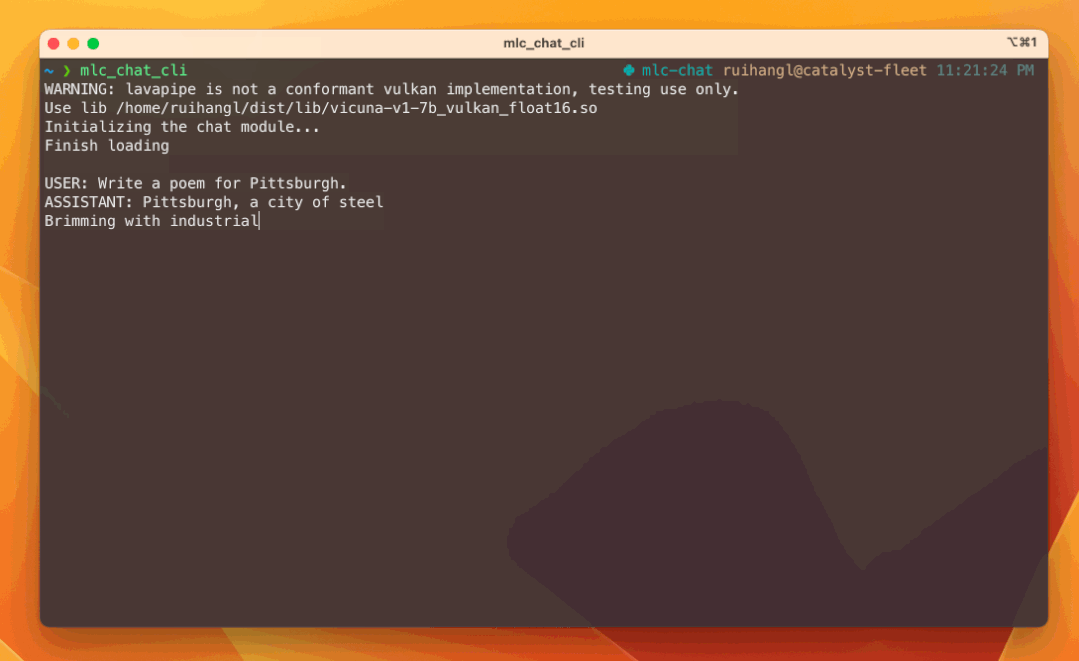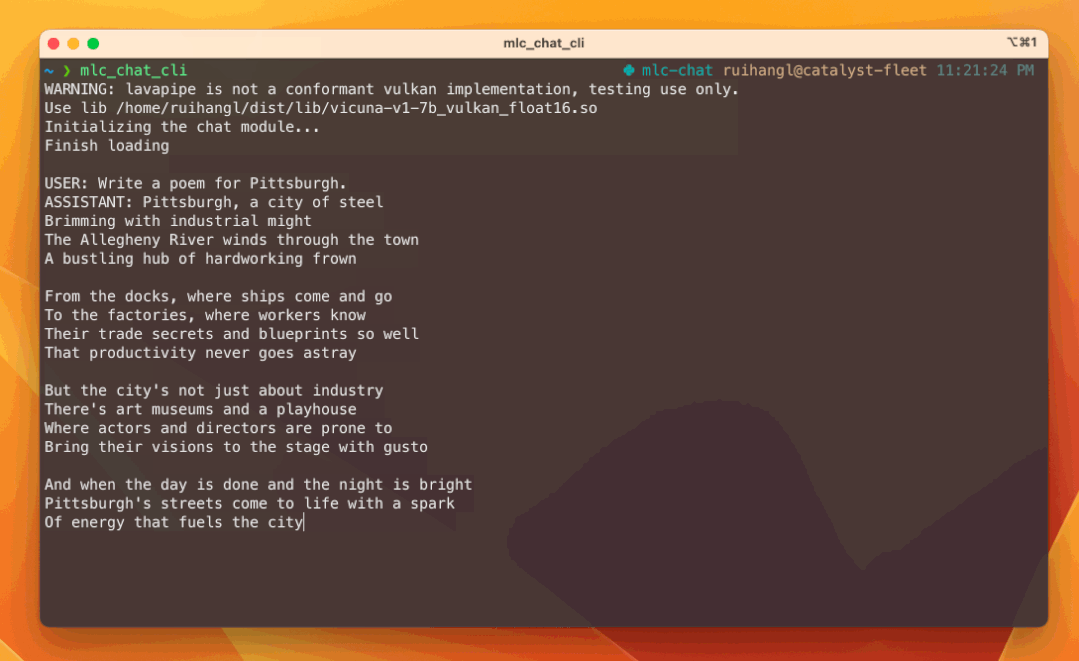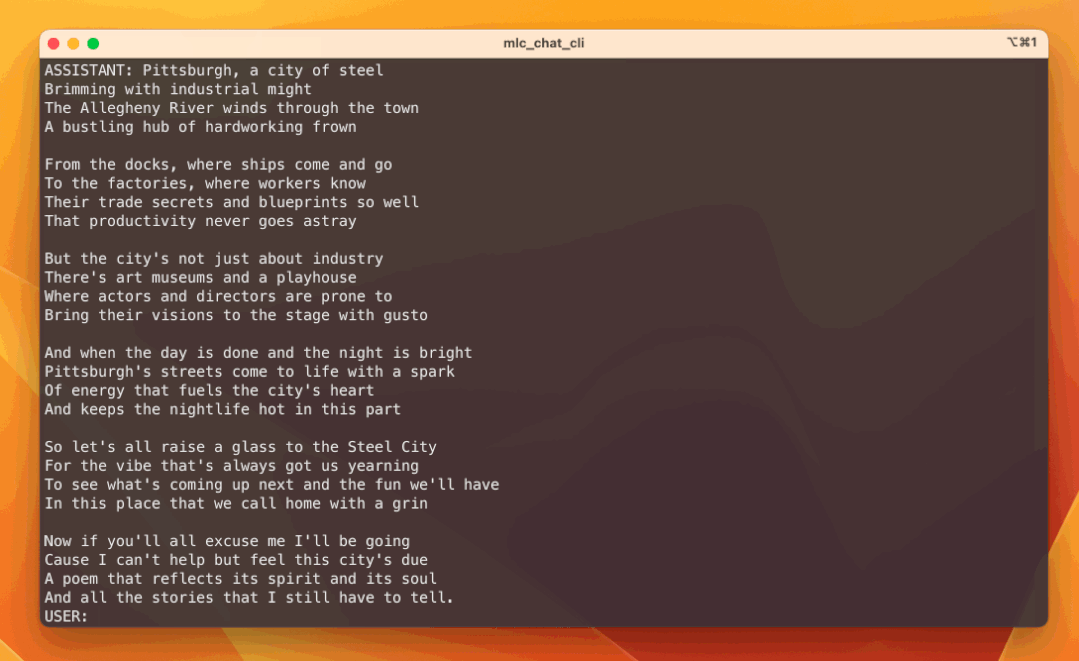
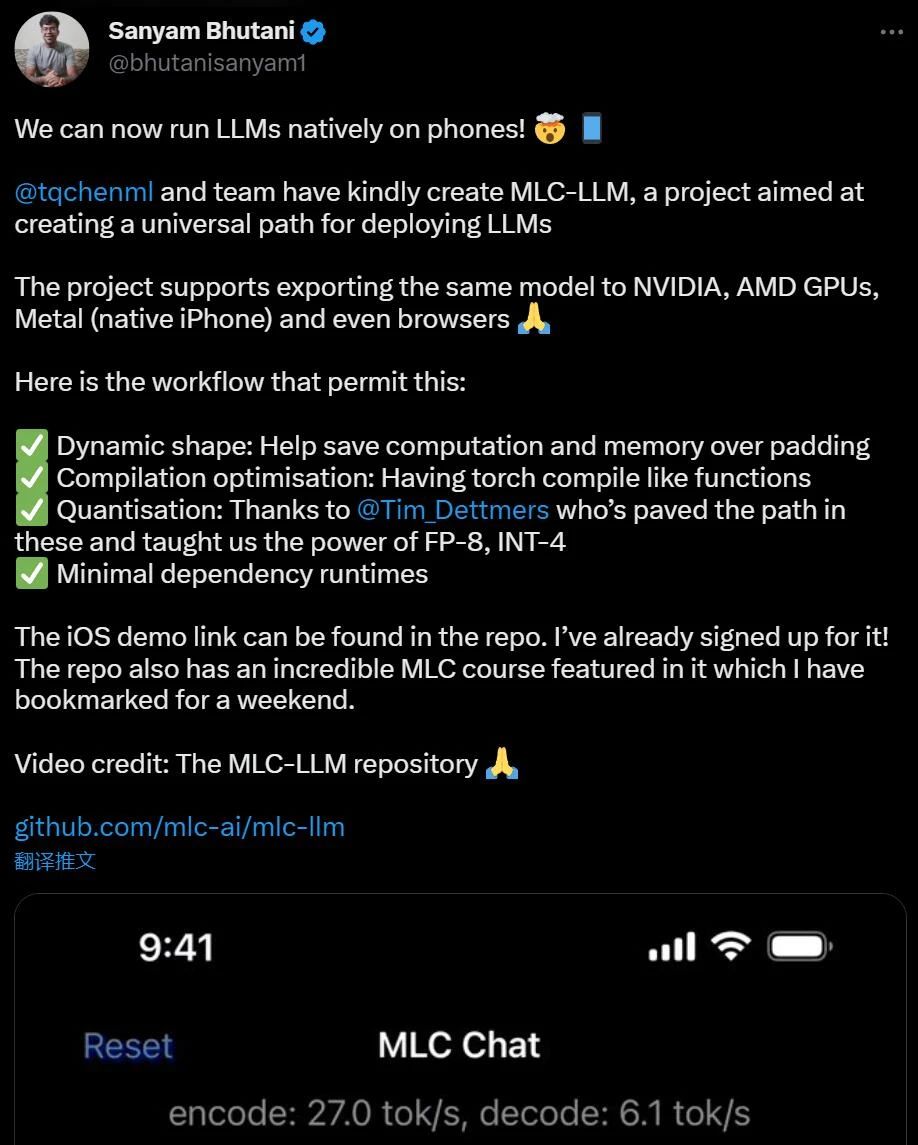
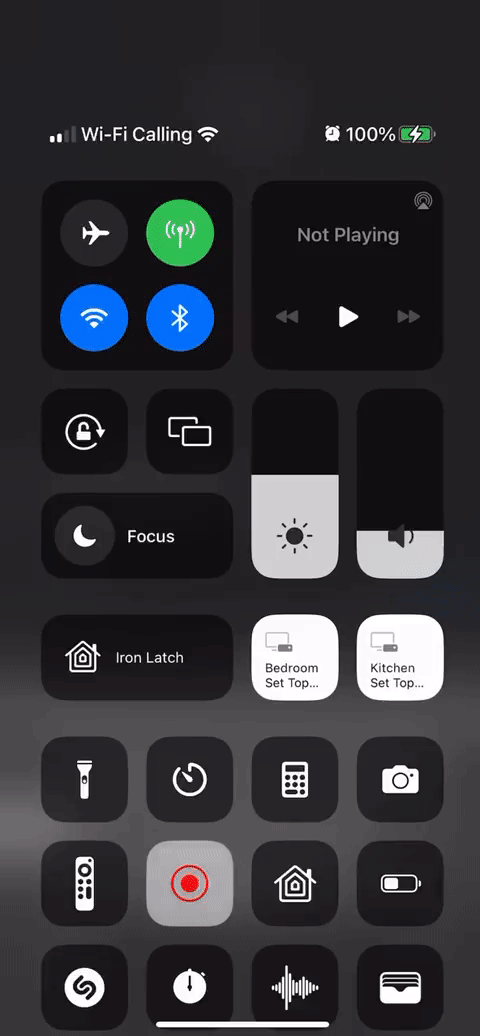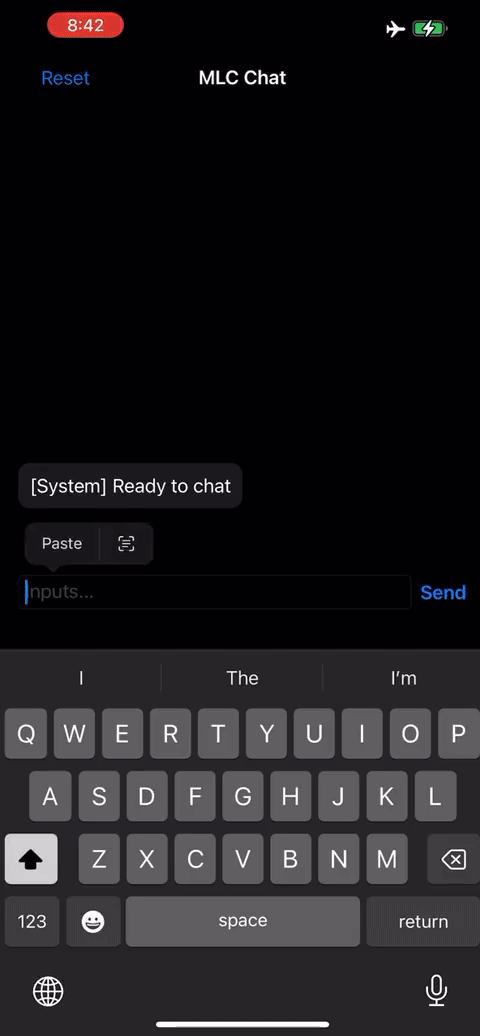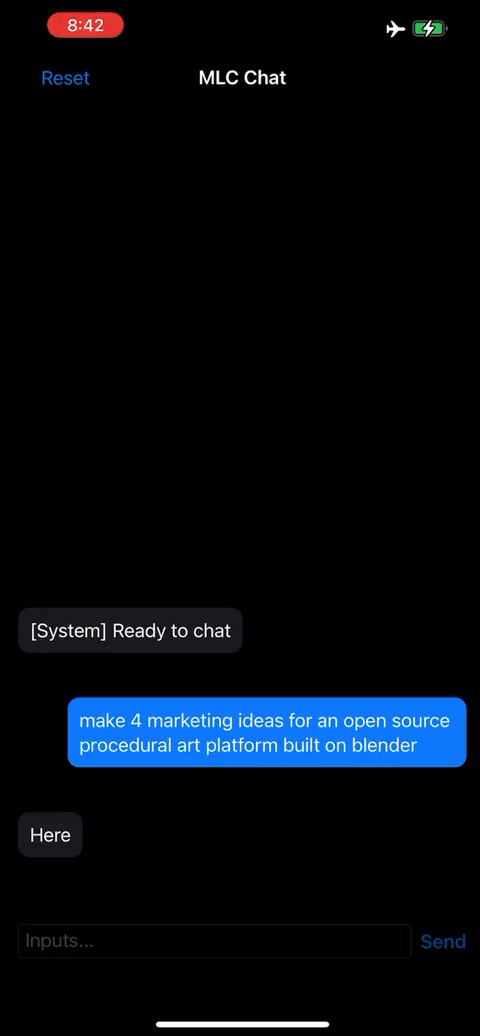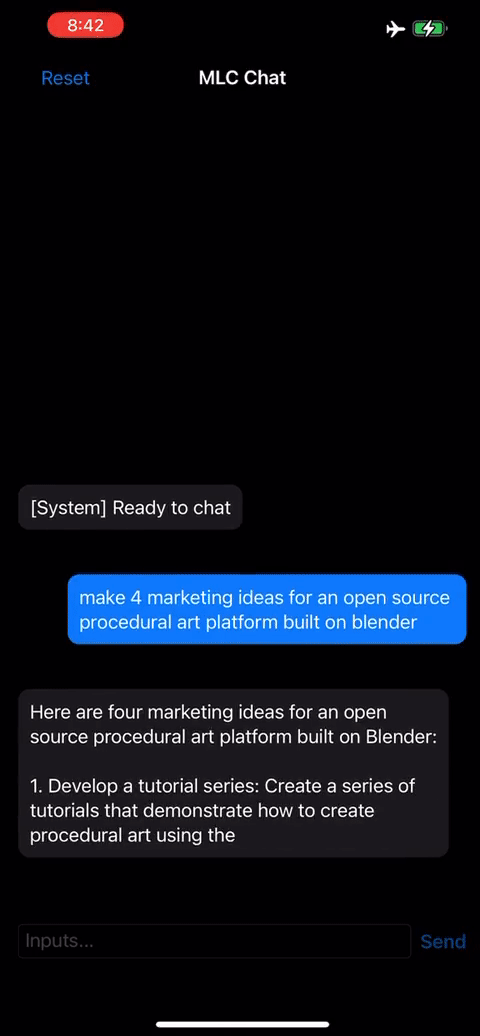
iPhone Metal GPU 和英特尔 / ARM MacBook; 在 Windows 和 Linux 上支持通过 Vulkan 使用 AMD 和 NVIDIA GPU; 在 Windows 和 Linux 上 通过 CUDA 使用 NVIDIA GPU; 浏览器上的 WebGPU(借助 MLC LLM 的配套项目 Web LLM)。
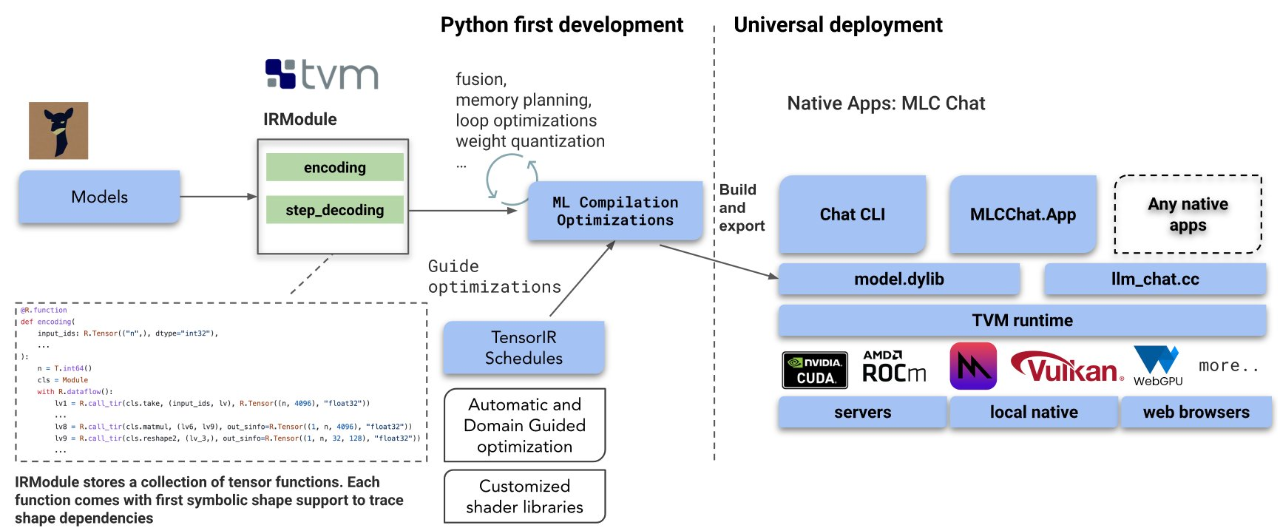
支持不同型号的 CPU、GPU 以及其他可能的协处理器和加速器; 部署在用户设备的本地环境中,这些环境可能没有 python 或其他可用的必要依赖项; 通过仔细规划分配和积极压缩模型参数来解决内存限制。 MLC LLM 提供可重复、系统化和可定制的工作流,使开发人员和 AI 系统研究人员能够以 Python 优先的方法实现模型并进行优化。MLC LLM 可以让研究人员们快速试验新模型、新想法和新的编译器 pass,并进行本地部署。
Dynamic shape:该研究将语言模型烘焙(bake)为具有原生 Dynamic shape 支持的 TVM IRModule,避免了对最大输入长度进行额外填充的需要,并减少了计算量和内存使用量。 可组合的 ML 编译优化:MLC LLM 可以执行许多模型部署优化,例如更好的编译代码转换、融合、内存规划和库卸载(library offloading),并且手动代码优化可以很容易地合并为 TVM 的 IRModule 转换,成为一个 Python API。 量化:MLC LLM 利用低位量化来压缩模型权重,并利用 TVM 的 loop-level TensorIR 为不同的压缩编码方案快速定制代码生成。 运行时(Runtime):TVM 编译生成的库能够通过 TVM runtime 在设备的原生环境中运行,TVM runtime 支持 CUDA/Vulkan/Metal 等主流 GPU 驱动以及 C、JavaScript 等语言的绑定。