
 语音小管家
本文介绍清华大学语音与音频技术实验室(SATLab) ICASSP 2023录用论文Cross-Lingual Alzheimer's Disease Detection Based on Paralinguistic and Pre-Trained Features。这篇文章研究基于自发语言的跨语言阿尔兹海默症(AD)检测,探索何种音频特征具有跨语言AD检测能力。在ICASSP-SPGC-2023 ADReSS-M挑战赛的测试结果表明,副语言特征对于跨语言AD检测较为有效。论文全文见文末链接。
01 跨语言阿尔兹海默症检测
阿尔兹海默症俗称老年痴呆症,是一种神经退行性疾病。截至2010年全世界痴呆症患者总数为3560 万人,到2050年预计将达到1.154亿,其中约60%-70%为阿尔兹海默病患者。
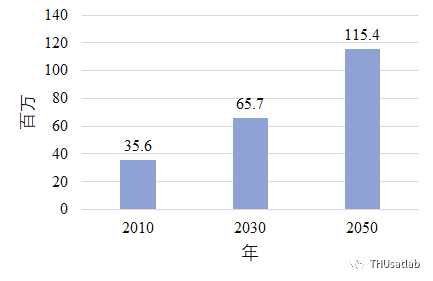
世界痴呆症患者人数
02 解决方法
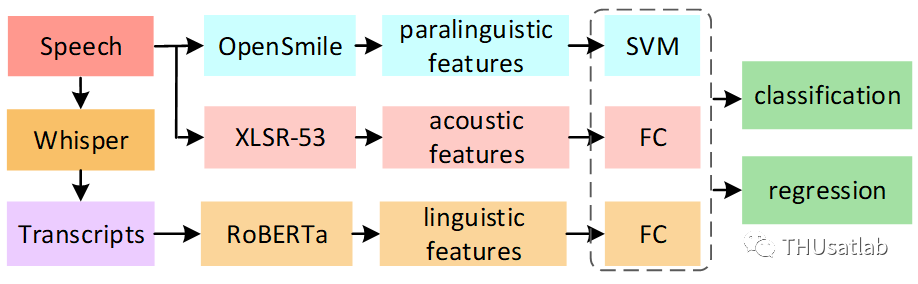
系统总体流程图
首先是副语言特征,我们使用openSmile开源工具提取了IS10-compat、IS10、IS11-ss三个副语言特征集,并用SVM模型进行分类与回归。
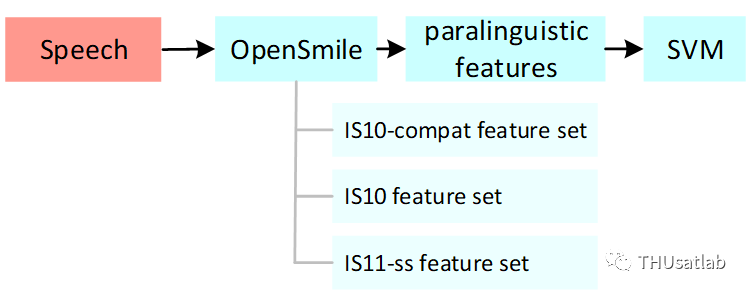
副语言特征提取流程
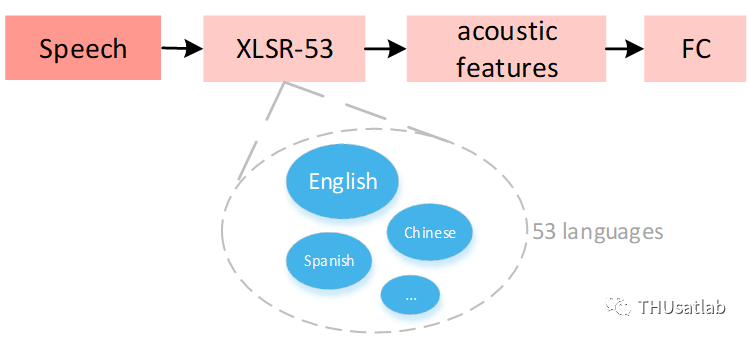
语音预训练特征提取流程
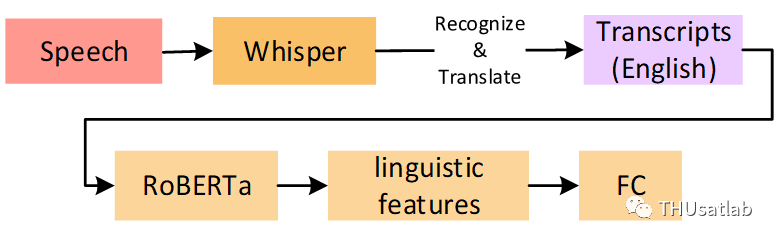
文本预训练特征提取流程
03 实验结果
我们在ICASSP-SPGC-2023ADReSS-M挑战赛的数据集上进行了训练与测试,该挑战赛要求仅用英文数据训练模型,而在希腊语数据集上进行测试。
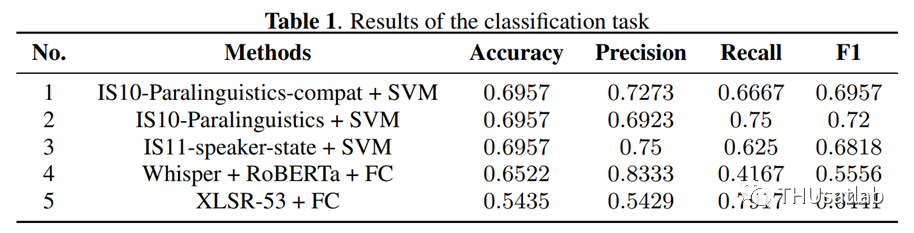
表1 实验结果
在本文中,我们使用副语言特征和预训练特征进行跨语言阿尔兹海默症检测。我们提出的方法中,副语言特征的结果较好,而预训练特征不太令人满意。研究结果表明,副语言特征可以更加有效地进行跨语言阿尔兹海默症检测。我们未来的工作包括上述特征的融合,以及探索跨语言阿尔兹海默症检测的新方法。
