Dynamic Fully-Connected Layer for Large-Scale Speaker Verification在基于x-vector结构的说话人验证系统训练过程中,网络最后通常采用基于one-hot编码的全连接(FC)层对说话人进行分类,即该层需要训练的参数其中一个维度为数据集中说话人数目。随着数据集中说话人的规模不断增大(比如包含百万甚至更多说话人),基于one-hot编码的FC层中需要训练的参数数目呈线性增长。这不仅对硬件资源带来挑战,同时大量计算也带来时间的消耗。
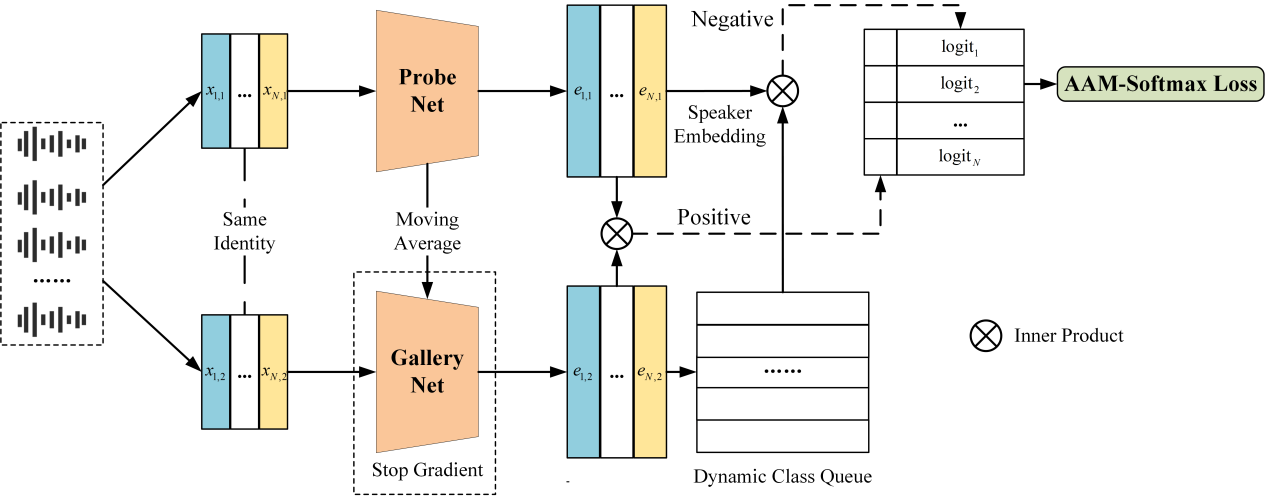
本文提出使用动态全连接(Dynamic FC)层替换基于one-hot编码的FC层。Dynamic FC层采用对比学习[1]的思想,使用两个结构相同的网络分别生成声纹特征矢量(embedding)和伪身份中心。接下来,Dynamic FC层使用一个动态类队列[2,3]存储伪身份中心。动态类队列大小是一个超参数,通过调整动态类队列大小可以减少全连接层的参数数目,实现计算资源和训练时间的节省。此外,基于训练数据VoxCeleb2开发集中平均每个说话人包含语音条数相对多(1092009/5994≈182),我们采用每个说话人选择两条语音组成样本对的数据加载方式进行模型的训练,这将进一步实现约一半的时间节省。
图1 动态全连接层
实验结果分析
我们在VoxCeleb1&2数据集进行了相关实验。特征提取网络由ResNet34、注意力统计池化层以及一个全连接层组成。基线由FC层和我们之前提出的虚拟全连接(Virtual FC)层[4]组成,没有使用数据增强。
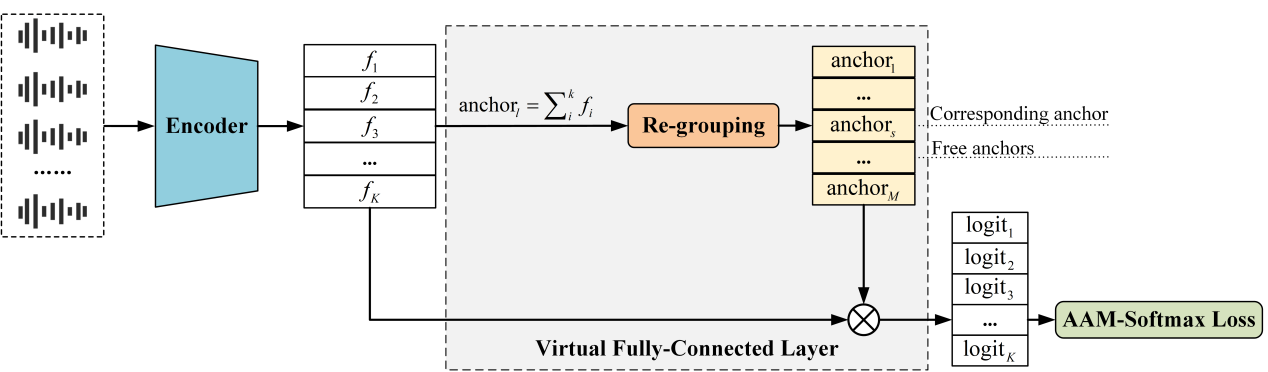
图2 虚拟全连接层
从表1可以看出Dynamic FC层在动态类队列大小为3000时在3个测试列表中均获得最好的性能。Dynamic FC层相较于FC层性能存在差距,是因为我们提出Dynamic FC层是为了在硬件资源占用和性能之间做平衡,更重要的是,在使用大规模说话人验证数据集训练过程中是无法使用FC层(特指最后一层)进行说话人分类的。Virtual FC层采用对说话人编号取余的方式将说话人映射为M组(M是一个小于说话人数目的超参数)解决说话人验证任务中的大规模问题。区别于Virtual FC层对随机映射为同一组的说话人共享权重的方式,Dynamic FC层使用动态类队列存储所有说话人伪身份中心的一个子集来区分说话人,因此可以获得更好的性能。
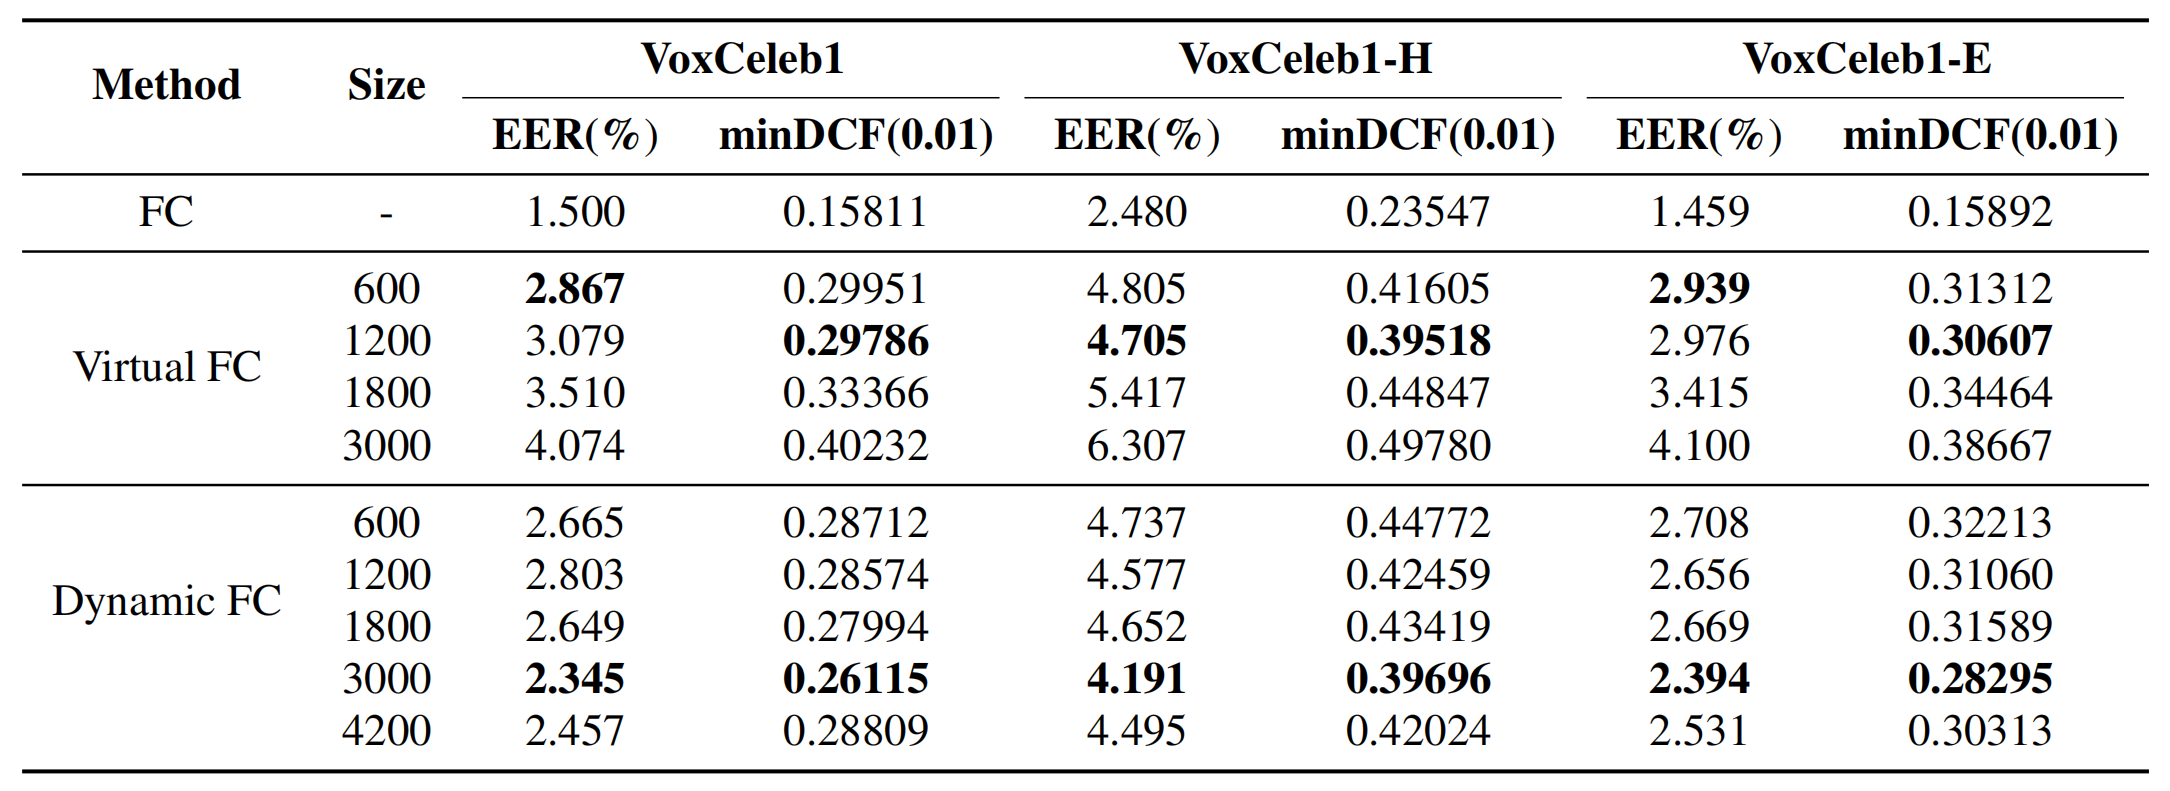
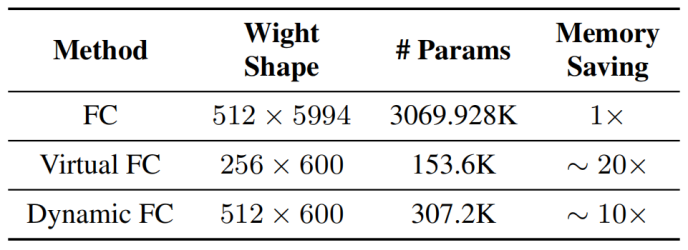
表2中展示了不同全连接层的参数数目情况,可以看出相比使用FC层,使用Virtual FC层和Dynamic FC层可以大幅度减少参数数目。
说话人验证任务中的大规模问题目前来看更像一个前瞻性问题,但不可否认的是数据的产生和收集速度远大于硬件发展速度。我们提出的Dynamic FC层通过控制动态类队列大小可以有效解决说话人验证任务中的大规模问题。进一步,可以在规模大于VoxCeleb的数据集上进行更多探索。
[1]K. He, H. Fan, Y. Wu, S. Xie, and R. Girshick, “Momentum contrast for unsupervised visual representation learning,” in Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, 2020, pp. 9729–9738.[2]B. Li, T. Xi, G. Zhang, H. Feng, J. Han, J. Liu, E. Ding, and W. Liu, “Dynamic class queue for large scale face recognition in the wild,” in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2021, pp. 3763–3772.[3]K. Wang, S. Wang, P. Zhang, Z. Zhou, Z. Zhu, X. Wang, X. Peng, B. Sun, H. Li, and Y. You, “An efficient training approach for very large scale face recognition,” in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2022, pp. 4083–4092.[4]Z. Song, L. He, Z. Fang, Y. Hu, and H. Huang, “Virtual fully-connected layer for a large-scale speaker verification dataset,” in Biometric Recognition: 16th Chinese Conference, CCBR 2022, Beijing, China, November 11–13, 2022, Proceedings. Springer, 2022, pp. 382–390. 
 语音小管家