BEKBQA:Improving Knowledge Base Question Answering with a Bidirectional Entity Scoring Model李嘉明,何亮,马翰翰,王少磊,易升,胡伟伟
研究背景
基于知识库的多跳问答需要在长路径上进行逐跳推理以获得答案实体。然而,由于缺乏具有正确路径标注的数据集,模型的训练只能依靠最后一跳答案的结果进行更新。我们设计了一个结构简单的模型,能够通过知识库上主题实体与答案实体之间前向和后向双向推理的相似性来约束中间推理过程。并且我们设计了新的后向推理的初始化方法,使其更加合理。模型的主要功能完全基于注意力机制,每一跳的结果都可以可视化,推理过程透明。
本文方案
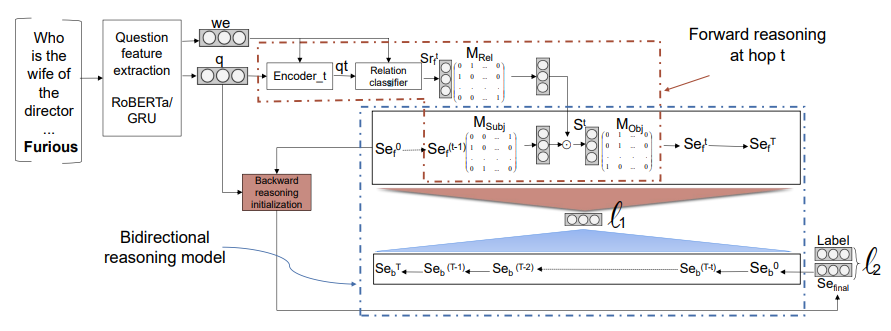
我们以稀疏矩阵表示知识库中实体间的连接关系,使用RoBERTa和GRU获得问句与分词后各个token的嵌入,通过简单的全连接网络获得各个推理步骤每个实体与关系在当前步骤被选择的可能性。其中前向与反向的推理模块结构与推理机制是完全相同的,但初始化方式有差别。
基于知识库的问答(KBQA)旨在通过识别主题实体并选择出与问句相关的图上关系链得到答案,从知识图谱中查找实体用来回答问题。深度学习模型特别是预训练模型在KBQA的单跳任务上已经能够取得比较好的效果,但是在多跳KGQA上性能仍然有很大的提升空间。多跳KBQA 需要在图上经过多个步骤的推理才能得到答案。一个需要在图上经过T跳才能获得答案实体的问句,经过由RoBERTa构成的问句特征提取模块后输出嵌入。前向推理过程中,表示问句整体信息的嵌入分别经过T个独立的全连接层后再与表示各个token的嵌入相乘求和。此时得到的结果是问句在各个推理步骤的不同表示qf。在第t跳时,qf经过一个全连接层和Softmax后输出表示当前步骤下各个关系被选择的可能性的Sr,该向量与表示图谱结构的稀疏矩阵相乘后得到表示第t跳下各个实体被选择可能性的Se。如此类推逐跳更新Se。反向推理与前向推理方法一致,目的是得到从答案实体到主题实体间T跳的实体得分。我们将前向第t跳的结果与反向第T-t跳的结果求相似性作为约束以完成训练。
从答案实体到主题实体的反向推理过程并不像正向推理一样完全符合问句的语义信息和问句蕴含的关系顺序。解决这个问题的关键是确保反向过程要充分获得整个前向推理过程的信息,我们将问句特征提取模块输出的问句整体嵌入经过一个全连接层与Softmax层后再分别与前向推理过程得到的T个实体得分向量Se相乘求和作为反向推理Se的初始化。模型训练时的损失函数由两部分构成:实体得分向量的最后结果与真实答案标签之间的距离;前向与后项T个步骤的实体得分向量之间的距离。
实验结果
我们在三个多跳KBQA数据集上进行了实验,其中MetaQA我们只选择了跳数最多的3-hop来验证方法的有效性。
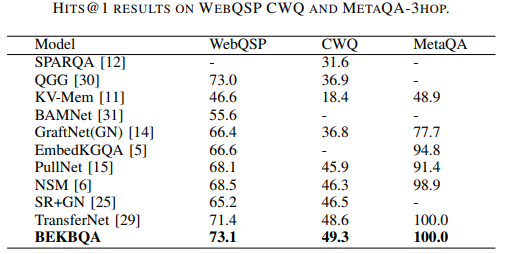
表1 在三个数据集上的Hits@1结果比较
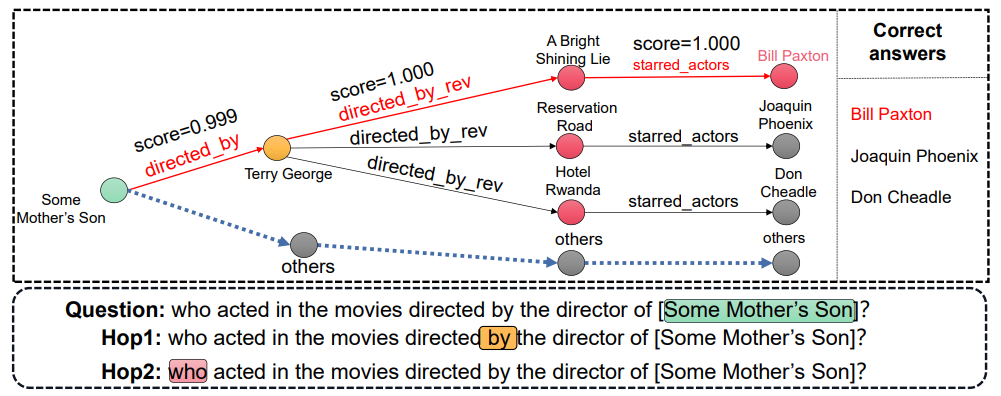
从表1中可以看出,我们的方法在3个数据集上均获得了一定的提升。感谢Zhang等人提供的MetaQA[1]优质的数据集, 我们获得了100%的Hits@1效果。这个数据集给出的训练数据足够丰富和多样,足以保证模型能够学习到正确的推理方法。同时,作为电影领域的数据集与一般领域的数据集相比MetaQA 内部的实体和连接关系相对简单。图2展示了我们的方法在需要三跳推理才能得到答案的问句的结果,不同的推理步骤下关注问句的侧重点不同,结果显示我们的方法保证了前向推理过程中对实体和关系选择的可靠性。结论
我们提出了一种通过主题实体与答案实体间正向与反向两个推理过程获得的实体得分向量的相似性来约束模型训练的方法。实验结果表明,该方法提升了前向推理得到答案实体的准确率,而且每跳的结果均可显式输出提高了推理的透明性。[1] Zhang, H. Dai, Z. Kozareva, A. J. Smola, and L. Song, “Variational reasoning for question answering with knowledge graph,” in Thirty second AAAI conference on artificial intelligence, 2018. 
 语音小管家