
 语音小管家
LLM训练过程
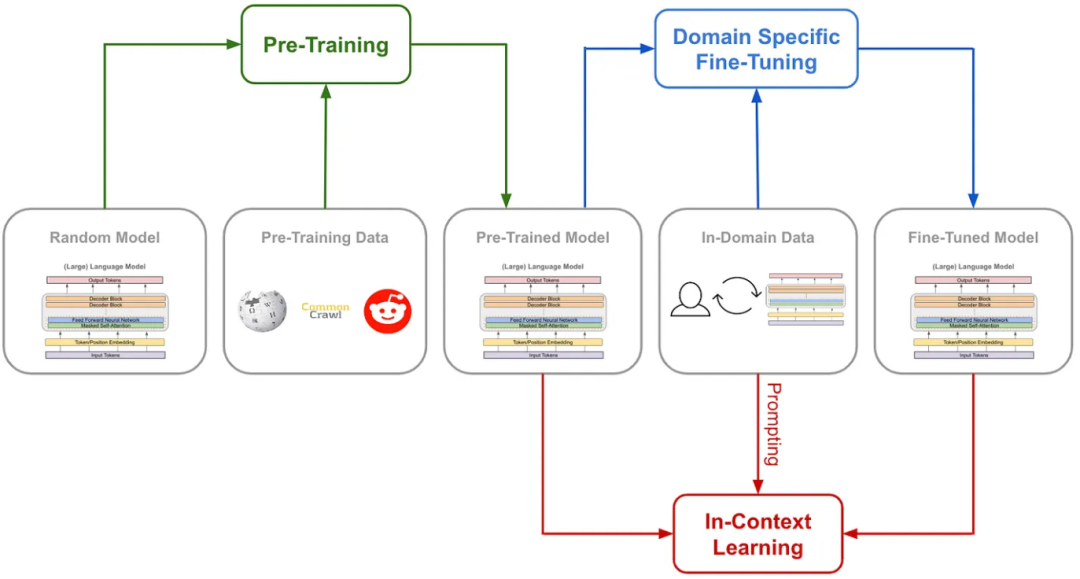
LLMs的训练基本上可以分为两个阶段:(1)从原始文本进行无监督预训练,以学习通用表示;(2)大规模指令调整和强化学习,以更好地适应最终任务和用户偏好。尽管近几个月来人们从各种不同的角度对语言模型进行了研究,但这些模型的创建往往遵循具有一些共同组件的标准化流程,如下图所示:
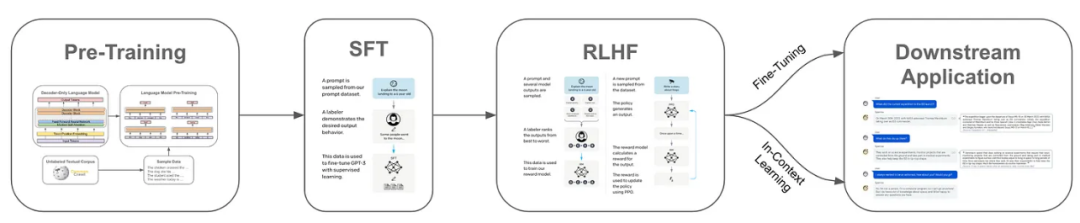
其中,首先,基于大量标记文本进行模型预训练;然后,模型会经历一个对齐过程,包括监督微调(SFT)和来自人类反馈的强化学习(RLHF);最后,模型经过训练之后即可进行下游应用程序的部署,在此过程中可以对模型做进一步的微调和上线文学习来提高模型性能。下面将概述每个过程,以更好的了解它们对LLM性能的影响。
LLMs预训练
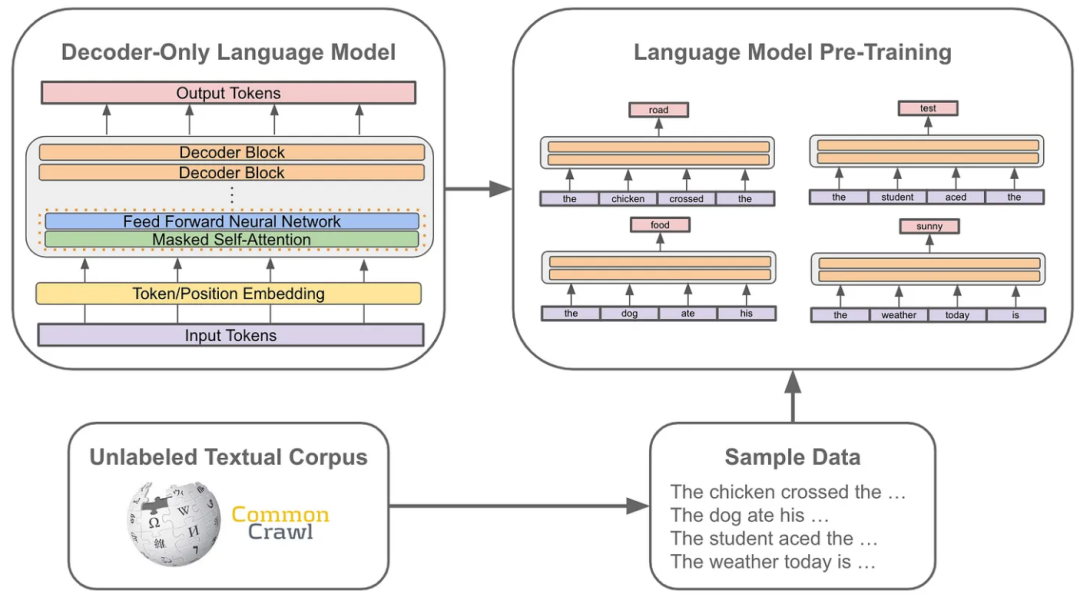
如下图所示,预训练过程是创建LLMs过程中计算成本最高的步骤。
LLMs对齐
预训练完成后,就有了一个“基础模型”,或者说是一个尚不具备任何专业能力的通用LLM。为了赋予模型对话、遵循指令等的能力,还必须对这个模型进行调整,或者训练它来模仿人类用户所需的行为。在大多数情况下,对齐过程基于两种主要技术:监督微调 (SFT)、基于人类反馈的强化学习 (RLHF),如下图所示。这些技术可以单独使用,也可以通过依次执行来组合在一起。ChatGPT的前身(InstructGPT)就是采用了相互组合的方法。
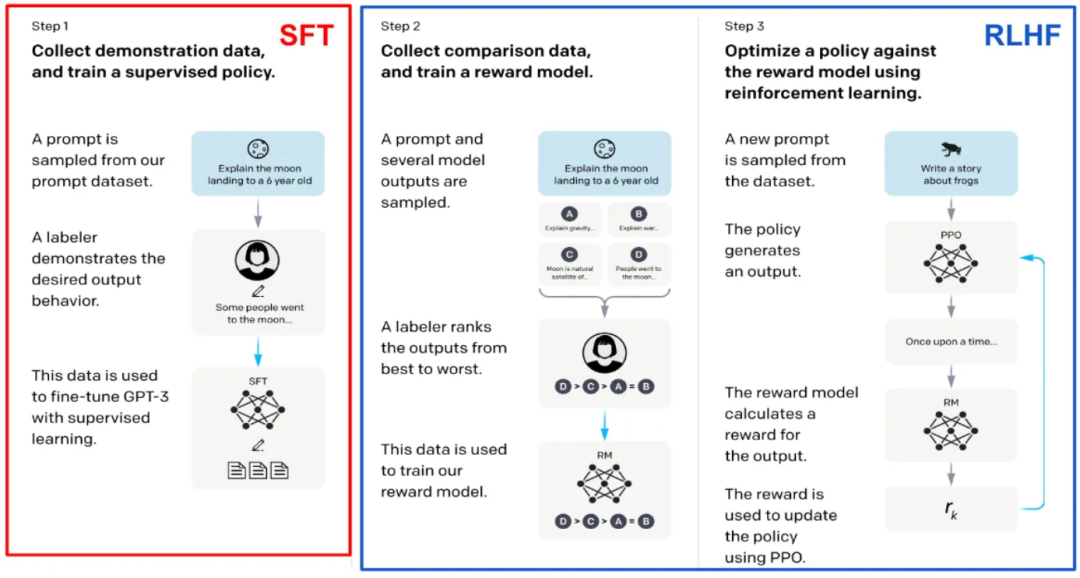
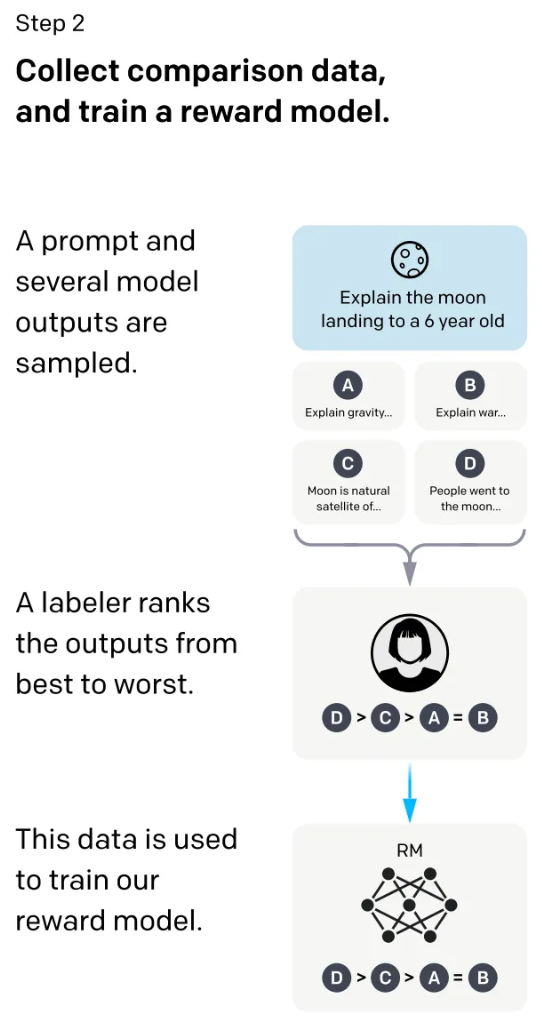
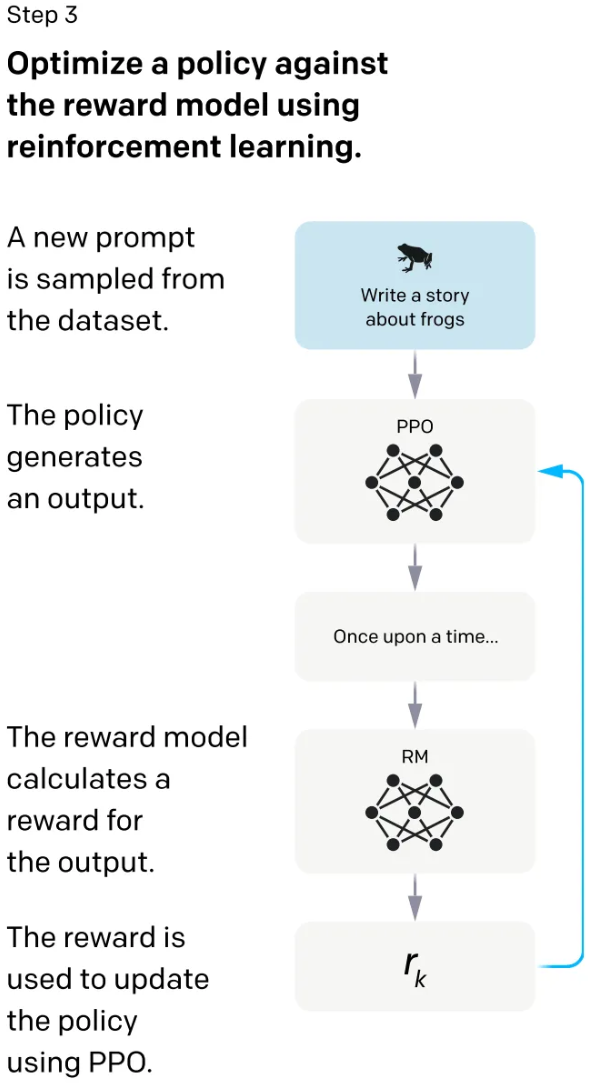
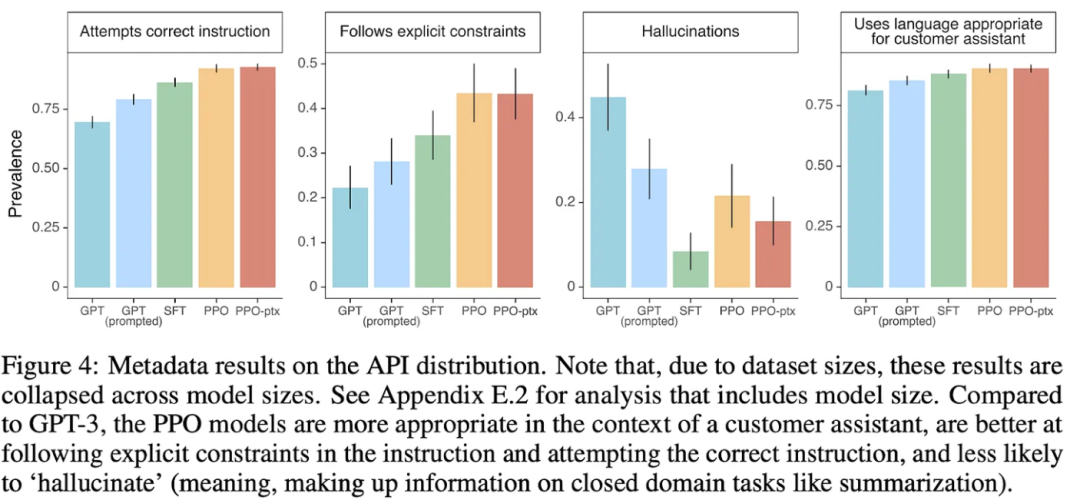
上述 RLHF 过程的妙处之处在于,让我们可以直接根据人类偏好来优化模型,但“偏好”可以捕获各种不同的属性!例如,也许我们希望模型更好地遵循指令,输出更有趣的内容,甚至停止产生幻觉(即编造虚假信息)。所有这些行为都可以通过使用 RLHF 进行优化,使其成为一个非常强大的对齐工具。
LLMs模型应用
LIMA
在这些示例上进行训练时,我们发现 LIMA 的性能非常好,甚至接近 GPT-4 和 Claude2 等最先进的专有模型的性能。这样的结果表明,可以通过少量精心选择的示例来有效地对齐语言模型,从而强调了数据质量和多样性在训练和对齐强大的语言模型中的作用。
「表面对齐假说」。根据以上实验结果,Zhou等人提出了表面对齐假说 (SAH),上面的引文对此进行了总结。LLM的大部分核心知识都是在预训练期间学习的,而对齐则是寻找正确的格式来呈现这些知识。SAH简单地指出,在给定一组具有足够质量和多样性的示例的情况下,可以通过数据有效的方式学习对齐。
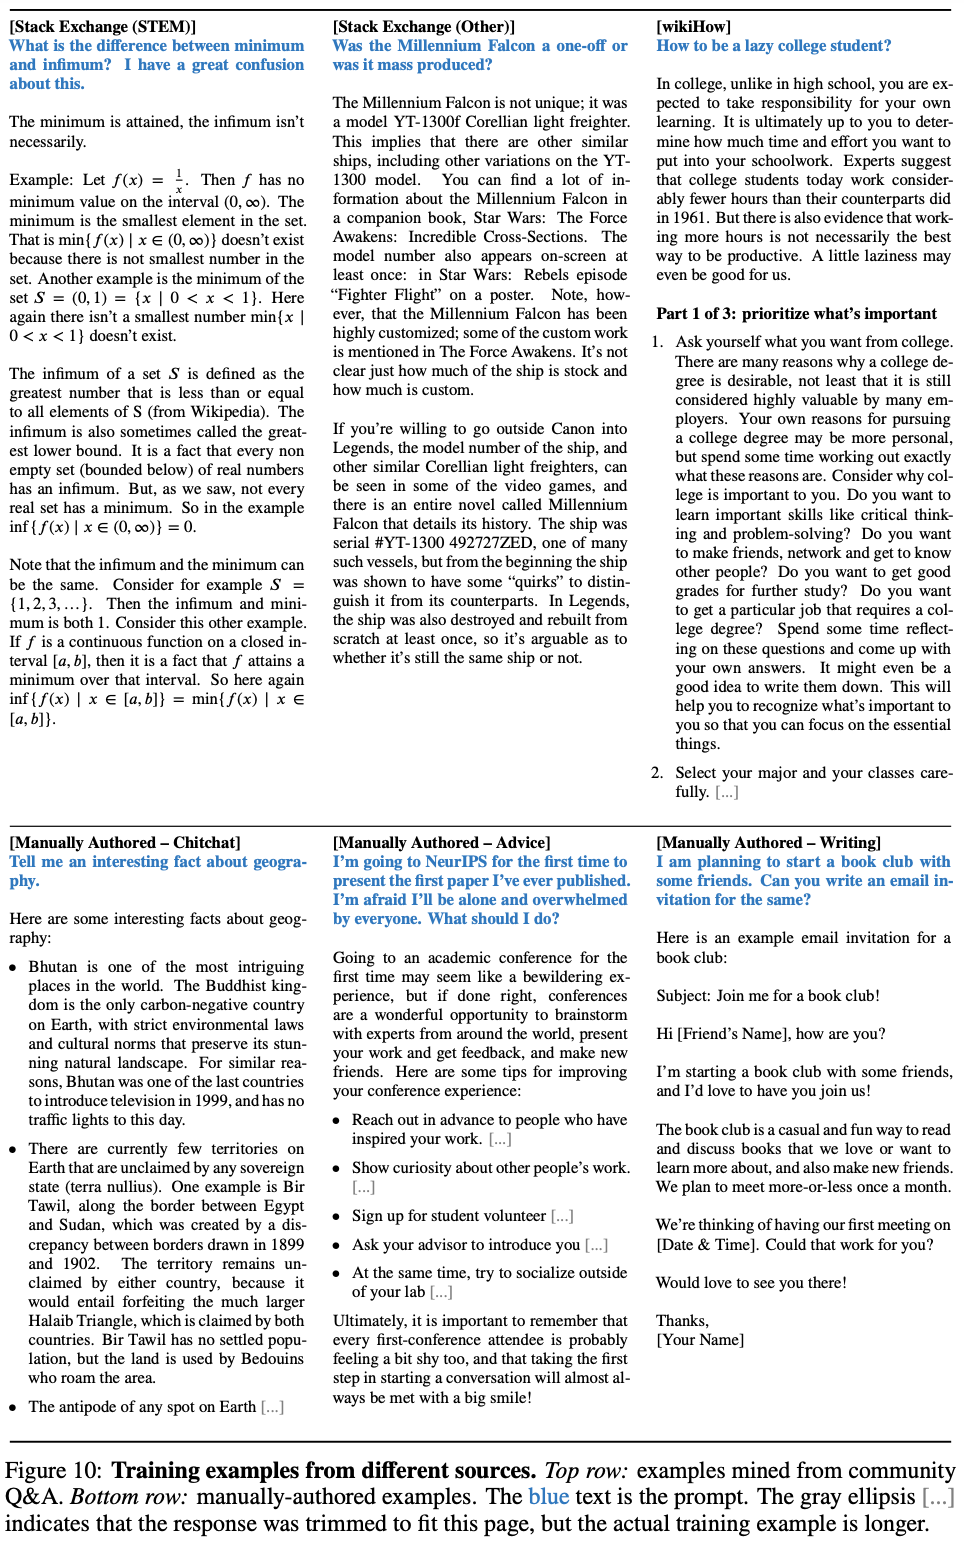
「整理数据实现对齐」。Zhou等人用于对齐的数据集是由社区 QA 论坛(例如 StackExchange、wikiHow 和 Reddit)和手动编写的示例相结合构建的。与最近自动化SFT数据整理的工作不同,Zhou等人制作的数据都经过仔细(通常是手动)过滤,以保证质量和多样性。尽管手动管理需要时间,但它提高了生成数据集的质量,这个发现是非常有益的。
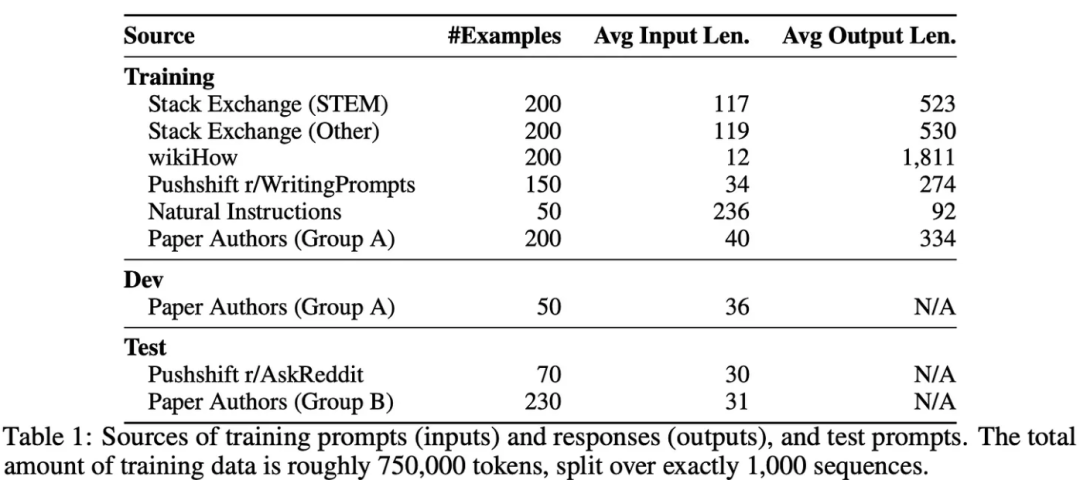
「数据获取」。LIMA 训练数据的细分如上表所示。在训练集中,750 个示例来自社区 QA 论坛。为了确保数据质量,这些示例要么手动过滤,要么通过“投票”指标进行过滤。其余 250 个示例由作者手动编写——200 个从头开始,50 个来自 SuperNaturalInstructions。手动创建数据时,作者通过确保以下几点来最大限度地提高多样性和一致性:1)在响应风格方面和AI助理保持一致;2)Prompt尽可能多样化。
可实现自动化吗?
在最近使用开源LLMs进行模仿学习的研究中,我们通常会看到用于微调的数据是自动管理的。例如,SFT 的数据可以从在线资源(例如 ShareGPT)下载,也可以直接从 ChatGPT 或 GPT-4 的 LLM API 获取。与手动管理相比,这种方法非常高效,并且甚至在某些情况下效果很好;例如,Mukherjee等人经过从 ChatGPT/GPT-4 获得的大量对话的训练,并且表现相当好(甚至与顶级模型相比)。然而,在Gudibande等人的工作中发现,以这种方式训练的模型通常存在局限性,并且在进行广泛分析时表现不佳。
对于Zhou等人的工作,他们没有自动获取大量数据,而是手动过滤并选择较少的示例。这种规模较小(但劳动密集型)的选择过程可以控制数据的多样性和质量,这说明了「数据规模和质量对LLM对齐的影响」。
对齐是表面上的吗?
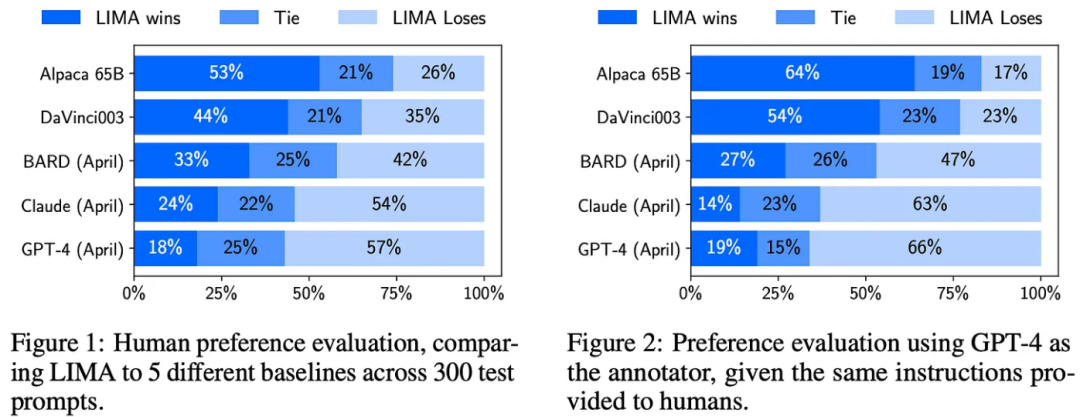
LIMA 的性能与多种不同语言模型的性能进行了比较。特别是,我们看到 LIMA 的性能与 Alpaca-65B、DaVinci003(即 GPT-3.5 的 RLHF 调整版本)、Bard(即基于PaLM)、Claude(52B参数 LLM)和 GPT-4 进行比较。使用众包工作者和 GPT-4 的自动反馈进行评估,如上图所示。可以发现,LIMA 的性能始终优于 Alpaca,甚至在相当多的情况下匹配或超过了Claude和GPT-4的质量。鉴于这些其他模型经过数百万用户提示和反馈的训练,LIMA 的竞争表现令人印象深刻。
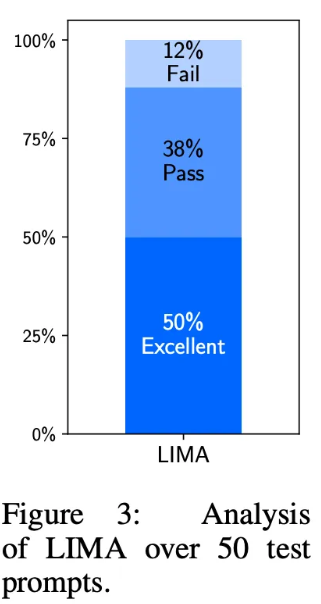
「绝对表现」。除了上面进行的模型比较试验之外,Zhou等人还手动评估了 LIMA 生成的 50 个随机响应的质量。有趣的是,LIMA在50个回答中答出了44个,并且有25个回复相当出色。
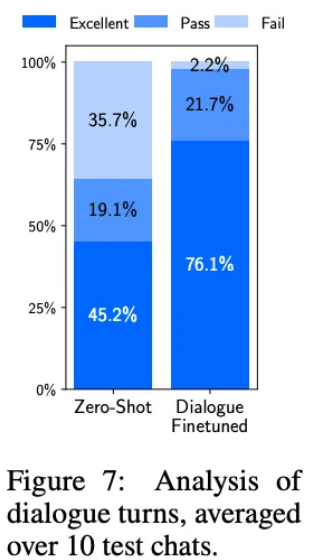
当对分布外的提示(即与微调集中包含的示例有很大不同的提示)重复此手动评估时,结果并没有太大不同 - 20% 的响应失败,35% 通过, 45%为优秀。这样的结果表明 LIMA 实际上具有良好的泛化能力,而不仅仅是过度拟合精选的微调数据集。除此之外,LIMA 可以相对较好地(但不是很好)执行多轮对话,尽管其微调数据集中没有这样的例子。当仅向模型提供 30 个多轮对话示例时,我们看到 LIMA 很快学会了如何从这些示例中维持对话。
数据有用属性
除了上面概述的主要结果之外,我们在Zhou等人的消融实验中看到,用于对齐的示例的多样性和质量非常重要。值得注意的是,仅仅增加微调数据集的大小并不总能提高 LLM 的性能。因此,仔细管理高质量数据以进行对齐是很有价值的。
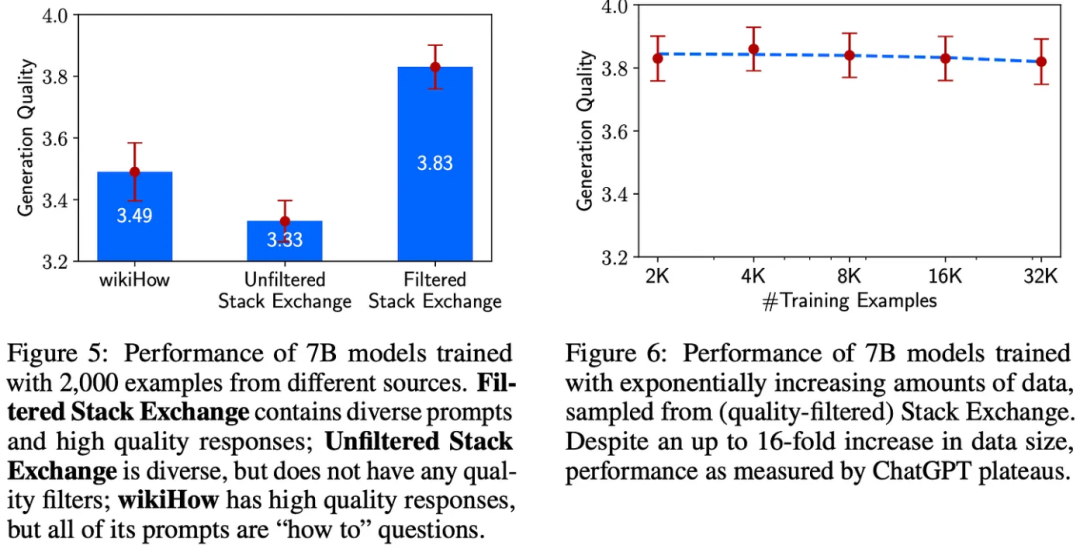
质量>数量
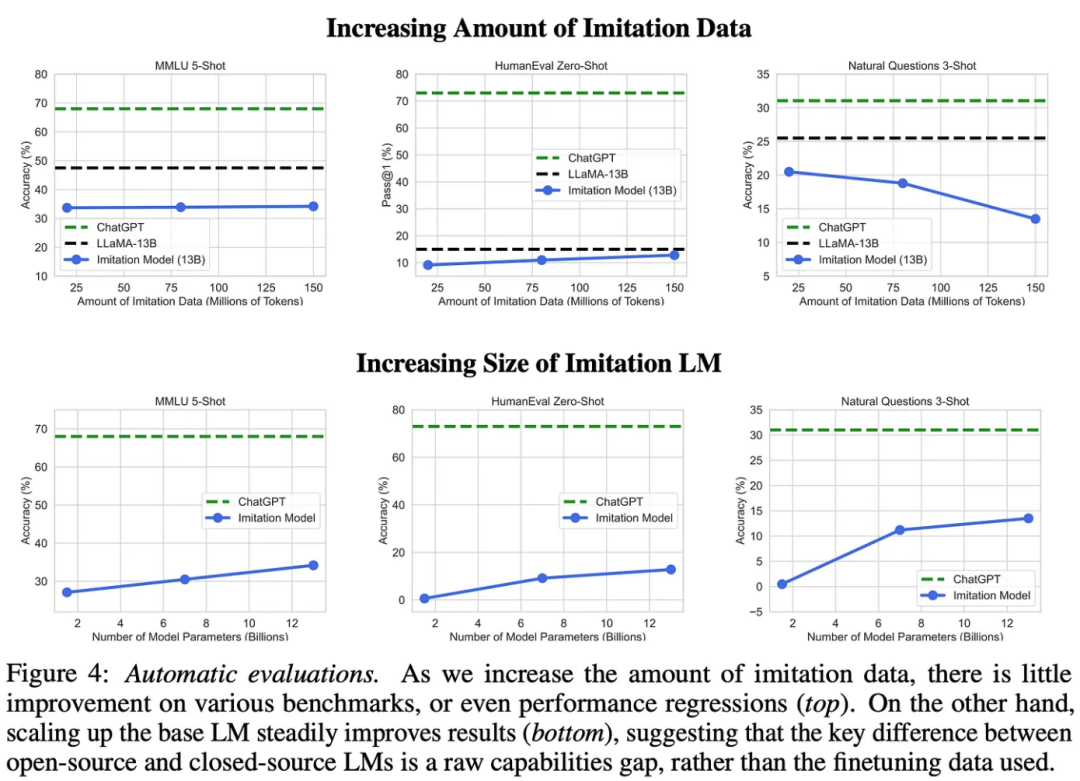
鉴于仅增加数据量不会产生任何好处,我们有2种不同的选择来提高法LLMs的表现:
创建更强大的基础训练数据集 改进对齐数据集
虽然一些工作(例如 MPT 和 Falcon)已经探索了更好的基础模型的创建,但 LIMA 研究了如何创建更好的对齐数据集。简而言之,创建一个既多样化又高质量的比对数据集(即使它很小!)是非常有效的。LLMs可以根据最少的数据准确地学习模拟某些行为。
但是,这些模型的验证结果并不完美!之前的模仿模型最初被认为表现得非常好,甚至可以与 ChatGPT 等顶级专有模型相媲美。然而,我们后来发现,「这样的结论是人为错误的产物。这些模型模仿了专有的 LLMS 的风格,但缺乏真实性,并且在训练集之外的泛化能力较差,人类在评估这些模型时更难以推断出这一点」。鉴于 LIMA 也主要由众包工作者进行评估,Zhou等人的结果也受到类似的限制。然而,我们看到 LIMA 往往具有良好的泛化能力,并且常常优于 Alpaca 等模仿模型,这表明高质量的比对数据仍然对 LLM 的表现非常有利。
数据>对齐
「预训练」。在各种不同的模型中,我们发现用于预训练的数据质量非常重要。例如,在Galactica中,作者发现,在较小的、精心策划的高质量科学信息数据集上进行训练可以产生最佳性能。同样,BioMedLM 模型是在较小的、精选的技术内容语料库上进行预训练的。最后,Falcon-40B(目前最先进的开源语言模型)非常重视预训练数据的质量,我们看到作者投入了大量精力来开发一种新颖且高效的模型用于从网络中提取高质量预训练数据的管道。
「对齐」。除了LIMA中探索的方法之外,最近提出的 Orca 模型还深入研究了数据质量在解决对齐问题中的作用。然而,采用了稍微不同的方法。也就是说,作者使用模仿方法训练模型,但使用模型中有关如何解决每个问题的详细信息来扩充用于 SFT 的数据(即与其他LLMs的对话示例)。研究发现,在对齐数据集中包含这些额外的细节可以产生比Alpaca 或 Vicuna等模型更加稳健的模仿模型。
