
 语音小管家
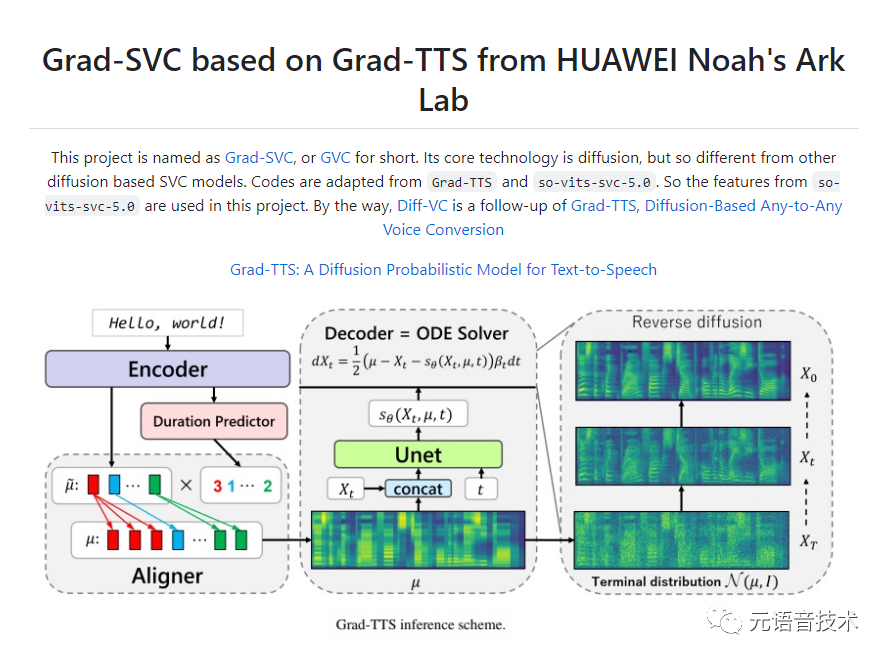
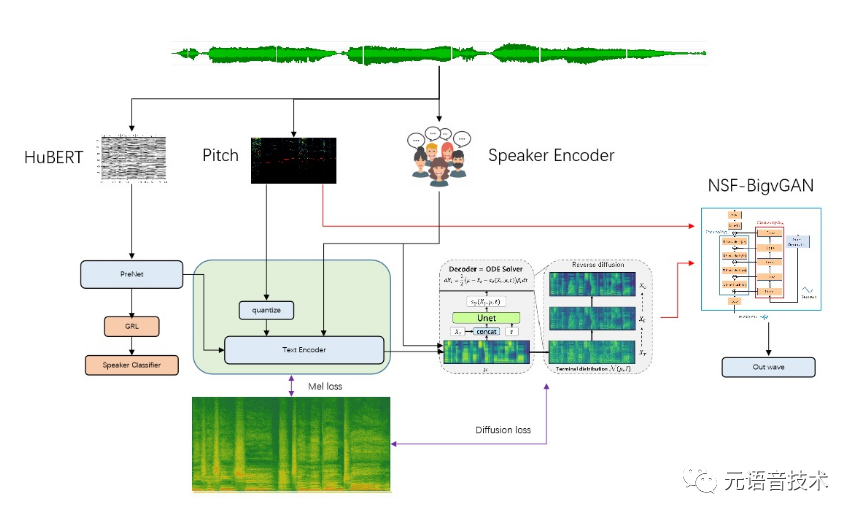
项目地址:https://github.com/PlayVoice/Grad-SVC
华为诺亚方舟实验室Grad-TTS崛起之路
2021.05Grad-TTS: A Diffusion Probabilistic Model for Text-to-Speech
链接:https://arxiv.org/abs/2105.06337
演示:https://grad-tts.github.io/
代码:https://github.com/huawei-noah/Speech-Backbones/tree/main/Grad-TTS
作者:Vadim Popov, Ivan Vovk, Vladimir Gogoryan, Tasnima Sadekova, Mikhail Kudinov
机构:Huawei Noah’s Ark Lab
2022.09Fast Grad-TTS: Towards Efficient Diffusion-Based Speech Generation on CPU
链接:https://www.isca-speech.org/archive/pdfs/interspeech_2022/vovk22_interspeech.pdf
演示:https://fast-grad-tts.github.io/
作者:Ivan Vovk, Tasnima Sadekova, Vladimir Gogoryan, Vadim Popov, Mikhail Kudinov, Jiansheng Wei
机构:Huawei Noah’s Ark Lab
目的:speed Grad-TTS up to 4.5 times compared to vanilla GradTTS and achieve real time factor 0.15 on CPU
2022.11Any-speaker Adaptive Text-To-Speech Synthesis with Diffusion Models
标题:基于扩散模型的任意说话人自适应文语转换合成
链接:https://arxiv.org/abs/2211.09383
演示:https://nardien.github.io/grad-stylespeech-demo
作者:Minki Kang,Dongchan Min,Sung Ju Hwang
机构:AITRICS, KAIST
目的:基于扩散模型的任意说话人自适应TTS框架Grad-StyleSpeech,该框架能够在给定几秒参考语音的情况下,生成与目标说话人语音具有极高相似度的高度自然的语音
2023.01ResGrad: Residual Denoising Diffusion Probabilistic Models for Text to Speech
标题:ResGrad:文语转换的残差去噪扩散概率模型
链接:https://arxiv.org/abs/2212.14518
演示:https://resgrad1.github.io/
作者:Zehua Chen,Yihan Wu,Yichong Leng,Jiawei Chen,Haohe Liu,Xu Tan,Yang Cui,Ke Wang,Lei He,Sheng Zhao,Jiang Bian,Danilo Mandic
机构:Renmin University of China, Universityof Science and Technology of China, South China University of Technology, University of Surrey†Work done during an internship at Microsoft
目的:提出了ResGrad,这是一种轻量级扩散模型,它学习精炼现有TTS模型的输出谱图(例如,FastSpeech 2),通过预测模型输出和相应地面实况语音之间的残差。
ResGrad有几个优点:
1)与其他需要从头开始合成语音的DDPM加速方法相比,ResGrad通过将生成目标从地面实况梅尔谱图改为残差,降低了任务的复杂度,使得模型更加轻量级,从而降低了实时性。
2)ResGrad以即插即用的方式应用于已有TTS模型的推理过程中,不需要重新训练该模型。
与其他DDPM加速方法相比:
1)ResGrad算法在保证实时性的前提下获得了更好的样本质量;
2)在语音质量相似的情况下,ResGrad合成语音的速度比基线方法快10倍以上。
2023.02Imaginary Voice: Face-styled Diffusion Model for Text-to-Speech
标题:虚声:面向文语转换的人脸扩散模型 (和voiceme目的一样)
链接:https://arxiv.org/abs/2302.13700
演示:https://facetts.github.io/
代码:https://github.com/naver-ai/facetts
作者:Jiyoung Lee,Joon Son Chung,Soo-Whan Chung
机构:NAVER AI Lab, South Korea, Korea Advanced Institute of Science and Technology, South Korea, NAVER Cloud, South Korea
目的:这项工作的目标是zero-shot的文本到语音合成,说话风格和声音学习的面部特征。受人们在看到某人的脸时可以想象其声音这一自然事实的启发,我们在一个从可见属性学习的统一框架内引入了一个人脸风格的扩散文本到语音(TTS)模型,称为Face-TTS。这是第一次使用人脸图像作为训练TTS模型的条件。我们联合训练跨模型生物特征和TTS模型,以保持人脸图像和生成的语音片段之间的说话人身份。我们还提出了一个说话人特征绑定损失来增强生成语音片段和真实语音片段在说话人嵌入空间中的相似性。由于生物特征信息是直接从人脸图像中提取的,因此我们的方法不需要额外的微调步骤来从看不见和听不见的说话者生成语音。我们在LRS 3数据集上训练和评估该模型,该数据集是一个包含背景噪声和多种说话风格的野生视听语料库。
2023.5CoMoSpeech: One-Step Speech and Singing Voice Synthesis via Consistency Model
标题:CoMoSpeech:基于一致性模型的一步语音和歌唱语音合成
链接:https://arxiv.org/abs/2305.06908
演示:https://comospeech.github.io/
代码:https://github.com/zhenye234/CoMoSpeech
作者:Zhen Ye,Wei Xue,Xu Tan,Jie Chen,Qifeng Liu,Yike Guo
机构:Hong Kong Baptist University , Hong Kong University of Science and Technology, Microsoft Research Asia, Hong Kong Institute of Science & Innovation, Chinese Academy of Sciences
目的:通过一个单一的扩散采样步骤,实现高音质的语音合成。CoMoSpeech的推理速度比单个NVIDIA A100 GPU上的实时速度快150倍以上,与FastSpeech2相当,使基于扩散采样的语音合成真正实用。
2023.06Diff-TTSG: Denoising probabilistic integrated speech and gesture synthesis
标题:DIFF-TTSG:去噪概率综合语音和手势合成
链接:https://arxiv.org/abs/2306.09417
代码:https://github.com/shivammehta25/Diff-TTSG
作者:Shivam Mehta,Siyang Wang,Simon Alexanderson,Jonas Beskow,Éva Székely,Gustav Eje Henter
机构:Division of Speech, Music and Hearing, KTH Royal Institute of Technology, Sweden
目的:提出了第一个基于扩散的概率模型,称为Diff-TTSG,共同学习合成语音和手势
2023.08Multi-GradSpeech: Towards Diffusion-based Multi-Speaker Text-to-speech Using Consistent Diffusion Models
标题:多等级语音:基于一致扩散模型的多说话人文语转换:与Grad-TTS模型完全相同,添加一致性Loss
链接:https://arxiv.org/abs/2308.10428
代码:https://github.com/giannisdaras/cdm
演示:https://welkinyang.github.io/multi-gradspeech/
作者:Heyang Xue,Shuai Guo,Pengcheng Zhu,Mengxiao Bi
机构:Fuxi AI Lab, NetEase Inc., Hangzhou, China
目的:提出了多梯度语音,一个多说话人扩散为基础的声学模型,它引入了一致扩散模型(CDM)作为一种生成的建模方法。在训练过程中,我们加强了CDM的一致性,以缓解推理阶段的采样漂移问题,从而在多说话人TTS的性能显着提高。
2023.09LightGrad: Lightweight Diffusion Probabilistic Model for Text-to-Speech
标题:LightGrad:轻量级文语转换扩散概率模型
链接:https://arxiv.org/abs/2308.16569
代码:https://github.com/thuhcsi/LightGrad
作者:Jie Chen,Xingchen Song,Zhendong Peng,Binbin Zhang,Fuping Pan,Zhiyong Wu
机构:Shenzhen International Graduate School, Tsinghua University, Shenzhen, China, Horizon Robotics, Beijing, China, WeNet Open Source Community, The Chinese University of Hong Kong, Hong Kong SAR, China
目的:LightGrad配备了轻量级的U-Net扩散解码器和免训练快速采样技术,减少了模型参数和推理延迟。流式推理也在LightGrad中实现,以进一步减少延迟。与Grad-TTS相比,LightGrad在参数上减少了62.2%,延迟减少了65.7%,同时在4个去噪步骤中保持了汉语普通话和英语相当的语音质量。
2023.09DiCLET-TTS: Diffusion Model based Cross-lingual Emotion Transfer for Text-to-Speech -- A Study between English and Mandarin
标题:DiCLET-TTS:基于扩散模型的文语转换跨语言情感传递--基于英语和汉语的对比研究
链接:https://arxiv.org/abs/2309.00883
作者:Tao Li,Chenxu Hu,Jian Cong,Xinfa Zhu,Jingbei Li,Qiao Tian,Yuping Wang,Lei Xie
目的:具体而言,为了在缓解外国口音问题的同时提高情感表达能力,采用先验文本编码器以情感嵌入为条件,将前向扩散过程的终端分布参数化为与说话人无关但与情感相关的语言先验。针对情绪嵌入中说话人解纠缠导致的情绪表达能力较弱的问题,提出了一种基于正交投影的情绪解纠缠模块(OP-EDM)来学习说话人无关但情绪判别的嵌入。此外,引入了条件增强DPM解码器,增强了说话人和反向扩散过程中情绪的建模能力,进一步提高了语音传递中的情绪表达能力。
未完待续~~~
