
 语音小管家
悟道·天鹰Aquila大语言模型系列全面升级到Aquila2,并再添 340亿参数(34B)重量级新成员,带来当前最强的开源中英双语大模型。
https://github.com/FlagAI-Open/Aquila2 https://model.baai.ac.cn/ https://huggingface.co/BAAI
Aquila2-34B在代码生成、考试、理解、推理、语言四个维度的22个评测基准上,霸占了多个榜单TOP 1。
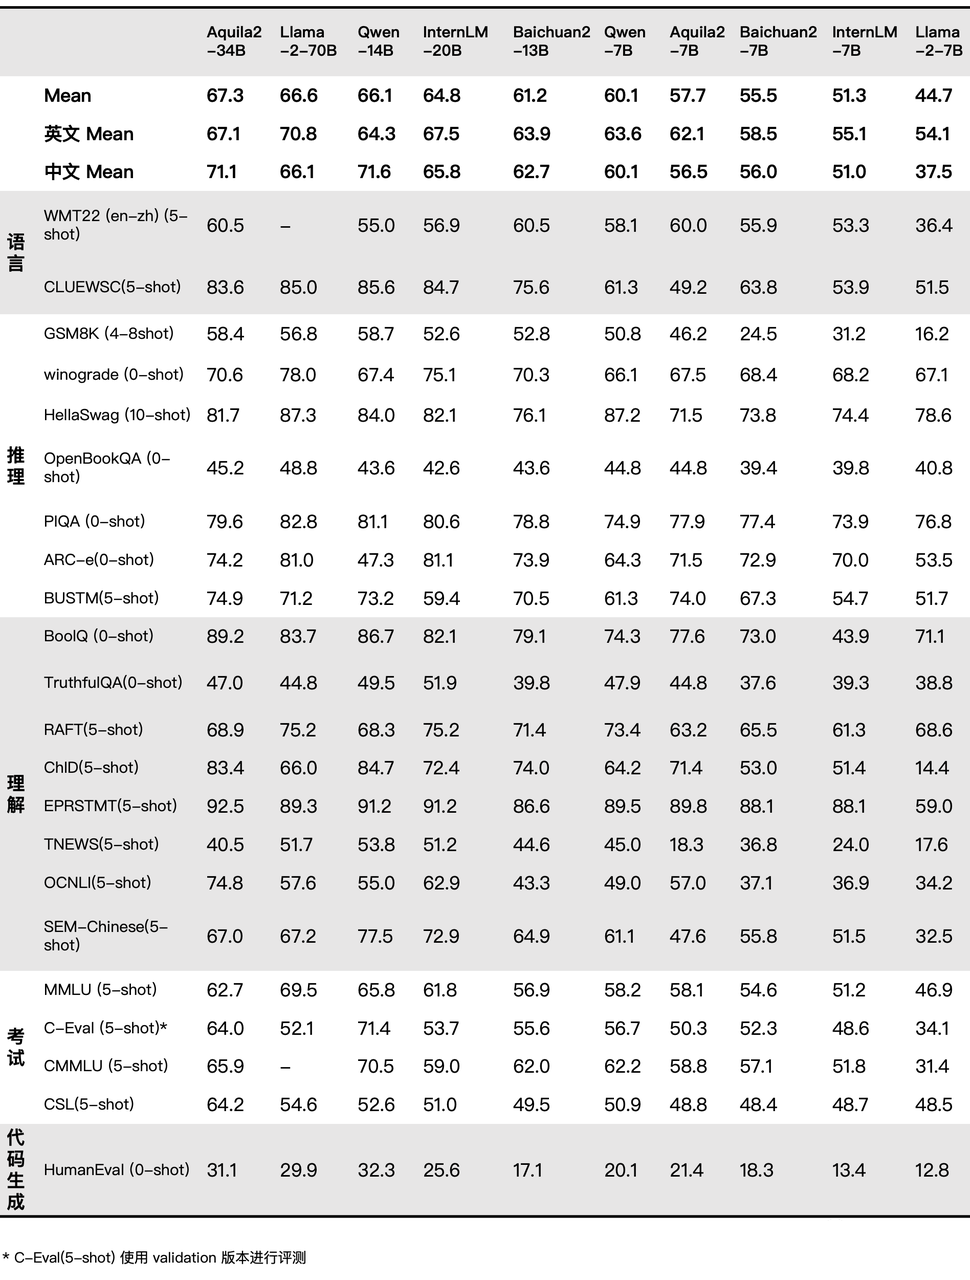
最强开源中英双语大模型
1. Aquila2-34B 基座模型与对话模型全面领先
同时,Aquila2 基础模型以最强开源基座模型综合性能,为下游模型提供强大支撑,经指令微调得到了优秀的的 AquilaChat2 对话模型系列。
AquilaChat2-34B 成为当前最强开源中英双语对话模型,在主观+客观综合评测中全面领先 。
AquilaChat2-7B 也取得同量级中英对话模型中综合性能最佳成绩。
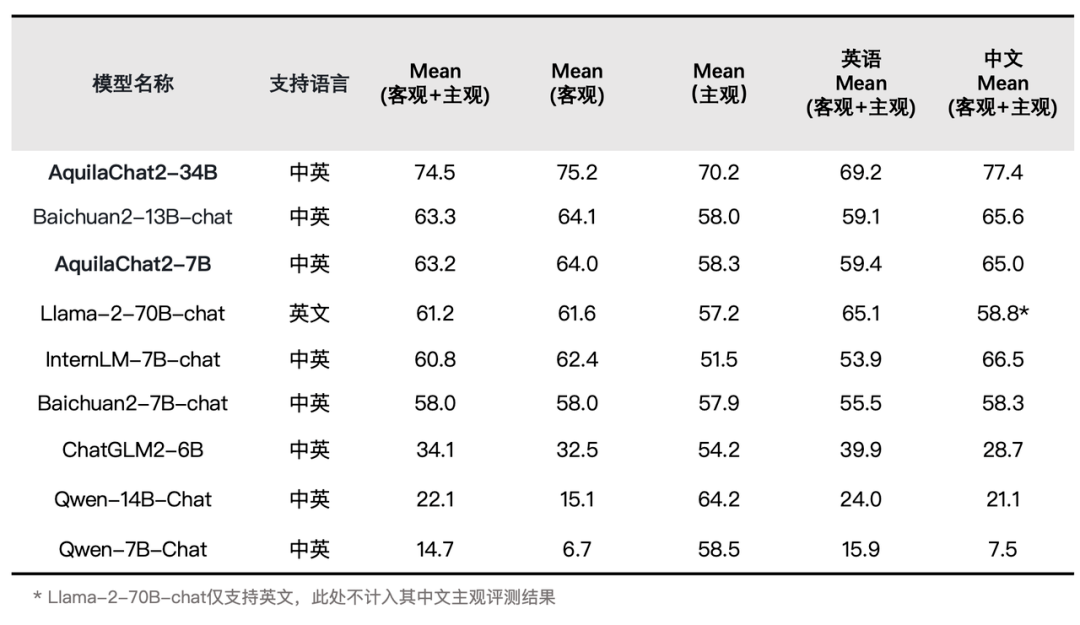
图:SFT 模型评测结果
(详细数据集评测结果见官方开源仓库介绍)
大模型的推理(Reasoning)能力是实现通用人工智能(AGI)的关键能力,AquilaChat2-34B 在 IRD 评测基准中排名第一,超越 LLama2-70B、GPT3.5等模型,仅次于 GPT4。
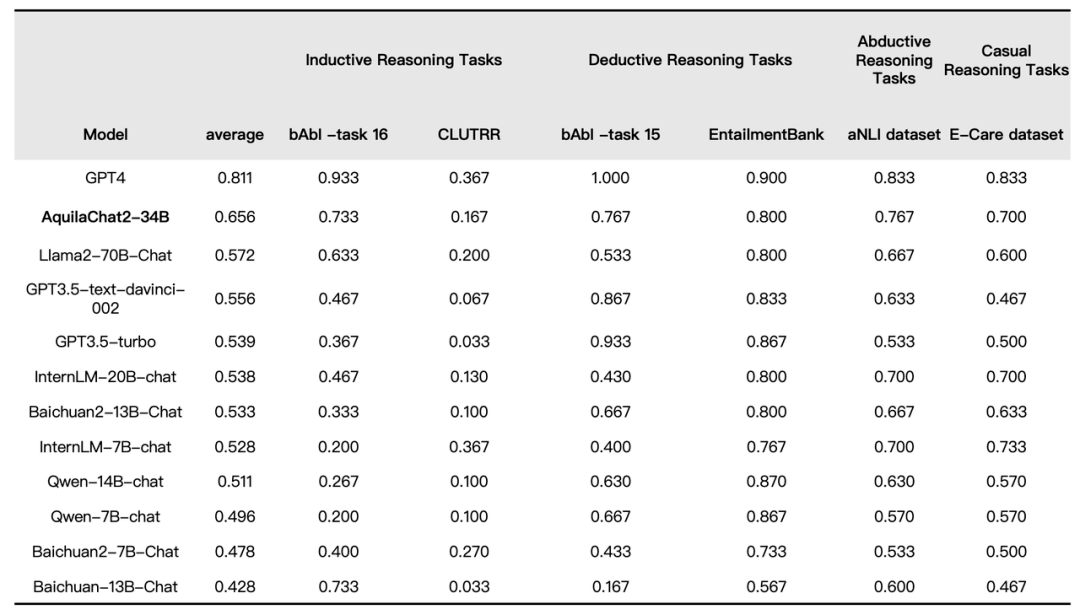
智源团队整理了评测基准 Integrated Reasoning Dataset(IRD)考察模型在归纳推理、演绎推理、溯因推理和因果推理维度上的推理结果和过程的准确性,并对主流对话模型进行了全面评测。
2. 高效扩充模型上下文窗口长度至 16K
AquilaChat2-34B-16K 以 Aquila2-34B 为基座,经过位置编码内插法处理,并在 20W 条优质长文本对话数据集上做了 SFT,将模型的有效上下文窗口长度扩展至 16K。
在 LongBench 的四项中英文长文本问答、长文本总结任务的评测效果显示,AquilaChat2-34B-16K 处于开源长文本模型的领先水平,接近 GPT-3.5 长文本模型。
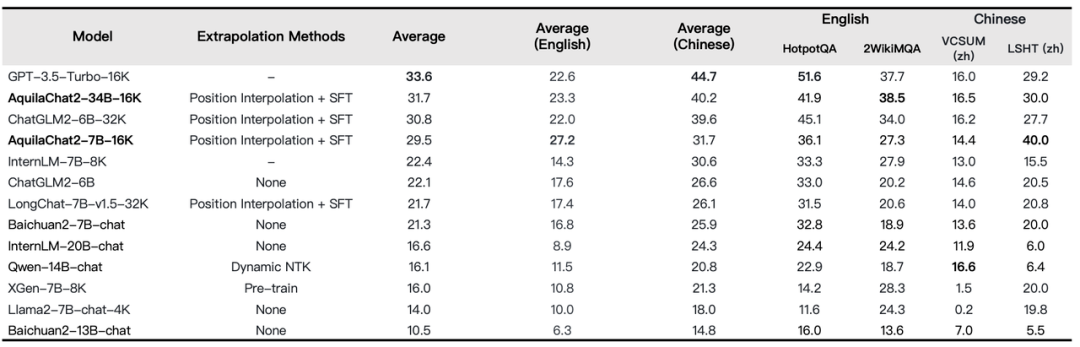
图:长文本理解任务评测
长度外延能力不足是制约大模型成文本能力的普遍问题。智源团队对多个语言模型处理超长文本的注意力分布做了可视化分析,发现所有的语言模型均存在固定的相对位置瓶颈,显著小于上下文窗口长度。
为此,智源团队创新提出 NLPE(Non-Linearized Position Embedding, 非线性位置编码)方法,在 RoPE 方法的基础上,通过调整相对位置编码、约束最大相对长度来提升模型外延能力。在代码、中英文Few-Shot Leaning、电子书等多个领域上的文本续写实验显示,NLPE 可以将 4K 的 Aquila2-34B 模型外延到 32K 长度,且续写文本的连贯性远好于 Dynamic-NTK、位置插值等方法。
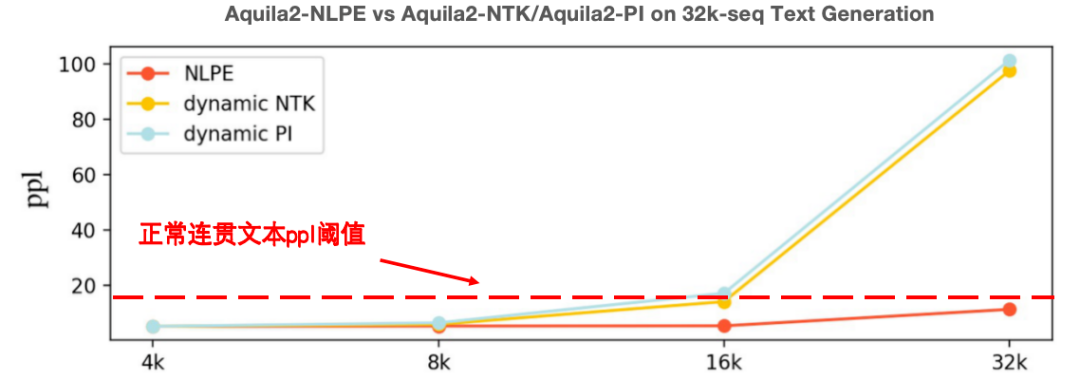
图:NLPE与主流Dynamic-NTK外延方法在Base模型上的能力对比(ppl值越低越好)
此外,在长度为 5K~15K 的 HotpotQA、2WikiMultihopQA 等数据集上的指令跟随能力测试显示,经过 NLPE 外延的 AquilaChat2-7B(2K)准确率为 17.2%,而 Dynamic-NTK 外延的 AquilaChat2-7B 准确率仅为 0.4%。
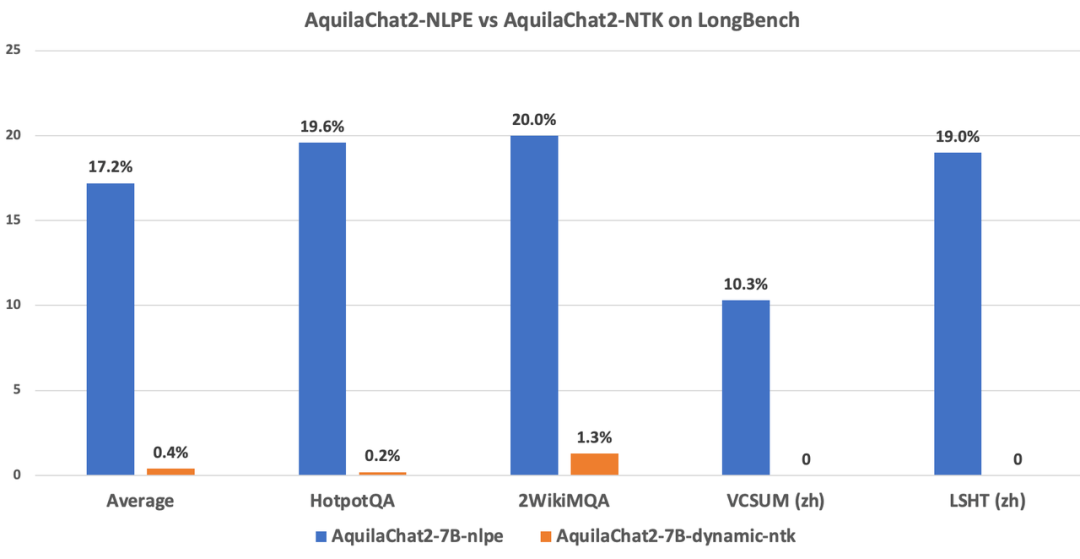
图:NLPE与主流Dynamic-NTK外延方法在SFT模型上的能力对比
同时,智源团队开发了适配长文本推理的分段式Attention算子 PiecewiseAttention ,高效地支持 NLPE 等面向 Attention Map 的优化算法,进一步减少显存占用、提升运算速度。
3. 强大的泛化能力,适应各类真实应用场景
强大的泛化能力对于大语言模型至关重要,它意味着模型能够有效地应对未见过的数据与新任务,而不仅仅仅在标准测试中表现出色、但在实际应用中表现不佳,陷入“高分低能”的陷阱。
3.1 利用 AquilaChat2 强大推理能力打造智能体(AI agent)
3.3 AquilaSQL:最优“文本-SQL语言”生成模型
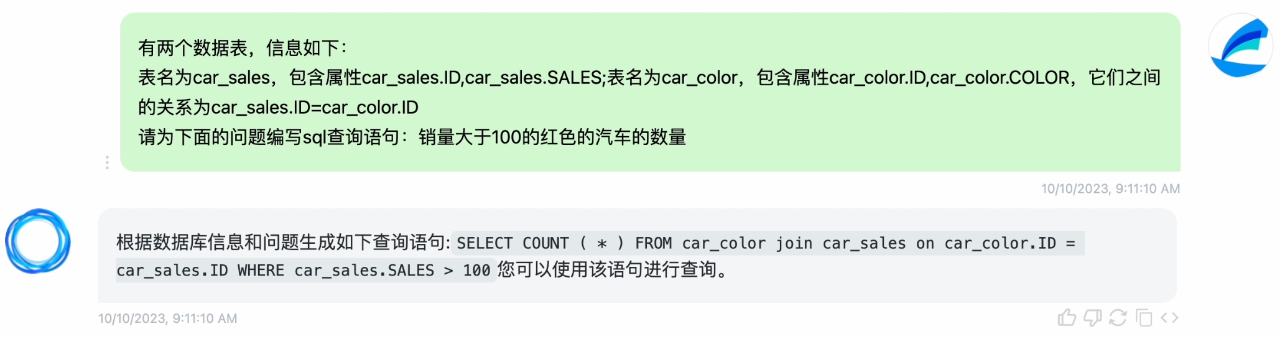
图:AquilaSQL 生成多表查询语句
「全家桶」级别开源,Aquila2 创新训练算法同步开放
作为中国大模型开源生态的代表机构,智源早在 2022 年即开始前瞻性布局,着力打造FlagOpen飞智大模型技术开源体系。
不止于明星模型,智源毫无保留地持续贡献大模型全栈技术开源开放,带来一系列包括算法、数据、工具、评测方面的明星开源项目,真诚拥抱与回馈全球社区。
1. FlagScale 高效并行训练框架
FlagScale 是 Aquila2-34B 使用的高效并行训练框架。提供一站式语言大模型的训练功能。
智源团队将 Aquila2 模型的训练配置、优化方案和超参数通过 FlagScale 项目分享给大模型开发者,在国内首次完整开源训练代码和超参数。
FlagScale 基于 Megatron-LM 扩展而来,提供了一系列功能增强,包括分布式优化器状态重切分、精确定位训练问题数据以及参数到Huggingface转换等。经过实测,Aquila2 训练吞吐量和 GPU 利用率均达到业界领先水平[1][2]。
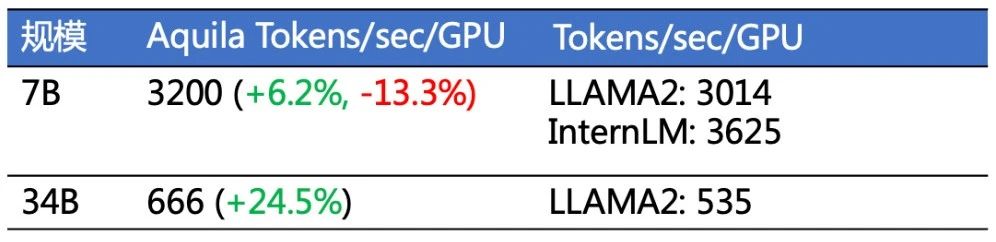
图:FlagScale 训练吞吐量与GPU利用率
(数据来源和估算公式见文末)
FlagScale 开源代码仓库:
此外,FlagScale 采用了多种并行技术如数据并行、张量并行和 1F1B 流水线并行等,加速训练过程,并使用 BF16 进行混合精度进行训练。在性能优化方面,FlagScale 采用了 FlashAttn V2、计算与通信重叠、梯度累积等技术,显著提升了计算效率。
2. FlagAttention 高性能 Attention 开源算子集
FlagAttention 是首个支持长文本大模型训练、使用 Triton语言开发的高性能Attention开源算子集,针对大模型训练的需求,对 Flash Attention 系列的 Memory Efficient Attention 算子进行扩展。
目前已实现分段式 Attention 算子——PiecewiseAttention。
PiecewiseAttention 主要解决了带旋转位置编码 Transformer 模型(Roformer)的外推问题。大模型推理时的序列长度超出训练时最大序列长度时,距离较远的 token 之间 attention weight 异常增高。而 Flash Attention 对 Attention Score 的计算采用分段式的处理时无法做到高效实现,因此智源团队自研了分段式 PiecewiseAttention 算子,大模型开发者可利用该开源算子实现更灵活的 Attention 计算方式。
简单来说,PiecewiseAttention 具备如下特性:
通用性:对使用分段式计算 Attention 的模型具有通用性,可以轻松迁移至 Aquila 之外的大语言模型。
易用性:FlagAttention 基于 Triton 语言实现并提供 PyTorch 接口,构建和安装过程相比 CUDA C 开发的 Flash Attention 更加便捷。
扩展性:同样得益于 Triton 语言,FlagAttention 算法本身的修改和扩展门槛较低,开发者可便捷地在此之上拓展更多新功能。
基于 Triton 开发的 FlagAttention 具备更好的开源开放能力,轻松适配各种 AI 硬件,目前已在英伟达及天数智芯硬件上完成支持[3]。未来,FlagAttention项目将继续针对大模型研究需求,支持其他功能扩展的 Attention 算子,进一步优化算子性能,并适配更多异构AI硬件。
3. BGE2 新一代语义向量模型
新一代BGE语义向量模型将随 Aquila2 同步开源。BGE2 中的 BGE - LLM Embedder 模型集成了“知识检索”、“记忆检索”、“示例检索”、“工具检索”四大能力,首次实现了单一语义向量模型对大语言模型主要检索诉求的全面覆盖。结合具体的使用场景,BGE - LLM Embedder将显著提升大语言模型在处理知识密集型任务、长期记忆、指令跟随、工具使用等重要领域的表现。
https://arxiv.org/pdf/2310.07554.pdf
https://huggingface.co/BAAI/llm-embedder
快速上手 Aquila2 系列模型
使用方式一(推荐):通过 FlagAI 加载 Aquila2 系列模型
https://github.com/FlagAI-Open/Aquila2
使用方式二:通过 FlagOpen 模型仓库单独下载权重 https://model.baai.ac.cn/ 使用方式三:通过 Hugging Face 加载 Aquila2 系列模型
https://huggingface.co/BAAI
LoRA/QLoRA:轻量化的模型微调训练技术,既加速了大模型训练,同时也降低了显存占用。
vLLM :支持构建高吞吐量的大语言模型服务,支持流式输出,支持单机多卡、分布式并行推理。
llama.cpp:支持非GPU端和4-bit 量化,进一步降低开发者的的使用门槛。
参考资料
[1] LLAMA2吞吐量估算公式:total tokens / (total GPU hours * 3600) ,根据Llama 2: Open Foundation and Fine-Tuned Chat Models论文:1)7B的total tokens为2.0 T, total GPU hours 为184320,代入公式得3014 Tokens/sec/GPU;2)34B的total tokens为2.0 T, total GPU hours 为1038336,代入公式得535 Tokens/sec/GPU。
[2]根据https://github.com/InternLM/InternLM#training-performance可知InternLM 7B的1024卡能达到3625 Tokens/sec/GPU。
[3]当前仅在英伟达RTX3090 和 A100 以及天数的 MR-V100上进行验证。
