
 语音小管家
在语音增强领域,我们一般假设信号中的噪声是加性噪声,因此经过短时傅里叶变化后,在频域观测到的信号可以分解为期望信号S和噪声信号N的和,
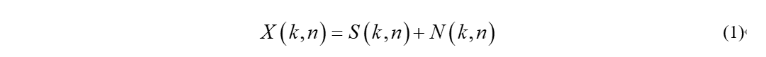
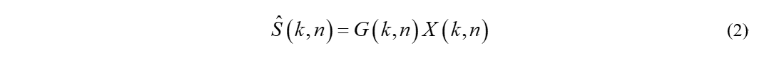
其中G既可以是实数也可以是复数。
📻 Distance-based Loss
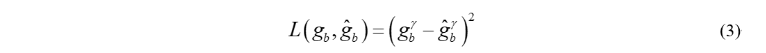
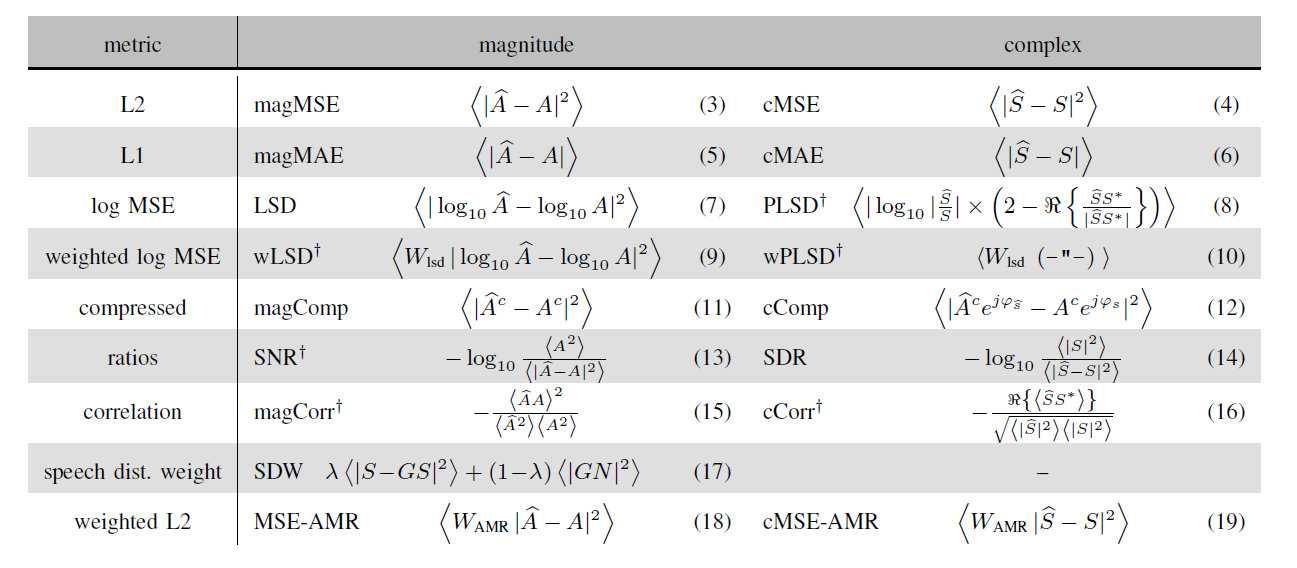
但更为一般的做法是计算估计出来的幅度谱与真实的幅度谱之间的MSE。
我们以L2 MSE的损失函数为例,解析该损失函数如何在语音增强任务中引导模型的学习。首先将损失函数改写为如下形式
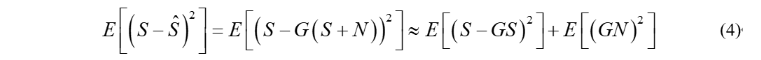
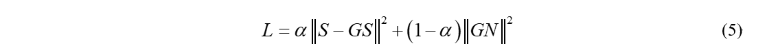
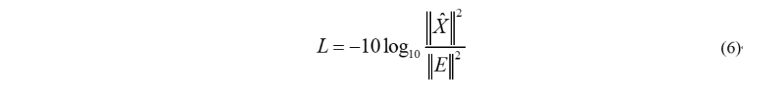
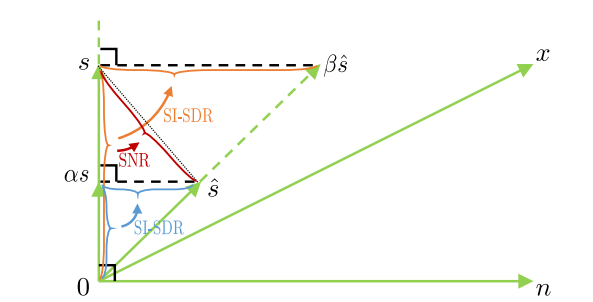
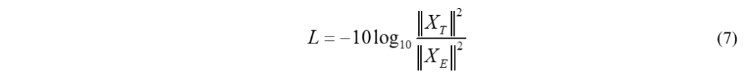
值得注意的是,如果单独使用SI-SDR,可能会导致模型估计输出与输入之间的幅值不稳定,并且如果训练数据中存在0值时,单独使用SISDR时会出现问题,公式计算不稳定,SNR的值都会爆炸,所以一般会结合一定尺度的MSE loss一起使用。除了上面介绍的两种损失函数之外,还有许多基于SNR改造的损失函数,这里就不一一列举了。
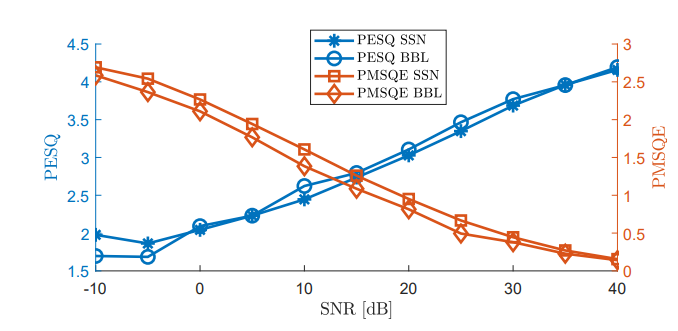
有时候客观指标好了,但是感官不一定好,为了一步到位,有人提出了使用一些符合人们听觉的损失函数。首先让人想到的是PESQ(perceptual evaluation of speech quality),然而尴尬的是PESQ整体计算流程并不可导,秉承着没有条件创造条件也要上的精神,学者们对PESQ计算流程进行改进,提出了PMSQE(perceptual metric for speech quality evaluation)损失函数,遗憾的是与PESQ相同,PMSQE只能针对8kHz/16kHz的信号计算loss,一般都重采样到8kHz进行loss计算。下图是不同信噪比下PESQ和PMSQ的关系,可以看出,PESQ和PMSQE近似成反比,并且相对于SNR具有单调性。
除了PMSQE之外,短时可懂度( short-time objective intelligibilit, STOI)也可以作为语音增强的损失函数,我们知道短时可懂度取值范围从0到1,分数越高可懂度越高,作为损失函数时需要对其加上负号。然而STOI存在一定的缺陷,当测试语音中噪声分量剧烈波动时,STOI与主观测试结果相关性不高,相关系数只有0.47。后来学者们提出了ESTOI( Extended Short-Time Objective Intelligibilit)损失函数来弥补这缺陷。
加入VAD做多任务训练可以辅助模型收敛; 把噪声分量也作为loss的一部分,并给语音和噪声的loss不同的权重,可以balance噪声抑制与语音的保留;
使用MSE时,同时联合幅度谱的loss和复数域的loss会带来提升;
基于compressed的loss比常规的MSE要好,但是压缩系数需要调;
......
优质的数据集比以上几条都重要。
参考文献:
[1]. https://www.microsoft.com/en-us/research/uploads/prod/2021/08/23.pdf
[2]. https://arxiv.org/abs/2212.00369
[3]. https://zhuanlan.zhihu.com/p/436809988
[4]. https://zhuanlan.zhihu.com/p/627039860
[5]. https://arxiv.org/pdf/1909.01019.pdf
