
 语音小管家
项目简介
功能概述
核心组件
YouTube 下载:使用 pytube 从 YouTube 视频或播放列表下载音频。 音频转录:利用 faster_whisper.WhisperModel 将音频转换为文本。该模型是 OpenAI 的 Whisper 的变体,旨在提高速度和准确性。 NLP 处理:可以选择集成 SpaCy 以进行复杂的句子分割,从而增强转录本的可读性和结构。 CUDA 加速:实现对 GPU 利用率的 CUDA 支持,提高兼容硬件的处理速度。
详细工作流程
初始化: 该脚本首先根据 convert_single_video 标志确定是处理单个视频还是播放列表。 它设置必要的目录来存储下载的音频、文字记录和元数据。 环境配置: 将 CUDA Toolkit 路径添加到系统环境以供 GPU 使用。 根据 CPU 核心数配置用于转录的工作线程数量。 视频处理: 对于播放列表中的每个视频或单个视频,脚本都会下载音频。 它确保每个音频文件的唯一命名以避免覆盖。 转录: 音频文件被传递到 WhisperModel 进行转录。 如果可用,该脚本会处理 GPU 加速,否则默认为 CPU。 使用 SpaCy 或基于自定义正则表达式的拆分器将转录结果拆分为句子。 元数据生成: 除了脚本之外,脚本还会生成元数据,包括每个片段的时间戳和置信度分数。 输出: 记录以纯文本、CSV 和 JSON 格式保存,提供原始记录和结构化元数据。 显示/读取: 为了使文字记录更易于阅读,提供了一个 html 文件 transcript_reader.html ,它可以进一步清理并提供“阅读器模式”,您可以在其中选择字体、文本大小、文本宽度和切换深色模式。只需在浏览器中打开此 html 文件,然后粘贴 generated_transcript_combined_texts 文件夹中生成的文件之一的转录文本即可。
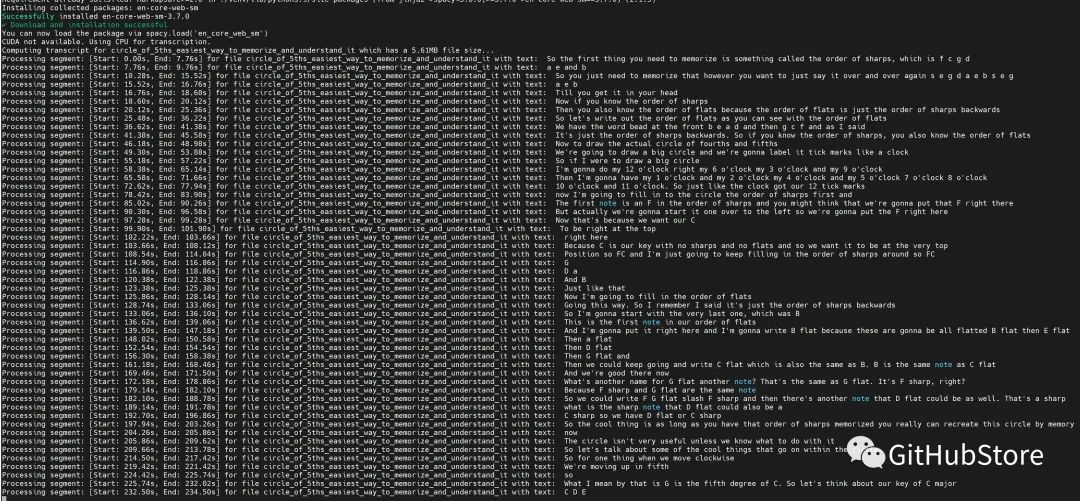
实际操作的屏幕截图
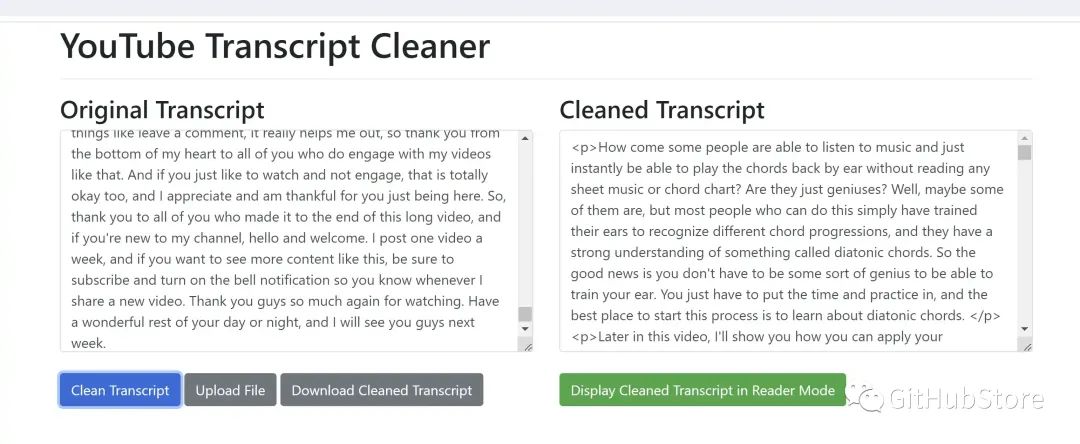
将成绩单文本粘贴到成绩单阅读器 HTML 文件中
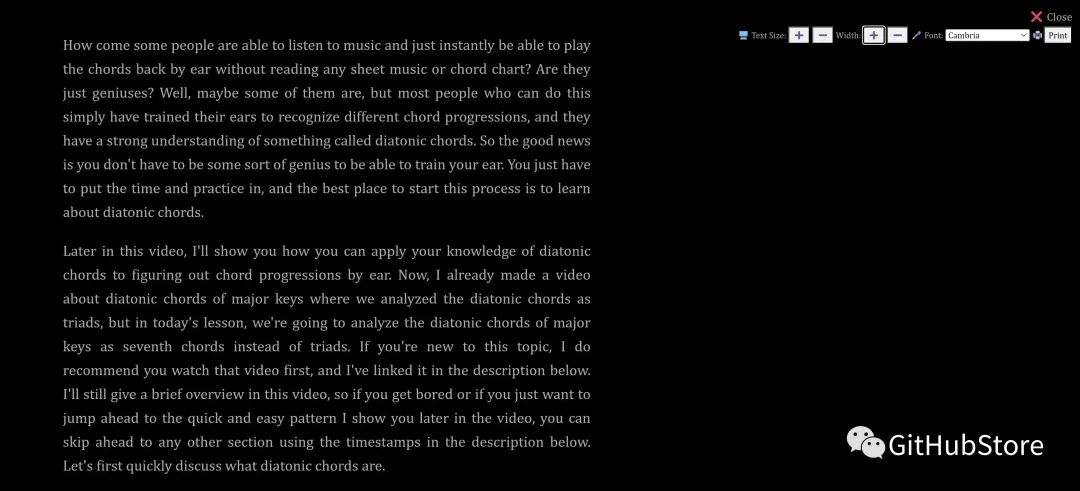
项目链接
https://github.com/Dicklesworthstone/bulk_transcribe_youtube_videos_from_playlist
