语音小管家
目前很多大模型如雨后春笋般涌现出来,作者整理了几个跟数字人项目相关的开源大模型,分享给大家!
AI Voice Chat
地址:https://github.com/WeberJulian/AI-voice-chat
Diffusion Avatars
地址:https://tobias-kirschstein.github.io/diffusion-avatars/(代码还在开发中)
它用来合成一个高保真的3D头像,提供对姿势和表情的控制。
将表情传输到3D头像动画
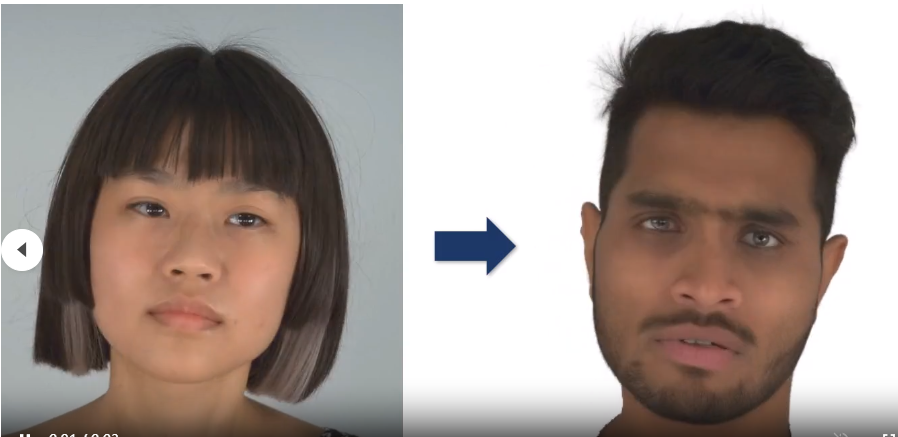
通过 NPHM 制作头像动画
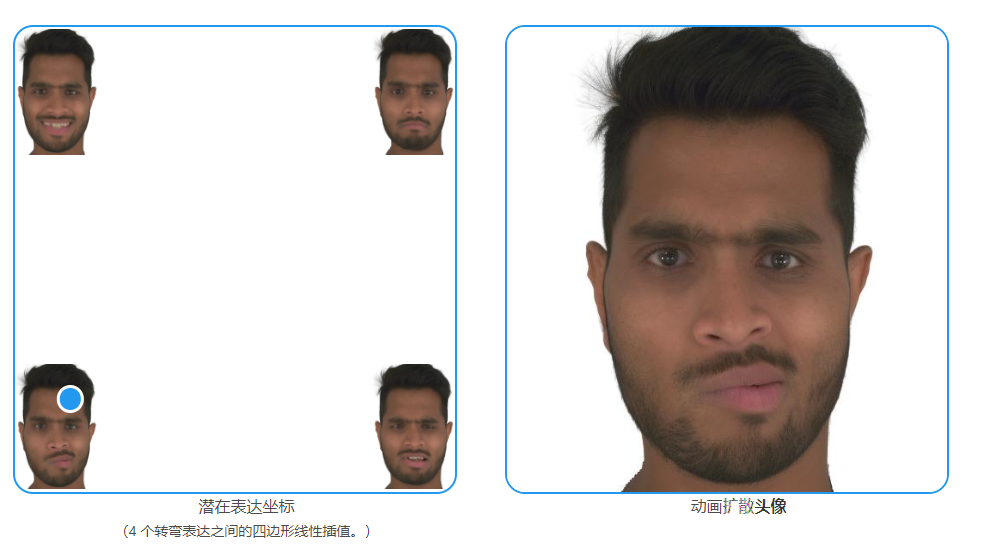
通过底层 NPHM 进行控制。我们通过在几个目标表达式之间进行插值来获得表达式代码 zexp 。使用光栅化和我们基于扩散的神经渲染器,表达代码被转换为具有视点控制的现实化身。
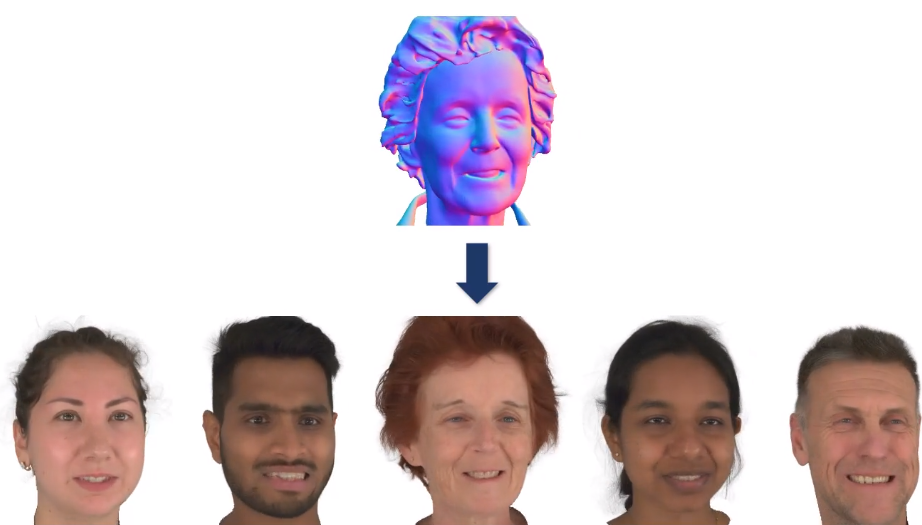
自己制作头像动画
PoseGPT
地址:https://yfeng95.github.io/posegpt/(代码还在开发中)
通过对话的方式实时生成3D人物姿态。
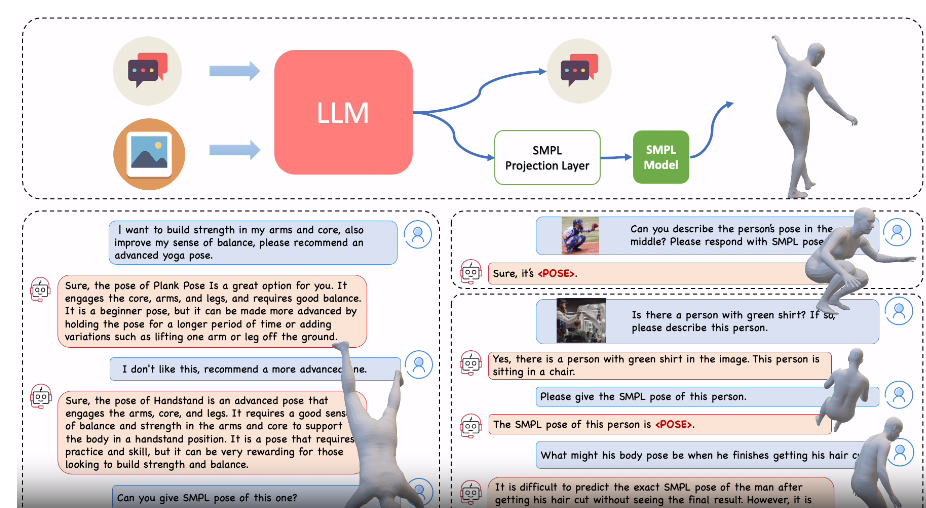
这是一个采用大型语言模型 (LLM) 来从图像或文本描述中理解和推理 3D 人体姿势的框架。源于人类从单个图像或简短描述中直观地理解姿势的能力,这是一个将图像解释、世界知识和对肢体语言的理解交织在一起的过程。传统的人体姿势估计方法,无论是基于图像的还是基于文本的,通常缺乏整体场景理解和细致入微的推理,导致视觉数据与其现实世界含义之间的脱节。PoseGPT 通过将 SMPL 姿势嵌入为多模态 LLM 中的独特信号标记来解决这些限制,从而能够从文本和视觉输入直接生成 3D 身体姿势。从而促进两项高级任务:推测性姿势生成和姿势估计推理。这些任务涉及推理人类从微妙的文本查询中生成 3D 姿势,可能还伴有图像。我们为这些任务建立了基准,超越了传统的 3D 姿态生成和估计方法。此外,PoseGPT 能够基于复杂推理理解和生成 3D 人体姿势,为人体姿势分析开辟了新的方向。
Animate Anyone
地址:https://humanaigc.github.io/animate-anyone/
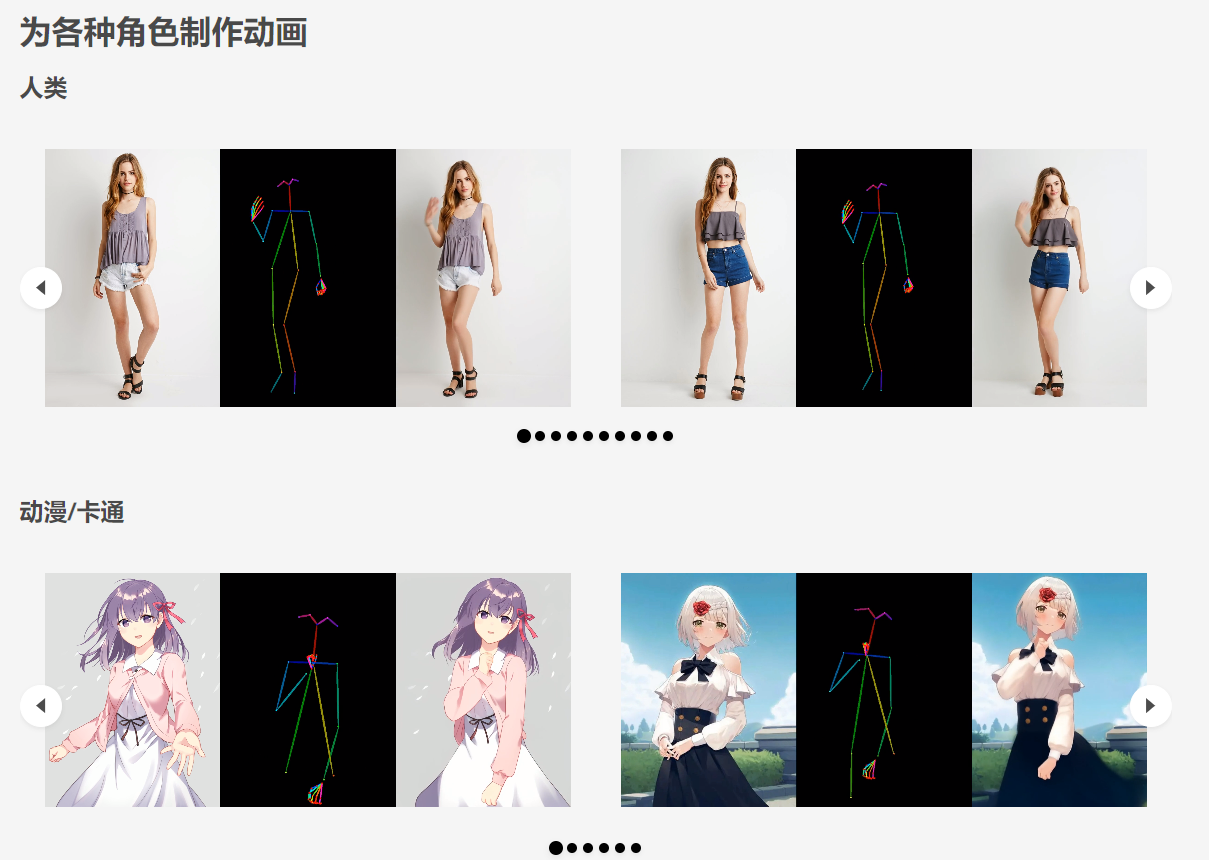
从文本到3D模型的流程
做成动画:https://runwayml.com/
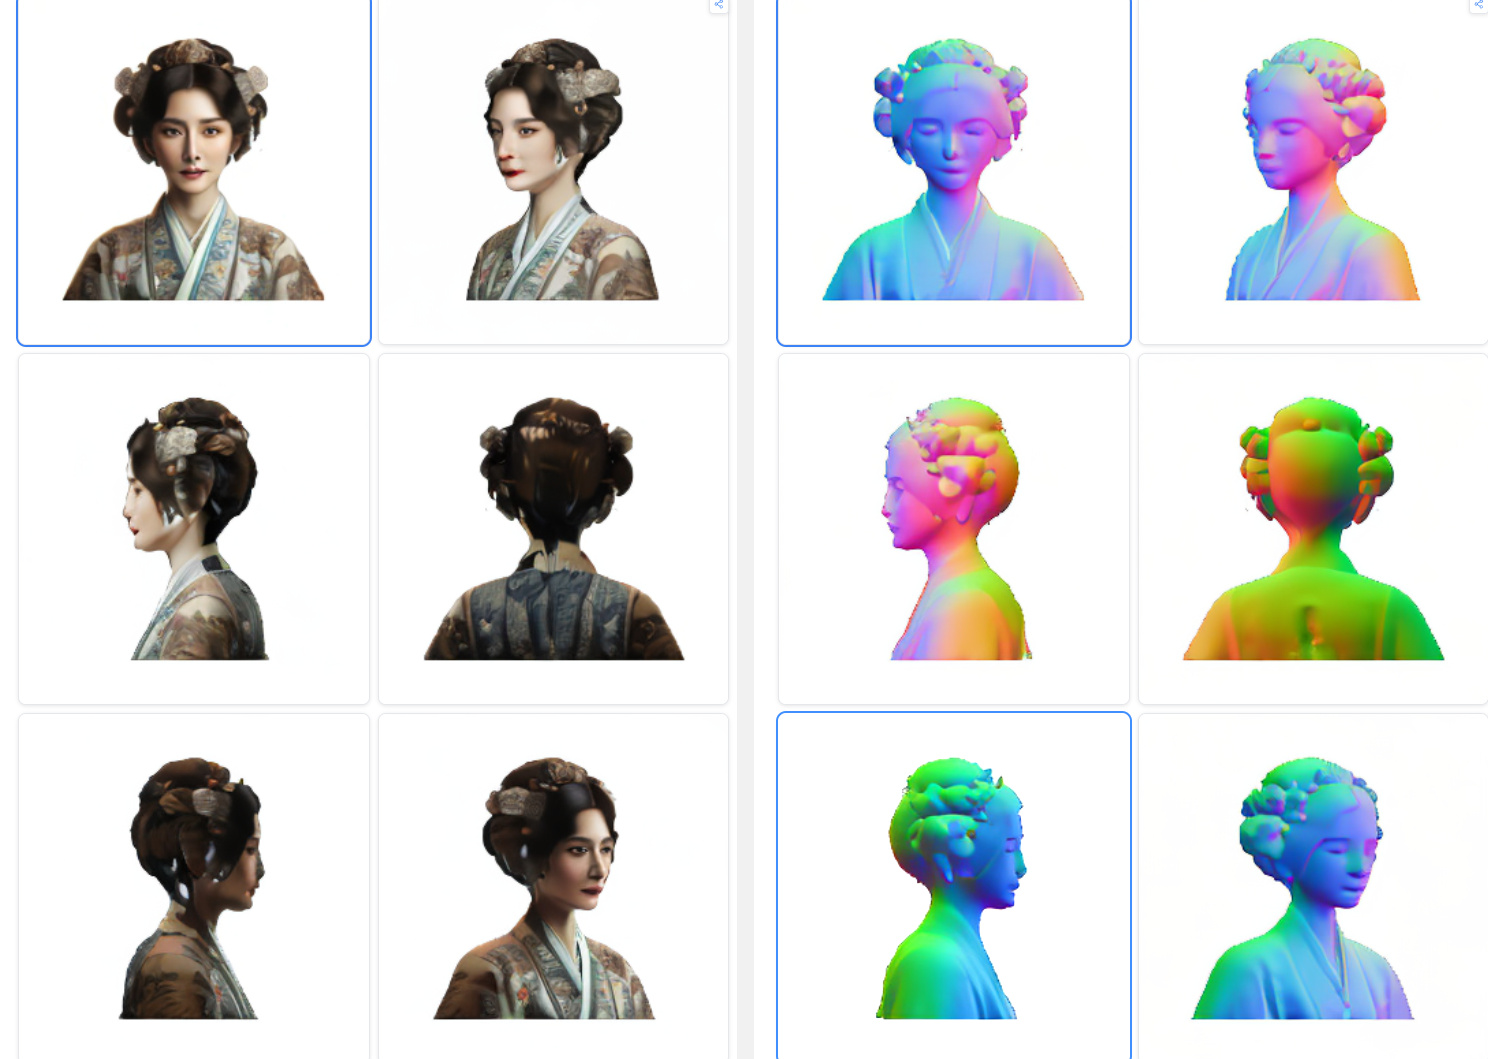
图生成法向图导入Blender处理
地址:https://huggingface.co/spaces/flamehaze1115/Wonder3D-demo