
 语音小管家
研究背景
泛化性作为深度卷积神经网络在各个领域显著成功的重要因素之一,极大的推进了深度学习的发展。因为人们希望使用深度神经网络训练出来的模型要在未见过的数据分布上也能有一个比较好的表现。通过稳定学习[1],深度神经网络可以学习到更本质的特征,从而提高模型在未见过的数据上的性能。然而,稳定学习在说话人识别中尚未得到充分的关注,但它确实具有巨大的潜力。通过稳定学习的研究和应用,可以提高说话人识别模型的鲁棒性和泛化能力,使其在真实世界的复杂场景下表现更好。这将有助于推动说话人识别技术的发展,并使其在实际应用中更具可行性和可靠性。
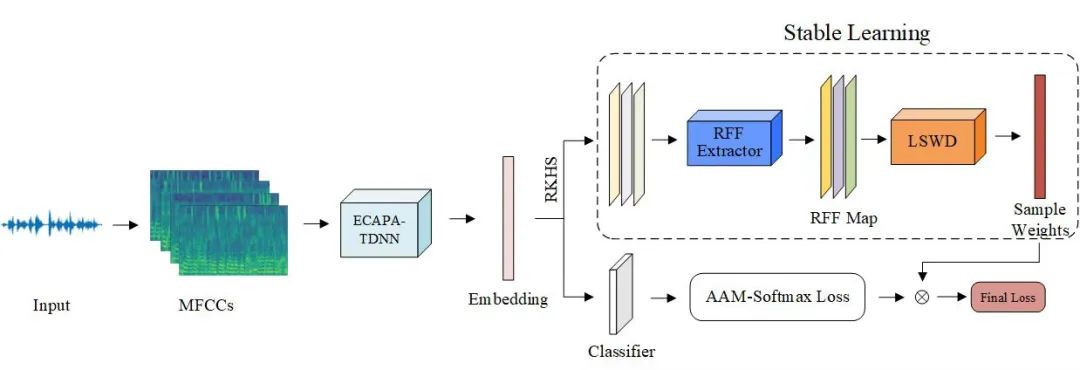
1.稳定学习
使用RKHS (再生希尔伯特空间)将特征从低维空间转换为高维空间,并在该空间中定义协方差算子Σ,则有以下公式:
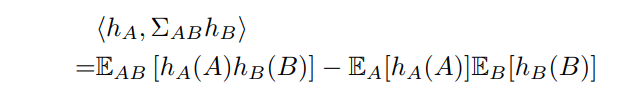
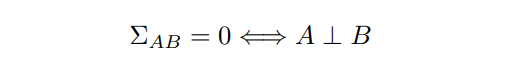
其中,A, B为假设的随机变量,hA和hB表示利用 RKHS 得到的高维空间中的变量。然后独立性就可以由下式确定:
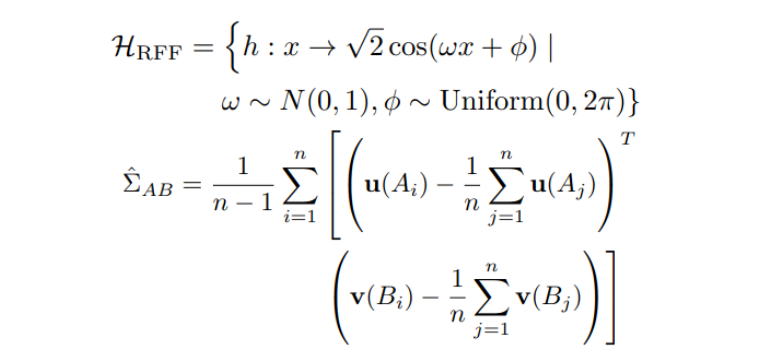
其中,n表示样本数,u和v表示随机傅立叶函数。
在[2]中有相关的理论证明:存在一组权重可以使得所有的输入变量之间变得独立。通过使用样本重加权(模拟采样)来改变不同特征的分布,控制不同特征之间的独立性。
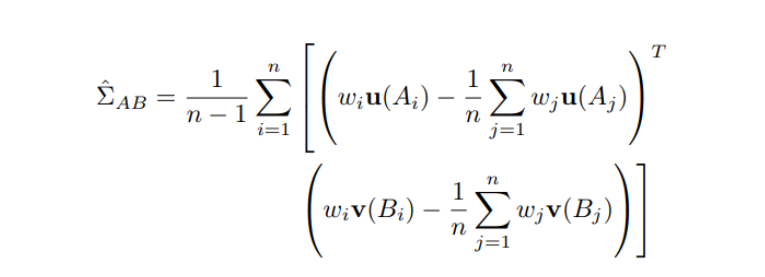
利用voxceleb和cnceleb分别作为训练集进行训练,将librispeech数据集中的test-other(带有噪声)和test-clean(干净语音)作为我们的测试集,我们对测试集的设置与voxceleb和cnceleb中的测试集设置是一样的,都是将每条语音对应着8条语音,其中同一说话人和非同一说话人在这8条语音中各占一半。
实验结果
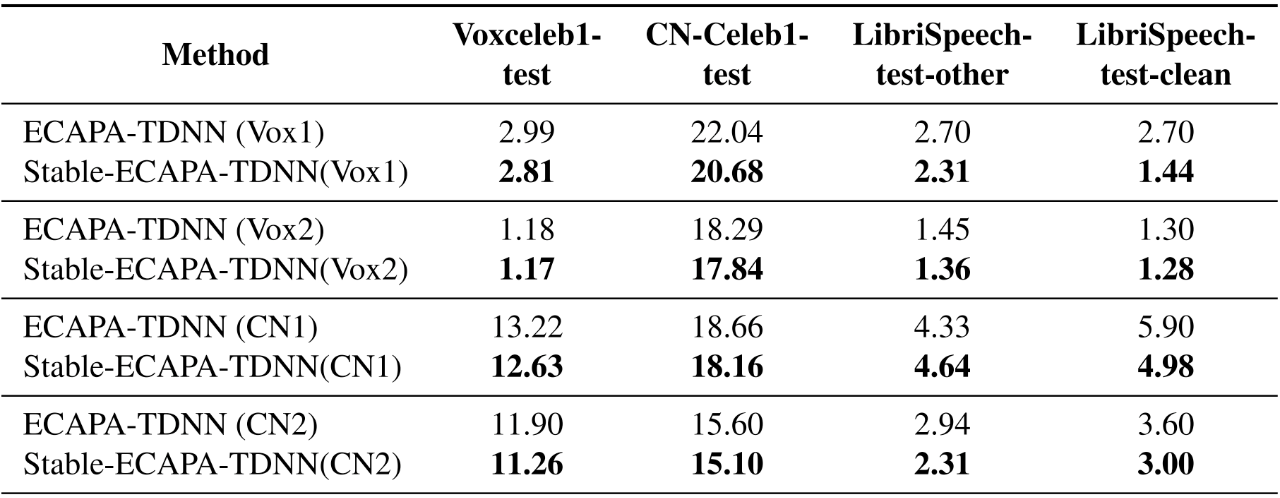
从表1的分析中,我们可以观察到,通过稳定学习得到的模型无论使用哪个数据集进行训练,都能促进正向优化方向。此外,该模型在LibriSpeech测试集上表现出相对稳定的性能提升。当使用VoxCeleb1作为训练集,并在跨数据集的LibriSpeech测试集上进行测试时,与基准相比,我们观察到近50%的显著性能提升。然而,当使用较大的VoxCeleb2数据集进行训练时,我们并没有观察到同样出色的结果。类似地,当使用CNCeleb1作为训练集,并在LibriSpeech测试集上进行测试时,我们观察到0.92个百分点的性能提升。当使用CNCeleb2作为训练集时,提升为0.6个百分点。因此,与大型数据集相比,小型数据集上获得的改进更为显著,这表明稳定学习更适用于具有小型数据集的说话人识别任务。
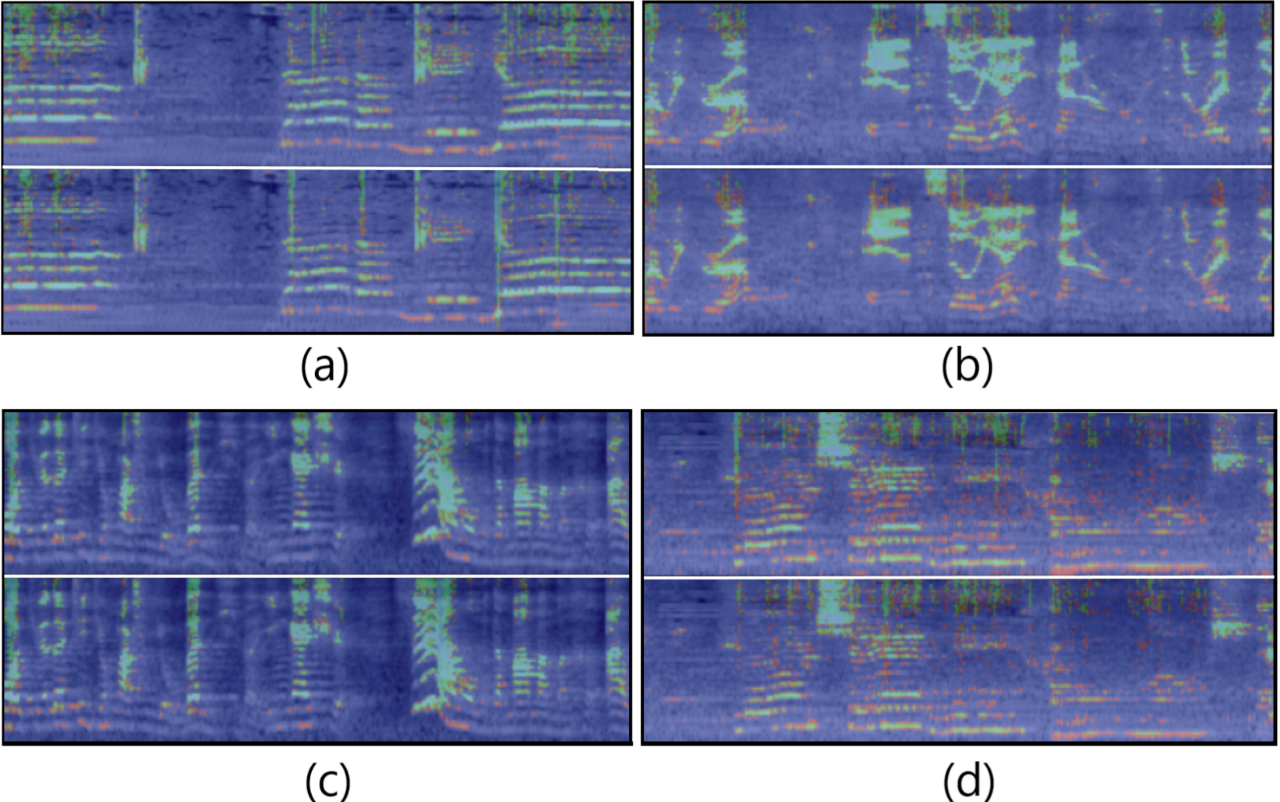
图2. 可视化结果
每张图像的上半部分使用ECAPA-TDNN训练的模型进行可视化,而下半部分使用Stable-ECAPA-TDNN训练的模型进行可视化。红色区域表示模型认为重要的特征,而绿色区域表示次重要的特征。图中用于可视化的音频来自它们各自的训练集。(a)在VoxCele1数据集上训练,(b)在VoxCele2数据集上训练,(c)在CNCeleb1数据集上训练,(d)在CNCeleb2数据集上训练。
通过使用归因算法并可视化[3]结果,可以明显看到稳定学习有助于模型学习更好的声纹特征。结合图2和表1的结果,可以观察到无论使用哪个数据集进行训练,稳定学习都可以提高性能。从图2中,我们可以看到经过稳定学习增强的模型能够更多地关注声纹特征,并减少非声纹特征的干扰。在图2(a)、(b)和(d)中,可以明显看到与ECAPA-TDNN相比,Stable-ECAPA-TDNN的归因结果在非声纹特征(图像顶部的绿色区域)方面有显著减少。此外,在图2(c)中,对比顶部和底部图像可以发现,Stable-ECAPA-TDNN捕捉到了ECAPA-TDNN没有强调的声纹特征。
小结
在本文中,我们通过将样本重新加权的稳定学习思想融入ECAPA-TDNN模型中,对其进行了改进。通过我们的泛化实验结果,改进后的Stable-ECAPA-TDNN在不同数据集上始终实现了稳定的性能提升。此外,根据我们的可视化实验结果,改进后的Stable-ECAPA-TDNN不仅消除了模型对非说话人相关特征的关注,还学习到了基准系统无法捕捉到的说话人特定特征。因此,稳定学习确实有助于模型学习更为重要的特征。尽管稳定学习对说话人识别系统具有积极的优化效果,但根据图2的观察结果,Stable-ECAPA-TDNN仍然关注一些非说话人相关特征。
