
 语音小管家
标题:Improving ECAPA-TDNN Performance with Coordinate Attention
作者:刘双红,宋志达,何亮
单位:新疆大学计算机科学与技术学院、清华大学电子工程系
尽管深度学习在说话人验证方面取得了巨大进步,但仍然存在许多挑战。一个关键的挑战是提取具有高度辨别力的说话人表示。为了解决这个问题,研究人员设计了更复杂的网络结构,如 ECAPA-TDNN和 SE-SCNet。这些模型融合了前沿的卷积单元和多尺度特征提取技术,并巧妙地应用注意力机制来增强其表示能力。虽然 SE[1]注意力机制因其计算效率和显著的性能提升而在说话人验证中受到青睐,但它主要关注通道间关系,忽略了空间、时间和频率信息的重要性。
计算机视觉领域广泛使用的注意力机制如高效通道注意力(ECA)[2]、卷积块注意力模块(CBAM)[3]、坐标注意力(CA)[4]和随机注意力(SA)[5]可能会针对此限制提供补救措施。SE 和 ECA 仅专注于特征张量内的通道注意力。CBAM 不仅捕获通道注意力,还融合了空间注意力。SA 采用随机单元来有效融合空间和通道注意力。CA将来自两个不同空间方向(高度和宽度)的信息独特地编码到通道中,从而能够学习方向敏感和位置敏感的通道注意力。在计算机视觉领域,CA方法的有效性已经得到验证。同时,在音频领域,[6]的研究表明CA可能能够学习时间敏感和频率敏感的通道注意力。传统的通道注意力机制通过全局池化来聚合特征,但这种方法可能会导致时间和频率细节的丢失。为了克服这一限制,CA提出了一种将 2D 自适应平均池化分解为两个 1D 特征编码操作的方法,如下图所示。通过这些步骤,CA 模块能够将频率和时间信息嵌入到通道中,从而有可能增强模型的整体性能。
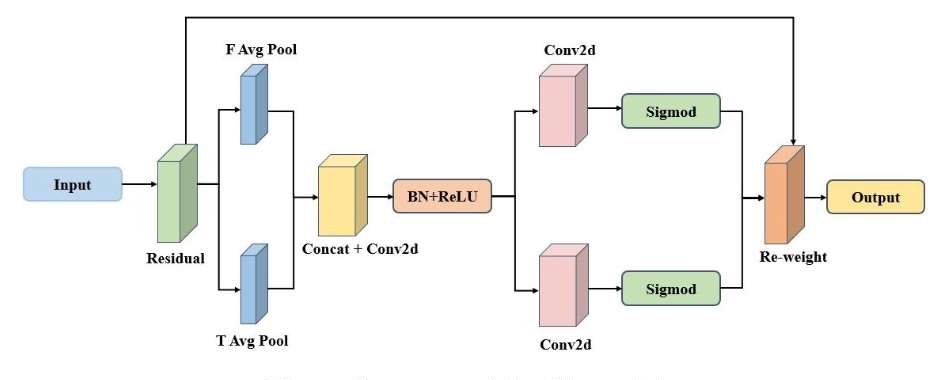
实验结果分析
我们首先通过实验比较计算机视觉领域几种主流注意力机制对于ECAPA-TDNN模型的有效性。接下来,我们重点关注坐标注意力(CA)为 ECAPA-TDNN 模型带来的实质性改进。
表1.使用不同的卷积注意机制在 Voxceleb1-O数据集上的 EER 性能评估
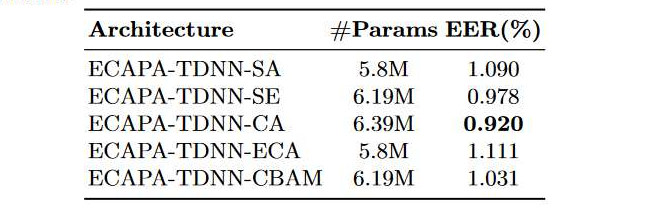
表1的结果显示,通过五种卷积注意机制的初步实验,CA块相较于SE块,有明显的性能优势。这可以归因于 CA 能够同时学习基于时间和频率的注意力,并将这些关键信息嵌入到通道表示中。这强调了联合建模时间和频率信息对于提高说话人验证任务性能的重要性。
表2. VoxCeleb1-O、VoxCeleb1-E 和 VoxCeleb1-H数据集上的模型性能评估
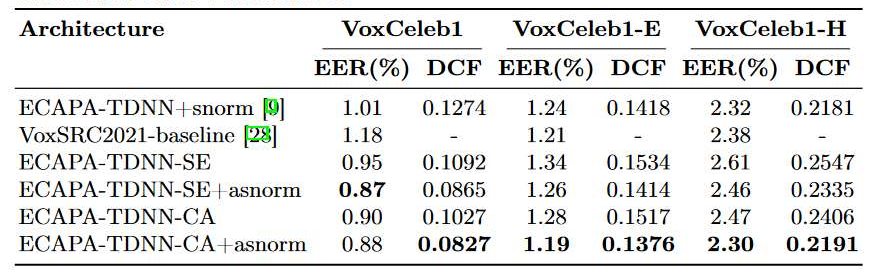
更全面的实验进一步证明了CA 赋予 ECAPA-TDNN 模型更丰富的时间和频率表示,显著提高了其在说话人验证方面的性能。
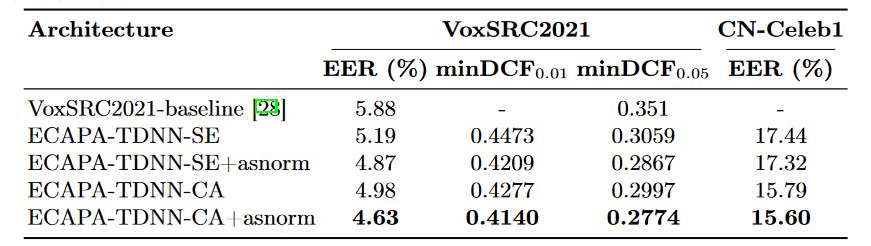
VoxSRC2021 和 CN-Celeb1数据集上的结果展示了CA 块在增强 ECAPA-TDNN 模型泛化能力方面的关键作用。
本文研究了五种卷积注意机制对 ECAPA-TDNN 模型性能的影响。初步实验结果表明,CA 的功效优于 SE。此外,我们在多个测试集上对 CA 和 SE 进行了深入评估。研究结果表明,将ECAPA-TDNN中的SE块替换为CA块可以显著提高模型性能。这不仅强调了将时间和频率信息集成到通道表示中的重要性,而且也证实了CA块可以为ECAPA-TDNN模型提供更丰富的时频表示。此外,CN-Celeb1 的结果凸显了 CA 在增强 ECAPA-TDNN 泛化能力方面的潜在优势。这为ECAPA-TDNN模型的进一步研究和优化提供了新的见解和方法。
