
 语音小管家
标题:Measurement of Rank-based Pruning on Lightweight Speaker Model
单位:新疆大学计算机科学与技术学院、清华大学电子工程系
ResNet是说话人确认任务中的常用架构,但即使是thin-ResNet34和fast-ResNet34也有高达1.4 M的参数[2],这对于嵌入式设备来说过于繁重。为了使其适用于嵌入式设备,我们首先在thin-ResNet34的基础上进行了轻量化改进。Thin-ResNet34主要由重复的基本块组成,每个基本块包含两个标准的CNN卷积层。我们将每个CNN卷积层分解为点卷积层和深度卷积层。深度卷积对每个输入通道应用单个滤波器,但跨越m个时间帧。然后,逐点卷积应用一个1 × 1卷积来组合深度卷积的所有通道的输出,但在每个时间帧独立操作。一个标准的卷积将输入特征进行组合,并在一个步骤中生成新的输出特征。另一方面,深度可分离卷积将其分解为两个独立的层:一个用于滤波,另一个用于合并。该方法与标准卷积相比,计算复杂度降低了8 ~ 9倍,而精度仅略有下降。
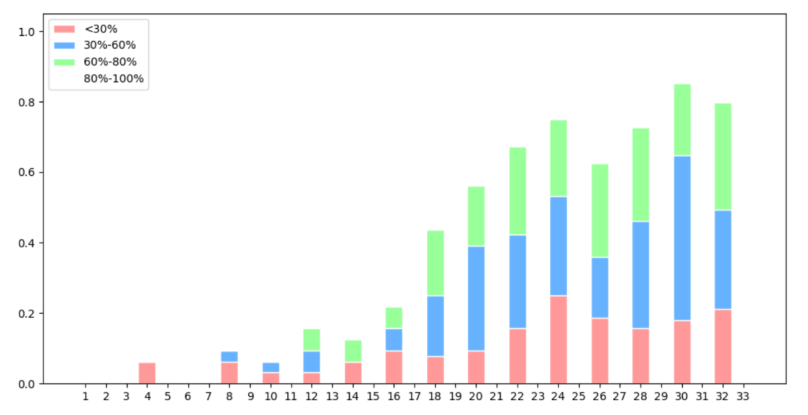
图1. 轻量级模型每一层的特征图的秩,其中白色表示接近满秩的通道占当前层总通道数的比例
实验结果分析
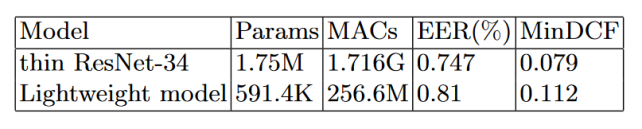
Thin ResNet34及其轻量化模型的通道数分别为16、32、64和128,训练策略也完全相同。与原始的Thin ResNet34相比,轻量化模型的参数量减少了66.2%,计算量减少了85.1 %,在Voxceleb数据集上训练和测试,在测试集上的EER和minDCF与基线相比平均相对降低了7.8%和29.5%。轻量级模型仅有591.4 K的参数量,适合部署在嵌入式设备上。
我们计算了模型每一层输出特征图的秩。这个秩是在模型的每一层的relu单元之后计算得出的。在ResNet34结构中,有33个CNN卷积层,故有33个等级的特征图。在图1中,我们可以发现模型前7层的特征图几乎是满秩,在这些层中,通道维数为16,每个滤波器组都可以提取有效的特征信息。在第8 ~ 15层,少数通道的秩趋近于0,说明对应的滤波器组不能从输入数据中提取有效的特征图。另外,有些滤波器组提取的有效信息非常少,特征图的秩值不能达到满秩值的60%。我们认为这些通道是冗余的,可以被丢弃。在模型的第15层到第27层,可以明显看出每一层的有效通道数在减少,而低秩特征图的数量在不断增加。在这些层中,模型的通道数也多于前几层的通道数,占用了大量的模型参数。但是,在最后几层中,无效通道的数量约占通道总数的50%。此外,我们还可以发现,在所有的奇数层中,模型特征图的秩总是接近满秩。我们推测这是由于ResNet结构中的跳跃连接造成的。从数学上分析,将一个满秩矩阵添加到另一个矩阵中,得到的是另一个满秩矩阵。针对这一特点,我们将模型的通道修剪率设置为前7层为0,8 ~ 15层为0.12,16 ~ 27层为0.25,最后几层为0.5。通过通道剪枝,我们减少了12.4%的参数量,减少了23.4%的计算量,仅损失了1.34%的EER。
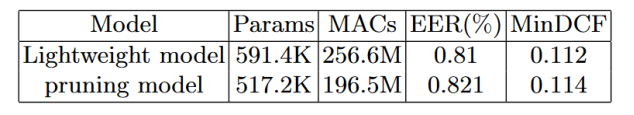
我们首先使用可分离卷积在thin ResNet的基础上进行了轻量化改进,然后以模型每层输出特征图的秩为指导设置基于秩的通道剪枝。与原始的thin ResNet相比,该模型的参数量和计算量分别降低了70.5%和88.6%,EER仅降低了9.9%。
[1] Cai, L., Yang, Y., Chen, X., Tu, W., Chen, H.: Cs-ctcsconv1d: Small footprint speaker verification with channel split time-channel-time separable 1-dimensional convolution. In: INTERSPEECH. pp. 326–330 (2022).
[2] Nagrani, A., Chung, J.S., Zisserman, A.: Voxceleb: a large-scale speaker identification dataset. arXiv preprint arXiv:1706.08612 (2017).
[3] Lin, M., Ji, R., Wang, Y., Zhang, Y., Zhang, B., Tian, Y., Shao, L.: Hrank: Filter pruning using high-rank feature map. In: Proceedings of the IEEE/CVF conference on computer vision and pattern recognition. pp. 1529–1538 (2020).
