
 语音小管家
单位:新疆大学计算机科学与技术学院、清华大学电子工程系
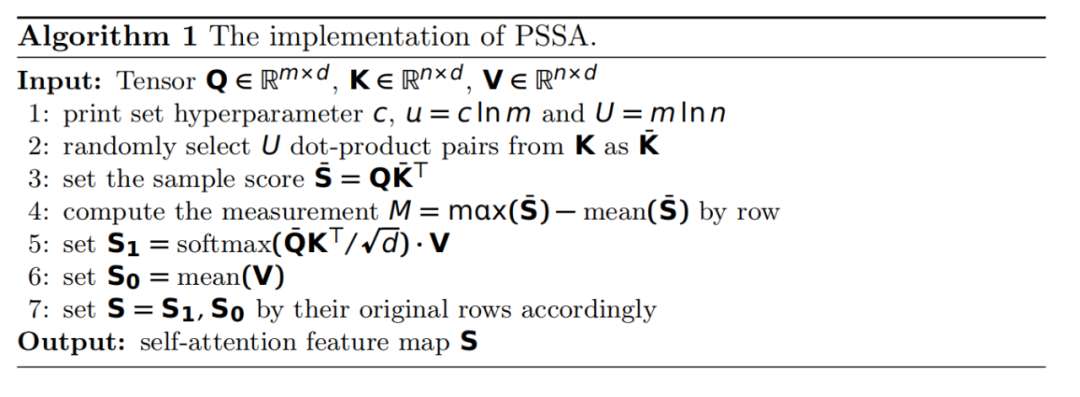
在基于FastSpeech2的个性化语音合成模型中,该模型的计算复杂度为O(n)2,导致训练和推理缓慢。为了解决这个问题,我们引入了PSSA。PSSA的优点是具有O(nlogn)的时间复杂度和内存使用,显著提高了训练速度。基于注意力的长尾分布,筛选出有价值的Q,用平均权重分布表示影响力较小的Q。对于影响较小的部分,我们只需要进行固定计算。PSSA一般可以优化自注意力,筛选重要查询,突出主要特征,提高合成效果。同时,还可以降低模型的复杂度和计算量,从而解决基于FastSpeech2的个性化语音合成模型中的一些关键问题。
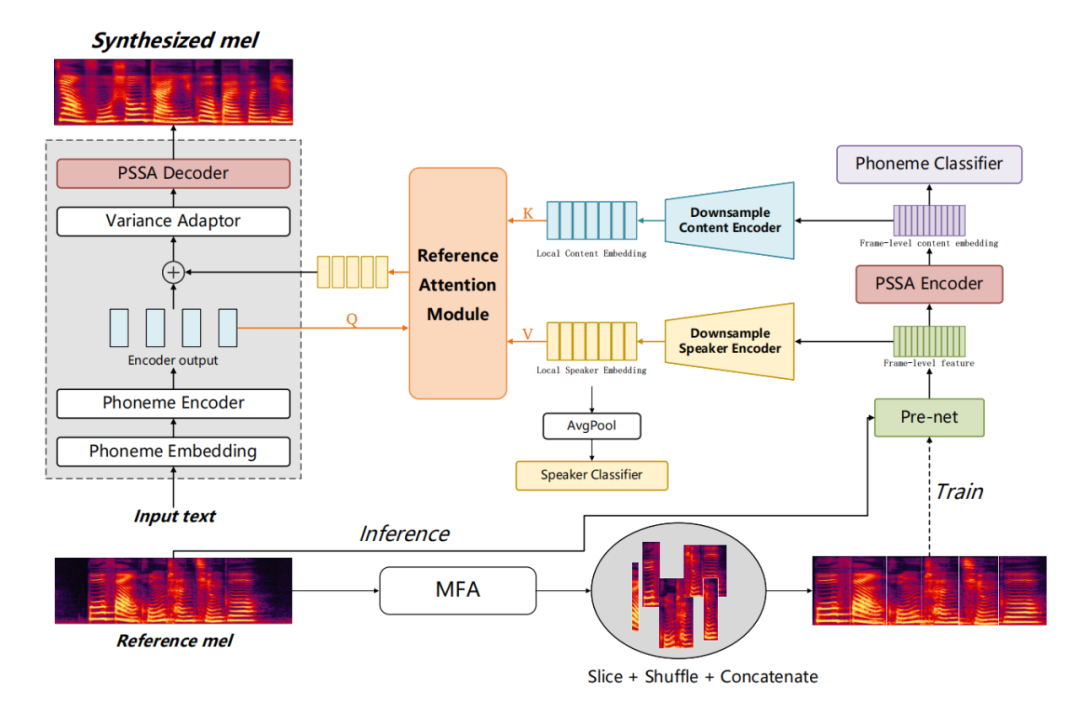
所提出方法的结构如图1所示。首先,我们使用CDFSE[2]作为我们的模型主干,但进行了一些修改。将CDFSE模型的解码器和梅尔编码器中的自注意力机制替换为PSSA。在模型操作过程中,编码器首先从参考梅尔频谱中提取局部内容和说话人嵌入。这些提取的内容和说话人嵌入被视为键和值,然后传递给参考注意力模块。同时,FastSpeech2的音素编码器生成一系列查询。这些查询被发送到引用注意力模块,与键和值进行交互,并产生相应的输出。然后,将此输出添加到音素编码器的输出中,形成一个完整的、内容丰富的表示。最后,将该表示输入到FastSpeech2的方差适配器中,生成与参考语音相同的语音。
传统的自注意力主要由查询、键和值组成,其中第一个注意力被定义为核平滑的概率形式,如公式1所示。自注意力需要内存和二次点积计算的成本,这是预测能力的主要缺点。首先对典型自注意力的学习注意模式进行了定性评估。PSSA得分呈长尾分布,即少数点积对注意力有贡献,其他点积对注意力可以忽略。
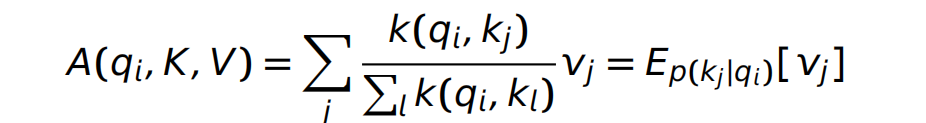
我们将查询稀疏度计算定义为公式2。第一项是所有键的对数和exp (LSE),第二个是算术平均值。
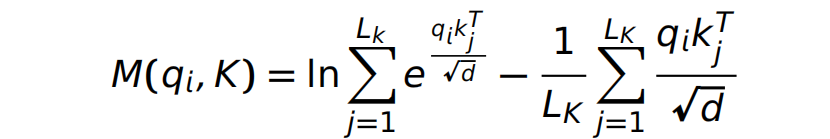
根据建议的度量,我们通过允许每个键只参与u主导的查询来获得PSSA,如公式3所示。PSSA的实现如算法1所示。
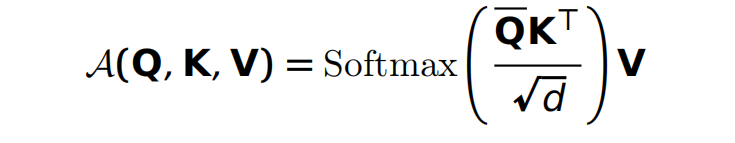
实验结果分析
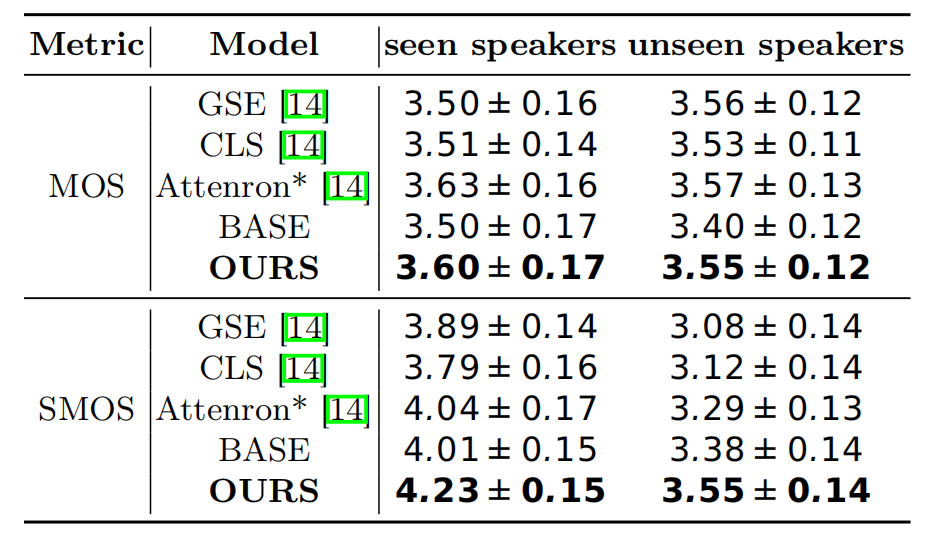
为了评估感知语音合成质量和说话人相似度,我们分别使用MOS和SMOS进行评估。10名母语为汉语的人被要求判断合成语音样本的质量。文本内容在不同的系统中保持一致,以便所有测试人员只检查音频质量,而不考虑其他干扰。我们将我们的模型与四个模型进行了比较。这四个模型分别是CDFSE、两种典型的定长说话人嵌入方法(GSE、CLS)和基于Attentron的变长嵌入方法(Attentron*)。这四种方法也是基于FastSpeech2的。
表1. Aishell3数据集上的语音合成质量和说话人相似性结果
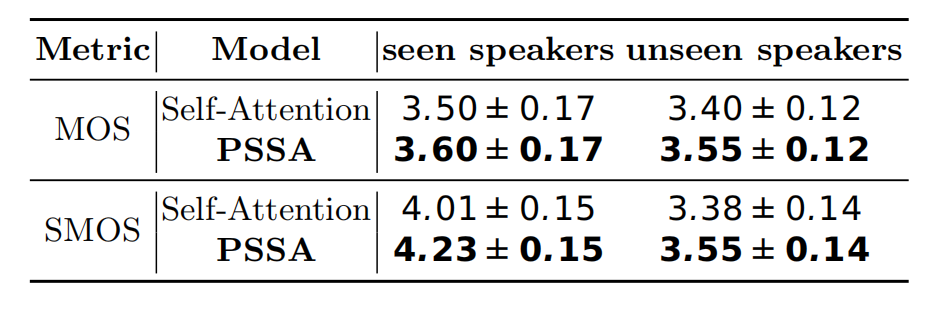
为了检验PSSA结构对模型的重要性,我们将其与自注意模型进行了比较并进行了实验。实验结果如表2所示。实验结果表明,PSSA优于自注意模型,确实提高了模型的综合质量。
合成频谱图与音频展示:
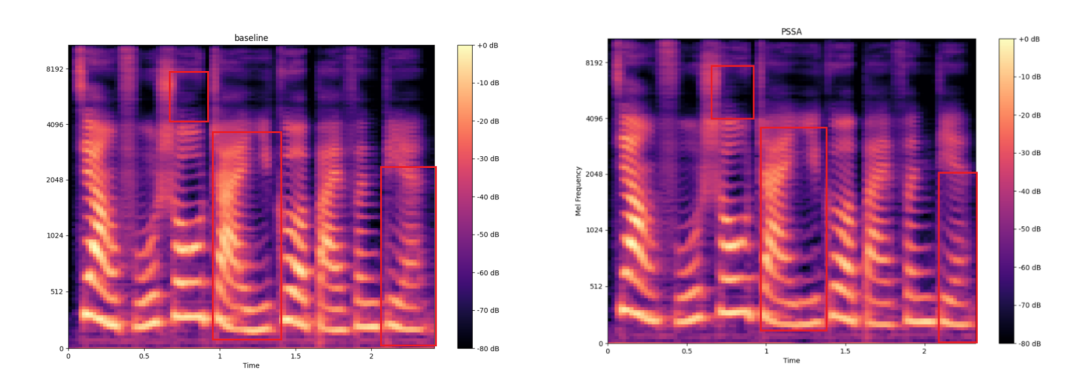
基线的音频:【点击试听】
合成的音频:【点击试听】
本文解决了传统自注意力模块在语音合成中的局限性,并提出PSSA模块作为一种新的解决方案。实验证明了基于pssa的框架的优越性,提高了合成质量,并有效解决了传统自注意力机制在计算复杂度和内存使用方面的困难。
