
 语音小管家
标题:Audio–Visual Fusion Based on Interactive Attention for Person Verification
作者:景雪斌,何亮,宋志达,王少磊
单位:新疆大学计算机科学与技术学院、清华大学电子工程系
尽管说话人验证(SV)和人脸验证(FV)系统取得了显著进展,但它们在更具挑战性的条件下的性能可能会显著降低。在实际应用中,基于语音的SV系统常常面临信道失真或噪声干扰等问题。与此同时,基于图像的FV系统则需应对照明变化、面部运动和姿势变化等挑战。因此,研究人员将注意力转向多模态音视频特征融合,以建立更具鲁棒性的人员验证系统。
目前,最先进的多模态人识别融合模型通过单独的特征提取网络将音频和人脸模态嵌入深度特征空间。然而,这些特征,无论是通过简单连接组合的加权融合,还是使用分数级融合,都缺乏对退化的抗性,难以捕捉特征的质量。理想的视听融合识别系统应同时涵盖音频和人脸模态,并赋予具有更好判别特征的模态更大的权重。权重分配应该稳健,适用于不同音频和人脸特征的个体,考虑到音频和视觉背景的变化,并弥补缺失或损坏的模态。
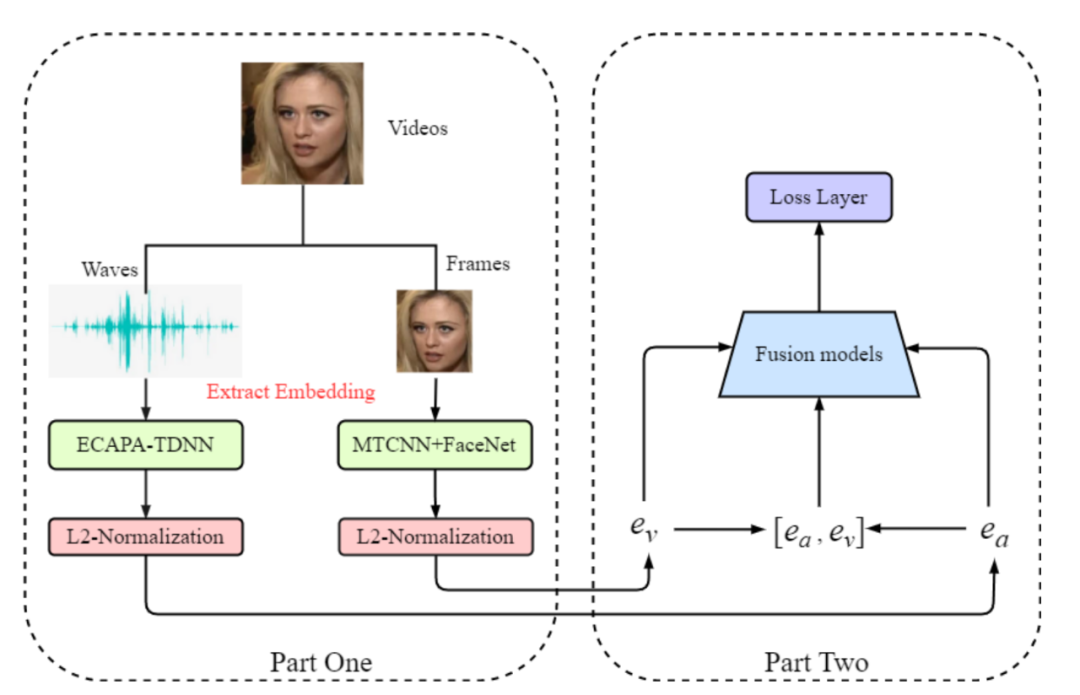
图 1. 本文的整体网络结构由两部分组成。图中左侧部分采用预训练模型提取特征向量。右测部分表示融合模型训练阶段,其中左半部分的输出为右半部分的输入
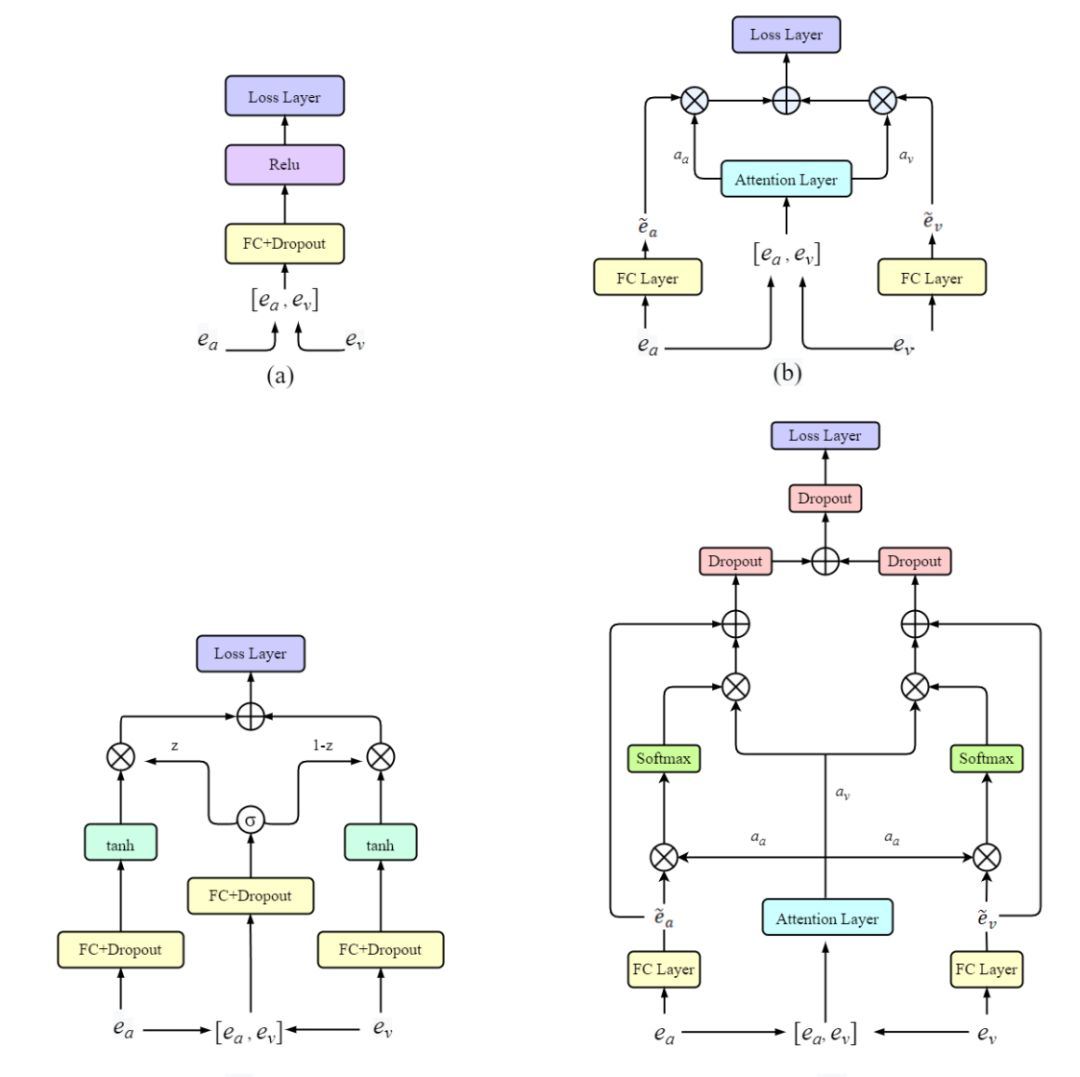
利用单模态模型提取特征向量并将其进行简单拼接的一种融合方法。后接一个包含512个隐藏节点的全连接层,然后接dropout层来防止过拟合,并应用了ReLU激活函数。模型的结构如图2(a)所示。
该方法的优点在于简单易于实现,适合实现快速的多模态特征向量融合,在某些场景下效果良好。它被用作与其他几种融合方法进行性能比较的基线。然而,这种方法的局限性在于,虽然它使用了一个全连接层来整合两种模态的特征向量,但拼接后两模态间的交互性依旧较弱。
这个模型的灵感来自于人类的多感官能力。在人类多感觉系统中,选择性注意力的存在[3],使个体能够从复杂的感观输入中优先考虑和选择关键信息。人类的注意机制根据需要动态地提取显著特征,而不会将整体信息压缩成模糊的概括。本文将注意力机制扩展到关注不同模态间的关系,这种融合模型被称为注意力特征融合(AFF)。模型如图2(b)所示。给定从预训练模型中提取的说话人和人脸特征向量ea和 ev,我们使用注意层 fatt(.)定义不同模态之间的关系,以确定注意分数公式如下:
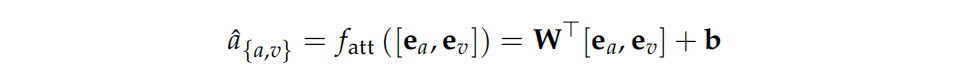
特征向量融合后的输出由加权求和得到 :
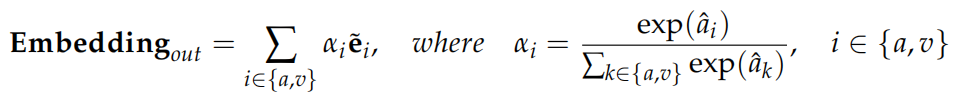
门控多模态单元具有一个有趣的性质,作为一种微观操作,它可以很容易地与其他神经网络结构集成,并且可以使用标准的基于梯度的优化算法进行训练。本文将这一思想扩展到音视频融合中。图2(c)描述了门控式多模态融合体系结构。在这个架构中,给定从预训练模型中提取的说话人和人脸特征向量ea和 ev。使用可学习参数wz计算门向量Z :
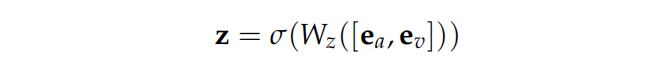
然后,使用门向量z将转化后的ea和ev合并得到Embeddingout,其中⊙表示逐个元素的乘积:
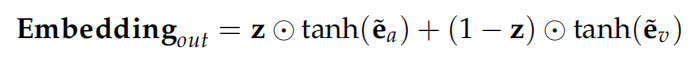
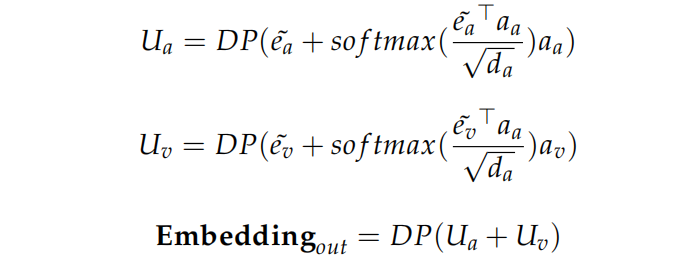
对于音视频融合验证任务,我们采用了VoxCeleb1、NIST SRE19和CNC-AV三个数据集对不同的融合模型进行了详细的实验对比。
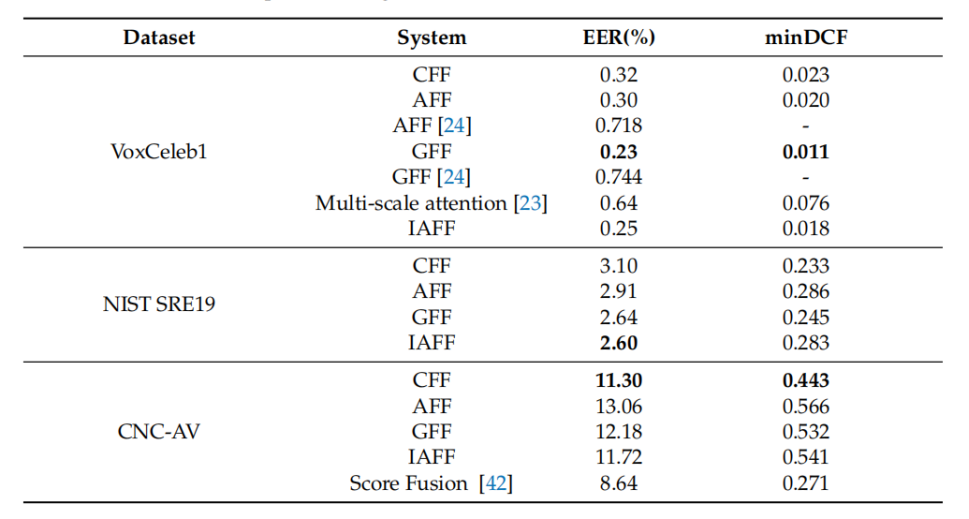
对比其他方法,研究发现在VoxCeleb1测试集上,他们的融合模型优于先前的研究。这可能归因于不同的训练集和实验设置,以及他们的融合模型更好地捕捉多模态数据中的关键特征。然而,在CNC-AV数据集下,与其他方法相比性能不如意,显示出模型在该数据集上的泛化性能有待提高。研究结果表明本文的融合模型在处理多模态数据时具有优势,但对于不同语言的泛化性能仍有挑战。
小结
在这项工作中,探索了四种融合策略用于人员验证的视听多模态融合。在基线系统的基础上,我们设计了三种基于注意力的融合网络: Attention Feature Fusion、Gated Feature Fusion和Inter–Attention Feature Fusion。本文所使用的注意机制均为自注意机制,这意味着它们利用自己的信息来计算注意权重。这与传统的注意力机制不同,传统的注意力机制通常依赖于外部信息来计算注意力权重。通过实验验证,发现这几种融合架构均有效地结合了两种模式的特征,显著提高了系统的人员验证性能。本文首次将交互注意力机制应用于多模态音视频融合验证任务。通过对实验结果的分析比较,我们可以得出以下结论。本研究提出的四种融合模型均显著提高了多模态人验证任务的性能。我们的融合模型与前端特征提取器解耦,允许使用各种预训练模型提取特定于模态的特征向量。因此,我们的融合模型可以推广到其他模态的融合。
[1]Desplanques, B.; Thienpondt, J.; Demuynck, K. ECAPA-TDNN: Emphasized Channel Attention, [1]Desplanques, B.; Thienpondt, J.; Demuynck, K. ECAPA-TDNN: Emphasized Channel Attention, Propagation and Aggregation in TDNN Based Speaker Verification. In Proceedings of the Interspeech 2020, Shanghai, China, 25–29 October 2020.
[2]Schroff, F.; Kalenichenko, D.; Philbin, J. FaceNet: A unified embedding for face recognition and clustering. In Proceedings of the 2015 IEEE Conference on Computer Vision and Pattern Recognition (CVPR), Boston, MA, USA, 7–12 June 2015; pp. 815–823.
[3]Corbetta, M.; Shulman, G.L. Control of goal-directed and stimulus-driven attention in the brain. Nat. Rev. Neurosci. 2002, 3, 201.
