
 语音小管家
随着当前深度学习技术的迅猛发展,基于语音合成和语音转换等技术深度伪造的音频与真实音频之间的差异逐渐缩小,这对当前的深度伪造音频检测技术构成了巨大的挑战。现有的深度伪造音频检测技术通常在训练域内表现出较好的效果,然而,在面对跨域测试环境(如不同的噪声环境、录制设备、压缩方式等)时,性能往往会明显下降。为了提高深度伪造音频检测模型的泛化性,本文提出了一种基于聚集和分散的域泛化方法ASDG。具体而言,本文认为通过不同生成方法产生的伪造音频相较于不同环境的真实音频来说,伪造音频的幅频分布变化较大。另一方面,伪造方法随着时间的推移不断增加,导致训练域中虚假音频的分布无法完全拟合实际的伪造音频分布。基于上述考虑,本文引入了域不变表征学习策略,聚焦于真实语音,旨在多域训练集场景中学习一个真实语音样本不分域聚集,虚假语音样本按域分散的理想特征空间。该算法的流程图如图1所示:
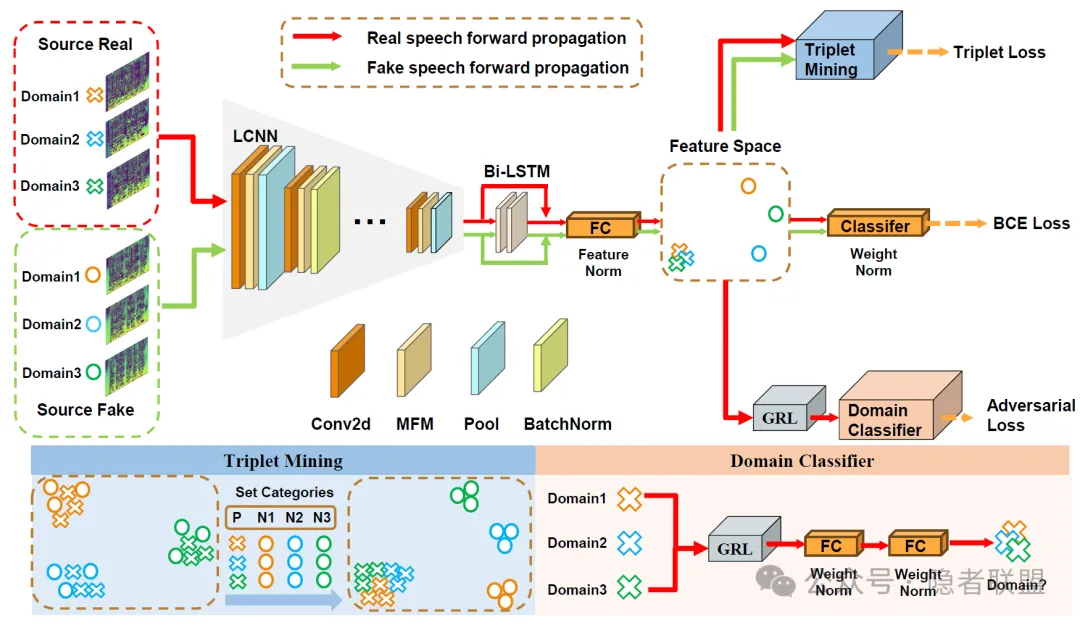
图1 ASDG的框架图
ASDG方法收集了来自三个不同域的英文深度伪造音频数据集作为训练源域,首先通过主干网络和特征归一化模块生成特征空间。对于该特征空间,本文分别通过三元组损失,二分交叉熵损失,域对抗损失进行加权训练。具体而言,三元组损失将虚假域的语音样本按域标签与真实域样本相分离,对抗损失将来自三个域的真实语音样本不分域聚合,二分交叉熵损失完成真实和伪造二分类计算。对于训练策略,本文采用折叠设置,确保训练集的伪造方法在验证集中不可见,以此获得高泛化的模型。
在实验环节,本文选取具有挑战性的跨域评估方式,所有模型均通过三个不同源域的英语数据集进行训练,测试条件C1-C8采用中文数据集,C9为日语数据集,实验结果如图2所示,ASDG模型跨域平均等错误率为5.70%优于所有基线模型,证明了本文方法的泛化性能。ASDG所学习的特征空间如图3所示,经过T-SNE可视化可以看出,ASDG方法学习到了源域真实语音不分域聚集,源域虚假语音按域分散的特征空间,并且对于测试集当中的未知虚假语音样本能形成新的离群簇类,对于训练集外的真实语音样本能够与源域真实语音样本相聚集。
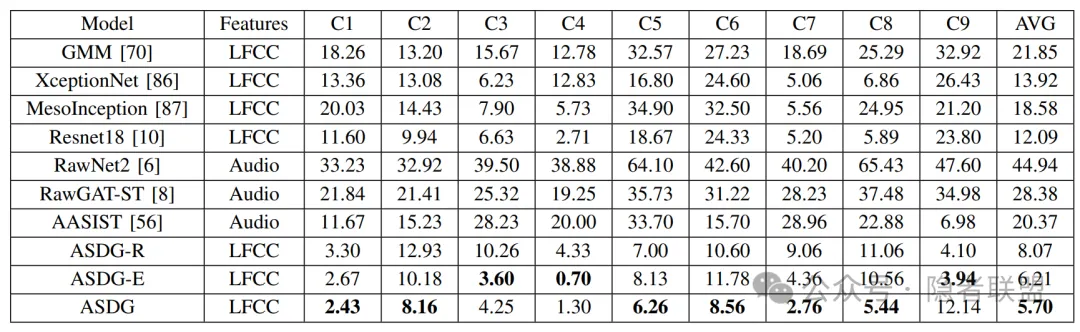
图2 跨域条件下ASDG与基线模型等错误率对比(%)
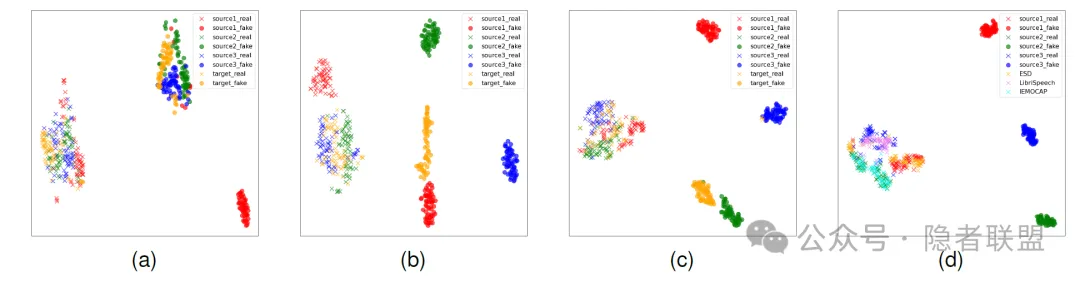
图3 ASDG所学习的域不变特征空间
相关工作发表在IEEE Transactions on Information Forensics and Security,作者为中国传媒大学的谢元坤、程皓楠、王雨田、叶龙。
Y. Xie, H. Cheng, Y. Wang and L. Ye, "Domain Generalization via Aggregation and Separation for Audio Deepfake Detection," in IEEE Transactions on Information Forensics and Security, vol. 19, pp. 344-358, 2024, doi: 10.1109/TIFS.2023.3324724.
本算法已集成在实验室公开鉴伪平台(https://cnvpcuc.com/),欢迎使用。
