语音小管家
《Pattern Recognition》期刊(IF=8.0),属于中科院一区Top期刊,也是模式识别领域最好的期刊之一。该期刊涵盖了模式识别、人工智能、图像处理、专家系统和机器人技术等的方法、技术和应用。《Pattern Recognition》是中国自动化学会CAA推荐A类国际期刊。
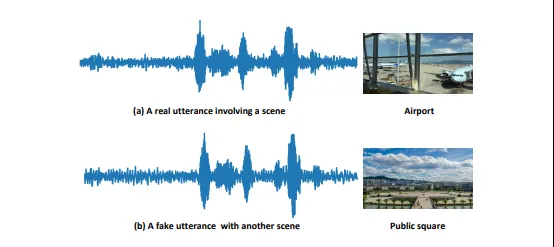
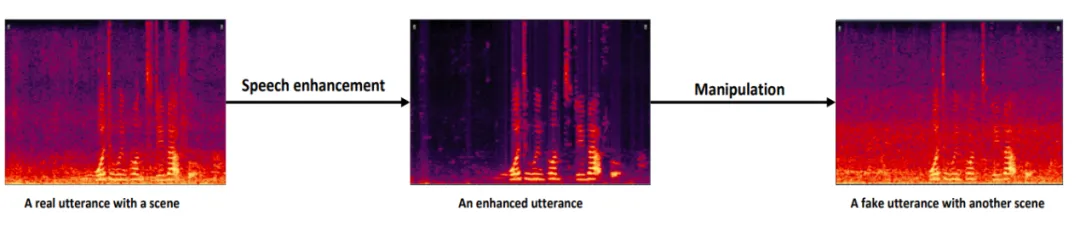
为了推动伪造音频检测技术的发展,研究者已开源不少数据集。之前数据集大多涵盖这样的伪造音频:篡改原始语音中的音色、韵律、内容或信道。实际上,语音中包含的信息非常丰富,除了音色、韵律、内容或信道等,还包含声学场景信息(如:办公室、机场、火车站等)。但是,已有研究工作忽略了声学场景的篡改问题,而不良用途的场景篡改音频对社会危害重大,比如虚假信息传播、交互系统攻击、实时位置定位攻击和妨碍司法取证等。这些数据集忽略了这些数据集忽略了一个情景,即对原始音频的声学场景进行篡改。因此,我们首次提出了场景篡改音频检测的新问题,并设计和构建了一个数据集SceneFake。在这个数据集中,虚假音频是通过语音增强技术实现真实音频的场景篡改。本文提供了SceneFake数据集上音频场景伪造检测的基准结果,并出本分析了语音增强技术和信噪比对检测结果的影响。实验结果表明,基于ASVspoof 2019数据集训练的模型无法可靠地检测场景伪造音频。更进一步,尽管基线模型在SceneFake的已知测试集上表现良好,但在未见测试集上的性能较差。
SceneFake数据集和基线模型源代码已开源。