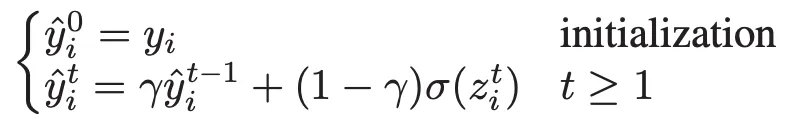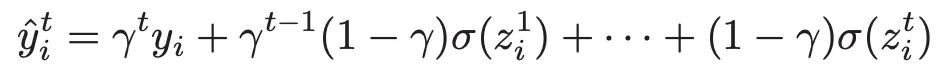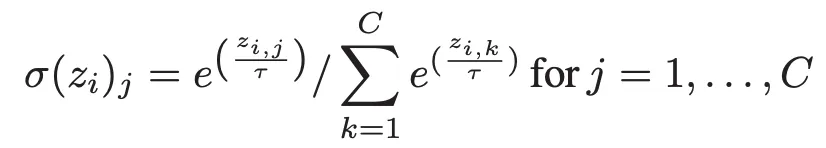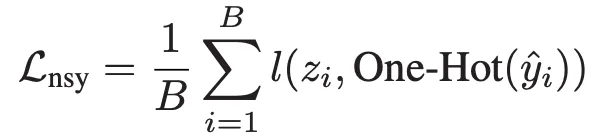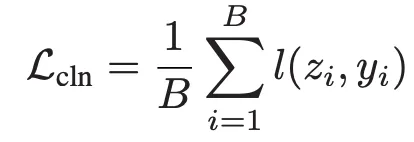论文题目:利用噪声感知的标签集成和样本选择改进说话人验证:学习并矫正噪声说话人标签
作者列表:方志华,何亮*,李琳,胡英
单位:(1)新疆大学计算机科学与技术学院,乌鲁木齐 830017; (2)清华大学电子工程系,北京 100084; (3)厦门大学电子工程系,厦门 361005发表期刊:IEEE/ACM Transactions on Audio, Speech and Language Processing论文地址:https://ieeexplore.ieee.org/document/10542426
有监督的深度学习在说话人验证取得了巨大的成功,但当说话人数据集中包含噪声标签时,深度说话人模型会过度拟合噪声标签。为了减轻噪声标签的不利影响,在本文中,我们提出一种标签集成和样本选择方法。一方面,我们挑选具有高置信度排名的标签作为干净样本;另一方面,我们在训练过程中利用不同epoch的预测平滑地矫正噪声标签。我们的方法不需要分阶段训练,实现了从噪声标签中学习、选择干净标签和矫正噪声标签的集成。大量的实验结果证明我们的方法对噪声标签的鲁棒性。即使在训练数据含有50%的噪声标签时,我们的方法相对于标准训练方法平均能抵消86.54%的性能损耗。
发表论文截图
深度说话人模型的成功依赖于大规模有标注的说话人数据集,然而标注大规模说话人数据集既昂贵又耗时,并且在制作说话人数据集的过程中容易出现噪声标签(也称为标签噪声)。不幸的是,噪声标签通常会导致损失值过大,因此模型会尝试拟合噪声标签来抵消巨大的损失值,导致计算出错误的梯度下降方向。最终模型将记住噪声说话人标签,从而影响提取的说话人embedding的质量。在说话人数据集中含噪声标签时,研究人员大多采用两种方法:挑选干净样本和矫正噪声标签。挑选干净样本往往基于一个共识:具有噪声标签的样本损失值往往比干净的样本更高,因此具有小损失的样本更可能是干净样本。矫正噪声标签的方法通常是将模型预测的类别作为伪标签来计算损失函数。
为了帮助读者更好地理解,我们将带噪声标签的样本称为噪声样本,带干净标签的样本为干净样本。大量的研究表明深度神经网络会先拟合干净样本然后拟合噪声样本。为了验证这一观点,我们在含有18个人的CMU Arctic数据集模拟了不同比例的噪声标签进行了玩具实验,其中训练集含0%到90%的闭集标签噪声,测试集是干净的。从图1可以看出,在训练数据包含噪声标签时,橙色线代表的测试准确率先迅速上升然后逐渐下降,并且噪声标签越多,之后下降的越快,最终的准确率也越低。这表明噪声标签越多,对说话人模型影响也就越大。绿色虚线代表的干净样本准确率上升速度很快,表明说话人模型可以很快学习干净的模式。红色虚线代表的噪声样本准确率只有在绿色虚线走向平稳期后才逐渐上升,这表明在说话人模型在记住绝大多数干净数据之后才开始记忆噪声标签数据,这与之前的研究观点一致。
图1. 在含有D%至9D%的噪声标签的CMU Arctic上使用标准方法训练说话人模型的准确率曲线,测试集不含噪声标签
基于这一特性,一个直观的想法是通过三个阶段解决噪声标签问题:- 阶段一(学习):由于神经网络会先拟合干净数据,将带噪声标签的数据用于说话人模型训练少数epoch可以使模型获得一定的识别能力。
- 阶段二(选择):根据阶段一得到的说话人模型,我们挑选出置信度较高的干净样本,然后只使用干净样本用于模型训练,进一步提升模型的识别能力。
- 阶段三(矫正):经过之前两个阶段可以得到具有较高识别能力的说话人模型和被划分的干净样本和噪声样本。此时我们可以将模型预测作为噪声样本的伪标签。然后将矫正后的噪声样本和干净样本同时用于模型训练直到训练结束。
但是多阶段训练过程比较复杂,此外需要精心控制每个阶段训练的时长。因此,我们提出一种新颖的框架,实现学习(噪声标签)、选择(干净样本)和矫正(噪声标签)的集成。
方法
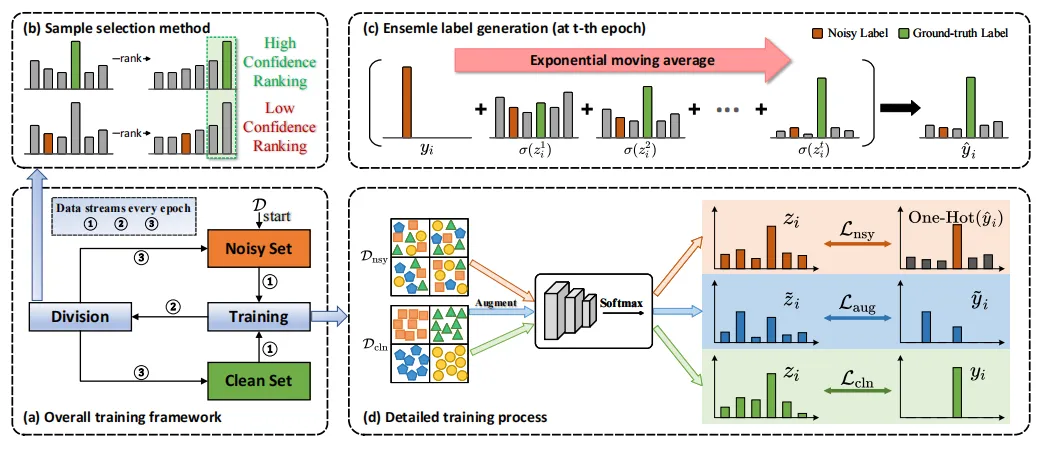
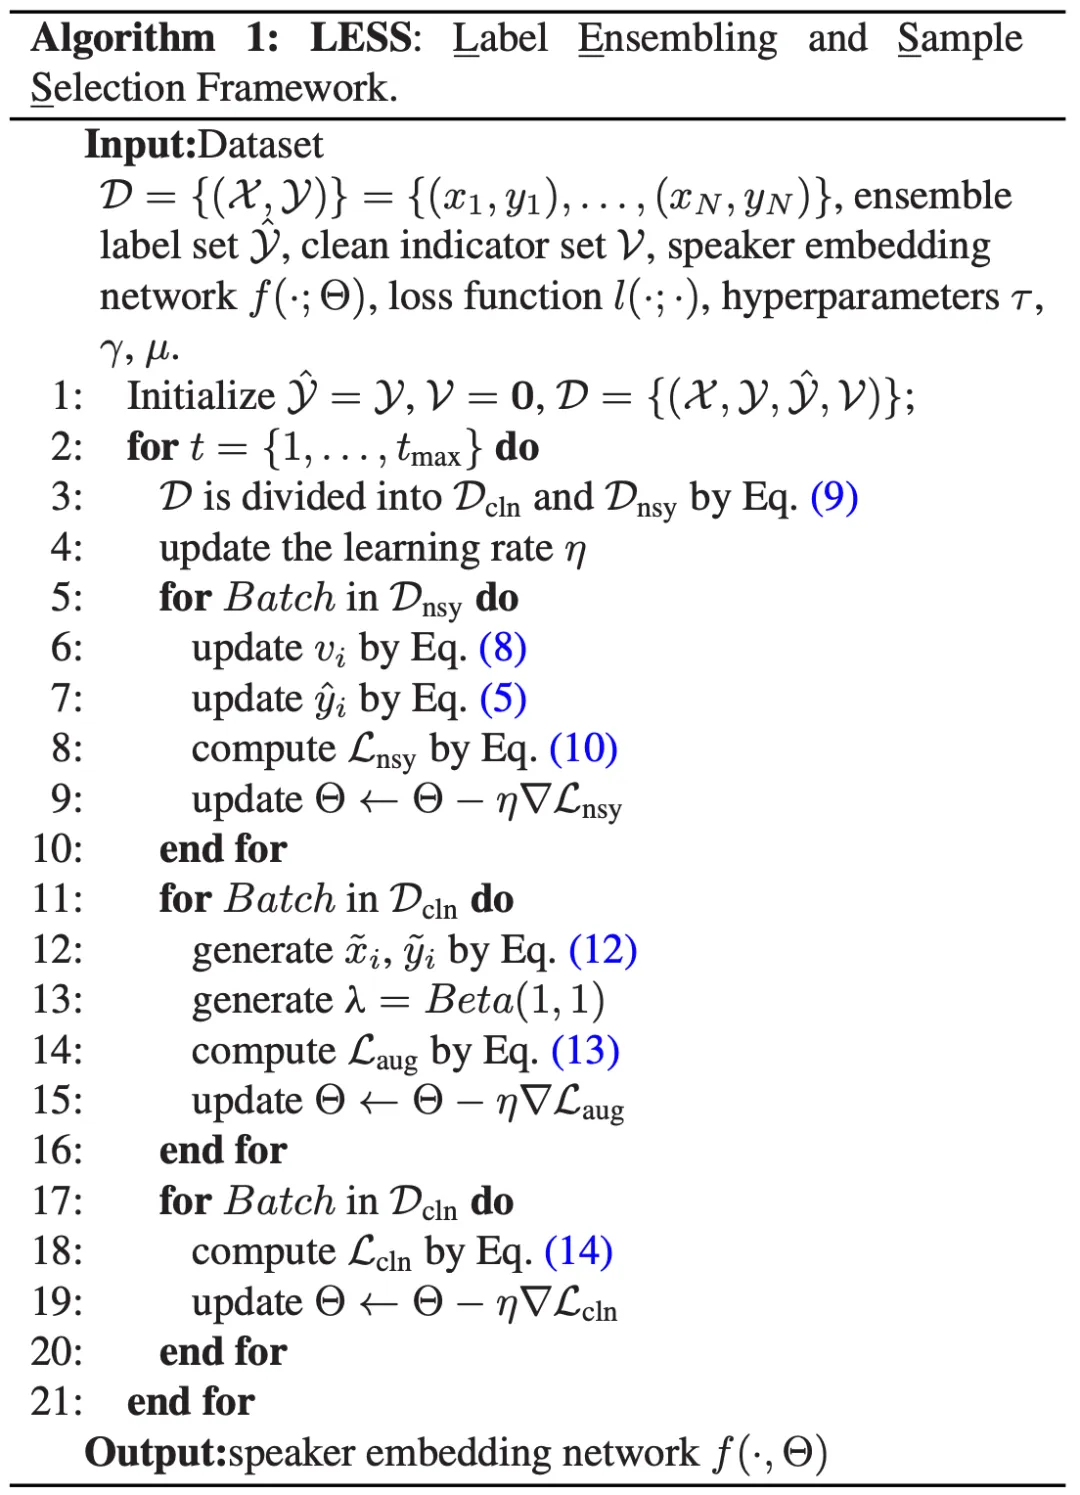
图2. 我们提出的方法的概述(a)整体训练框架 噪声集被初始化为训练数据,干净集为空集。先将模型按顺序在噪声集和干净集上进行训练。然后根据提出的样本选择方法重新划分数据,迭代这个过程直至训练结束(b)样本选择方法。对模型预测置信度进行排序,判断样本标签是否取得高置信度排名(c)集成标签生成 集成标签初始化为原始标签,在训练过程中利用模型预测通过指数移动平均的方式更新集成标签(d)详细训练过程。对于噪声集,使用集成标签进行监督学习 对于干净集,使用原始硬标签进监督 首先进行利用增强的数据训练,然后使用干净数据训练在本文中,我们提出一种新颖的标签集成和样本选择框架(Label Ensembling and Sample Selection,LESS)。首先,标签集成利用训练过程中的模型预测序列迭代地矫正噪声标签生成集成标签。具体对于每个样本来说,集成标签被初始化为该样本原始标签。在训练过程中,我们迭代地将模型对该样本的预测值和集成标签加权相加得到新的集成标签。其次,在训练过程中我们采用高置信度排名准则筛选干净样本。因此,在开始阶段原始标签在继承标签中占主导地位,这相当于从噪声标签中学习。随着模型识别能力提升,干净样本被筛选出来进一步提升模型识别能力,集成标签的准确度也越来越高。标签集成和高置信度排名相辅相成,实现了从噪声标签中学习、选择干净样本、矫正噪声标签三种操作的集成。具体方法如下:上文提到DNN会先拟合干净数据,因此我们试图先将说话人模型从带噪声样本的数据中学习,然后利用具有识别能力的说话人模型矫正噪声标签。但这需要人为设定切换的时机,所以我们提出一种平滑切换从噪声标签中学习到矫正噪声标签的方法,我们将其命名为标签集成(如图2(c)所示)。具体来说我们为每个样本引入一个集成标签,集成标签被初始化为原始标签,在训练过程中将模型输出以指数移动平均的方式更新。集成标签定义如下:可以看出原始标签的权重在训练过程不断减小,因此在早期集成标签被主导。由于深度说话人模型会先拟合干净数据。因此随着训练的进行,模型识别能力在初期不断提升,这个过程是从噪声标签中学习。随着训练进行,模型输出越来越准确,噪声样本的集成标签也更接近地面真值标签,这是矫正噪声标签的过程。锐化:在更新集成标签的过程中,为了提高矫正噪声标签的速度,我们对模型输出进行softmax归一化时加入温度系数来锐化模型输出的的概率分布:之前的研究挑选具有小损失的样本作为干净的样本。然而,不同的损失函数(例如交叉熵和AAM-Softmax)对于同样的模型输出所计算的loss大小不一,导致需要对精心设计阈值。因此,我们提出一种新颖的高置信度排名方法使用最原始的模型输出(logits)来筛选干净样本。
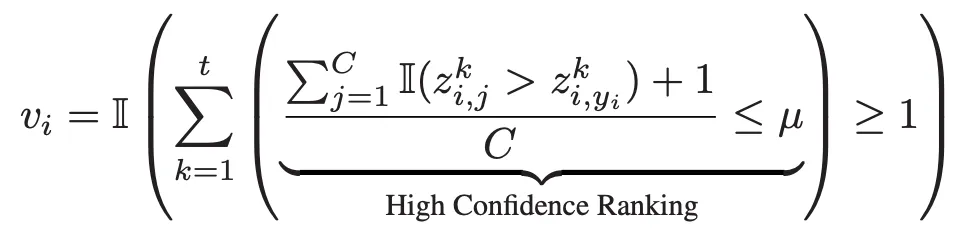
具体来说,预测值可视为模型对不同类别的置信度。如图2(b)所示,我们对预测值进行排序,若样本标签对应的置信度排名较高,就认为该标签是干净的。我们引入筛选阈值,若样本标签的归一化排名低于该阈值,则认为标签取得高置信度排名。此外,我们使用OR-Gate机制提升稳定性,即只要某个样本标签取得一次高置信度排名,在之后的训练该标签都被认为是干净的。公式如下:根据v值我们可将原始数据集划分为干净集合和噪声集合:
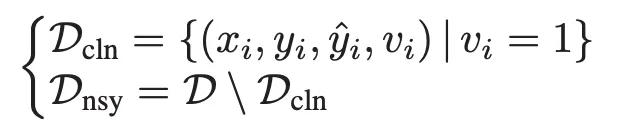
其中 \ 表示集合的差集操作。
图2展示了我们提出的框架。在每一个时代的训练过程中,我们迭代地进行以下过程:1)根据上述公式将数据集划分为噪声集合干净集合,然后将它们打乱。2)对于噪声集:每个样本被输入说话人模型得到输出,根据公式更新干净标记v和集成标签,然后将输出值和硬化后的集成标签计算损失并反向传播。其中,硬化的集成标签具有与熵最大化类似的功能,促进模型的预测为低熵(高置信度)。我们使用独热编码硬化:1)对于干净集:为了有效利用干净的数据,我们通过mixup 进行线性插值生成新的样本,以改善样本的不平衡问题。
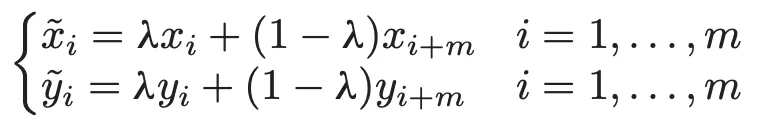
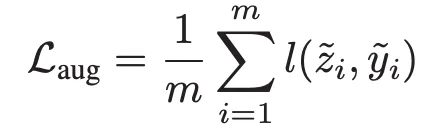
最后,将模型在干净数据上进行训练,根据原始标签计算损失并反向传播。实验结果
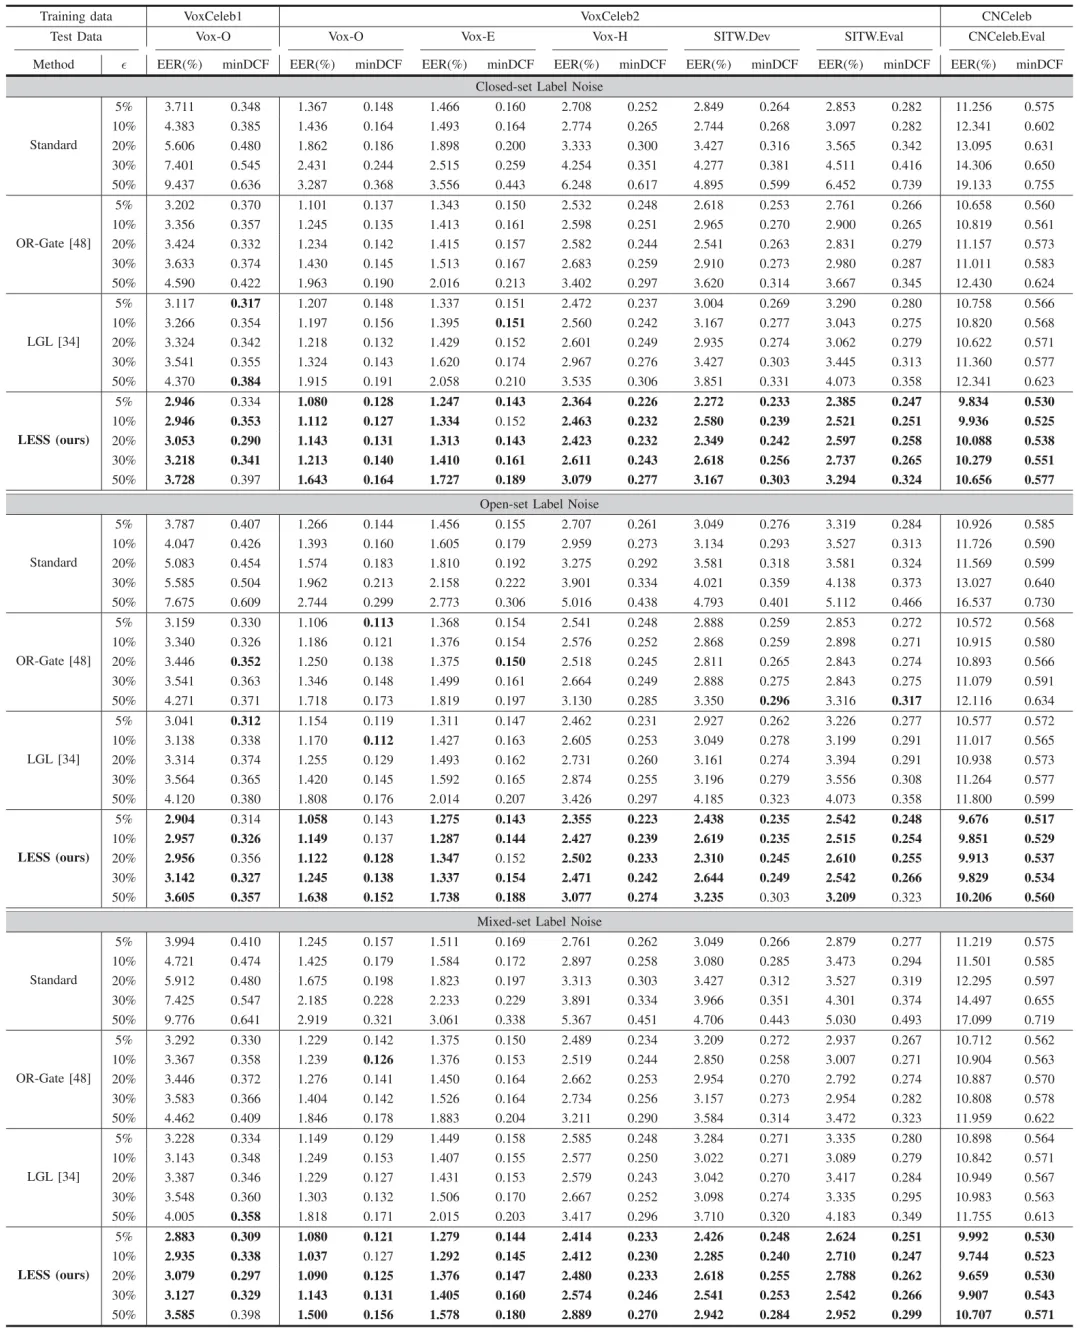
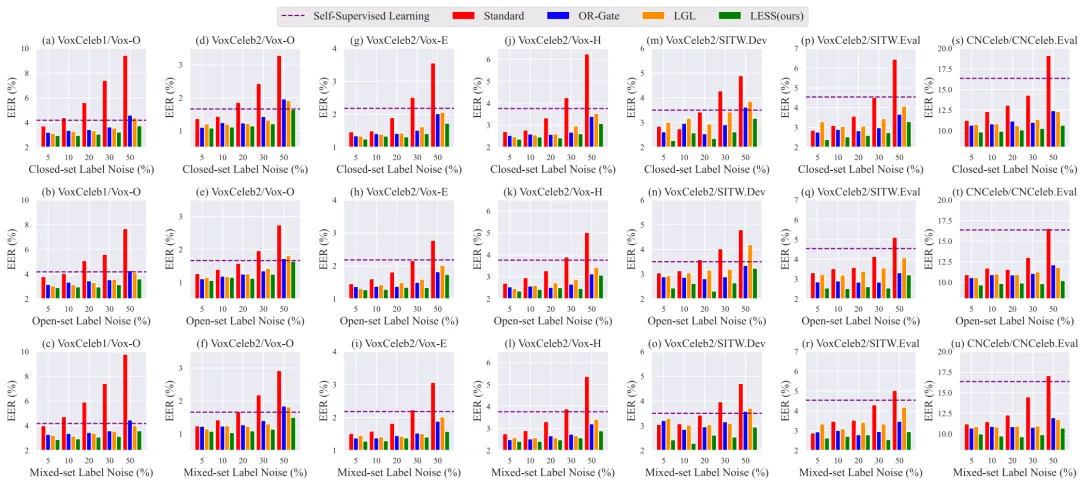
我们将所提出的LESS与多个基线方法进行了比较。表1展示了所有方法在具有不同标签噪声类型和比例的基准数据集上的实验结果。首先从采用标准方法的结果可以看出,无论训练集包含哪种噪声都会影响说话人验证的性能,并且这种负面影响随着噪声率的增加而增大。当使用OR-Gate或LGL选择可靠样本进行训练时,可以观察到在不同类型和比例的噪声标签下这些方法相对于标准方法都取得了更低的EER和minDCF。我们进一步可以发现使用我们提出的LESS框架在所有标签噪声场景下取得了最优的EER,其次在绝大多数场景下也取得了最优的minDCF,这体现了我们的方法的优越性。即使在数据集包含50%的闭集、开集和混合集标签噪声时,我们的方法也能分别降低86.49%、82.72%和90.41%的EER损耗。
表1. 使用闭集、开集和混合集标签噪声对不同方法的EER(%)和minDCF比较
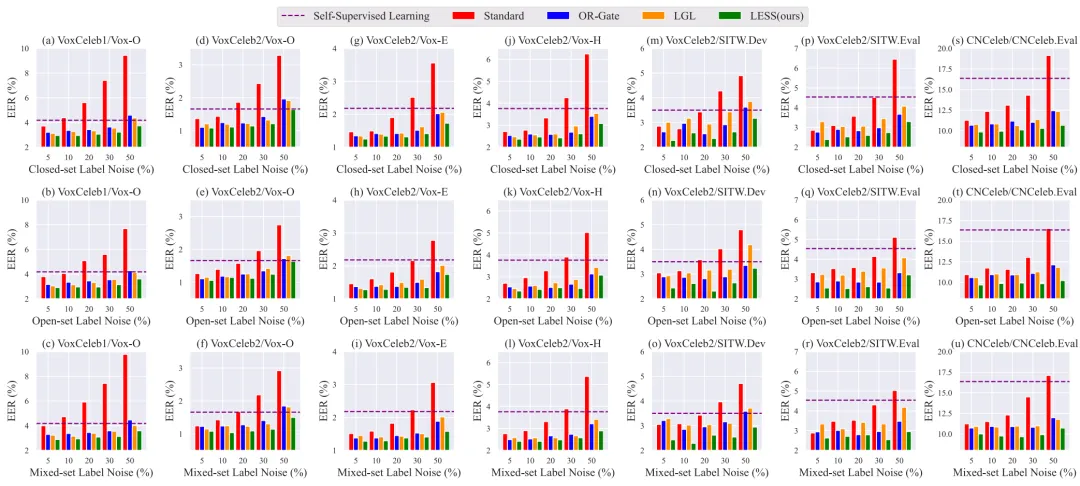
最近几年,自监督说话人验证凭借从无标签数据中学习说话人表征的能力得到研究人员的青睐。因此,当训练数据中存在大量噪声标签时,一个更好的选择是采用自监督学习(SSL)以避免噪声标签的影响。如图3所示,我们将各种场景下的标签噪声学习方法和流行的SSL方法的性能进行了比较。可以看出,标准训练方法在标签噪声达到一定比例(10%至50%)时性能低于SSL。然而,当我们采用噪声样本过滤方法(OR-Gate、LGL)时,在标签噪声比例低于50%时都优于SSL。此外,当使用我们提出的LESS框架时,我们的方法在所有噪声场景下都取得了最佳性能。
在采用高置信度排名选择干净样本时,有一个需要调整的阈值\mu。在本小节中,我们进一步研究了LESS在不同\mu值下的性能如何变化。如图4所示,虽然LESS的性能随着\mu值的变化些许波动,但在很大范围内,LESS对\mu值的敏感性相当温和。
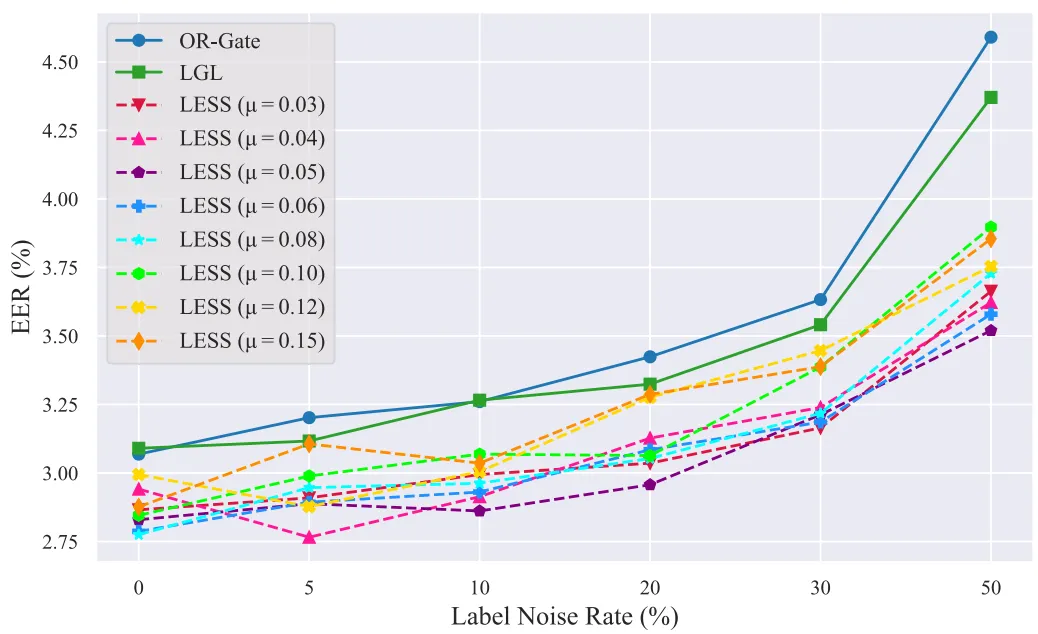
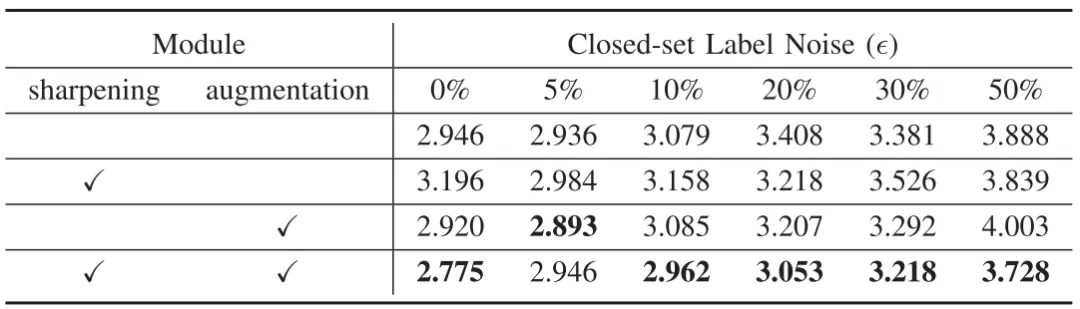
图4. 在含有不同比例的闭集标签噪声的VoxCeleb1上使用不同参数的LESS的EER比较。为了加快标签矫正速度,我们在更新集成标签时使用锐化后的模型输出。此外在训练时我们对干净集合使用mixup数据增强。为了探究这两个模块是否有效,我们在VoxCeleb1上进行了消融实验。结果如表2所示,可以看出两个模块在原始框架基础上均有一定的性能提升,同时应用两个模块在大多数测试集中取得了最好的性能。
表2. 在VoxCeleb1上关于LESS的消融实验的EER结果
讨论
样本选择和标签校正的准确性
在本文中,我们提出了一种标签集成和样本选择方法,一方面划分干净样本和噪声样本,另一方面矫正噪声样本标签。因此我们通过监控训练过程中的准确率、召回率以及参与训练的标签平均置信度验证我们提出的方法的有效性。
首先我们探究了高置信度排名筛选干净样本的质量。图5中的黄色实线代表筛选出的干净样本的准确率,可以看出在整个训练过程中精准率都非常接近1,表明我们的方法很少将噪声样本错判为干净样本。紫色实线代表干净样本的召回率,可以看出在所有标签噪声场景下,我们的方法在20个epoch内就能将几乎所有干净样本识别出来。精准率和召回率曲线体现了我们的方法能够准确地筛选干净样本。
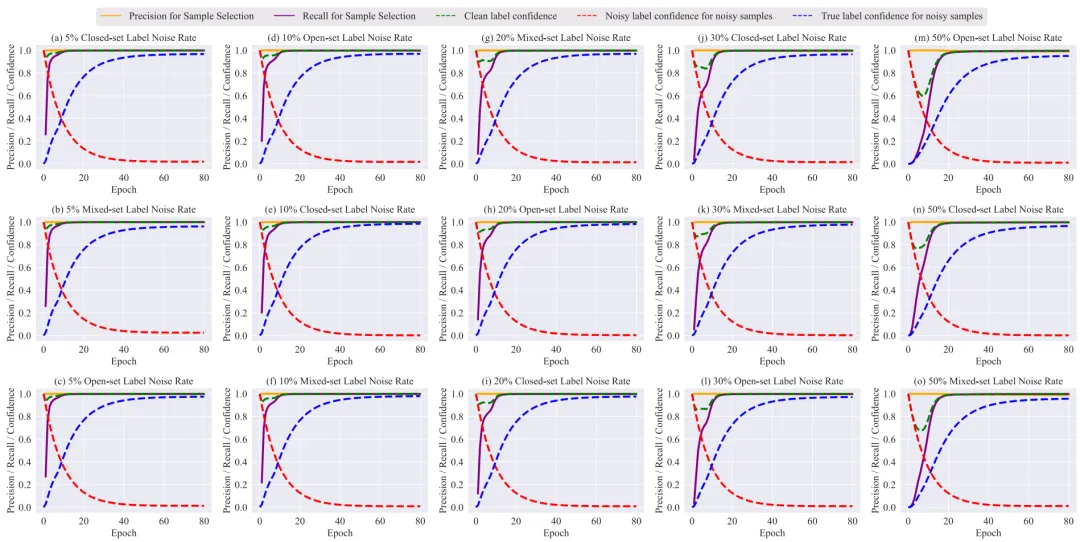
图5. 使用LESS框架在含有不同类型和比例的标签噪声的VoxCeleb1上训练的精准率、召回率和标签置信度的变化曲线其次我们探究了标签集成矫正噪声标签的效果。如图5中的红色虚线所示,噪声标签的置信度持续下降,表明模型不会拟合噪声表看。绿色虚线代表干净标签的置信度,由于一开始说话人模型识别能力较弱,导致干净标签的置信度轻微下降,随着干净样本被逐渐挖掘以及模型性能的不断上升,干净标签置信度逐渐恢复到初始水平。蓝色虚线代表噪声样本的地面真值标签的置信度,可以看出随着训练的进行,集成标签越来越接近噪声样本真实标签。总的来说,我们提出的标签集成方法可以在不破坏干净标签质量的前提下,有效地矫正噪声标签。
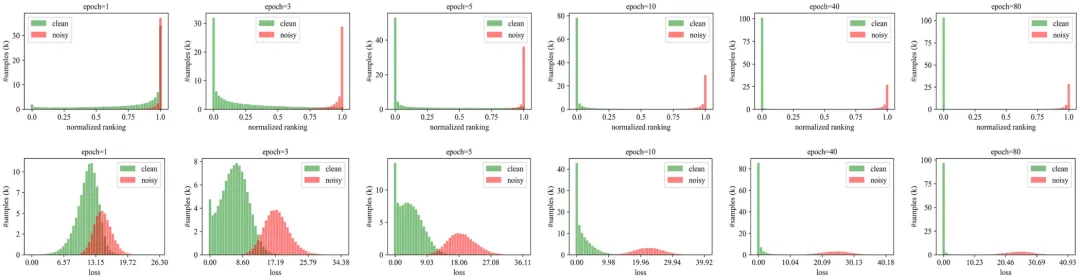
传统的样本选择的方法通常基于小损失原则,在本文中,我们提出一种基于置信度排名的方法。从本质上来说,这两种方法有相似之处,当样本标签的置信度排名较高时,损失值通常也很低。为了探究这两种方法的实际效果,我们在训练过程中统计了使用不同方法的干净和噪声样本分布,如图6所示。可以看出,这两种方法都可以很早地使干净和噪声样本分离(大约在第10个epoch)。观察数据分布可以看出,基于置信度排名的方法相比基于损失的方法可以使干净和噪声样本的间隔更远,其次可以使两种数据分布更加集中。此外,我们提出的高置信度排名方法也为处理噪声标签提供了新的见解。
图6. 比较不同方法在含有30%闭集标签噪声的VoxCeleb1上的干净和噪声样本分布。顶部:使用LESS框架的归一化置信度排名分布。底部:使用Loss Gated Learning的损失值分布。
说话人数据集中的标签是硬标签(one-hot类型,只需要一个整型存储),而我们提出的集成标签是软标签(需要一个tensor存储)。因此当数据集中的样本数量N和说话人ID数C非常大时,所有集成标签加起来占用的内存可能非常大。由于在每个epoch模型最多只用到一次集成标签,因此当集成标签占用内存非常大时,可以将其保存为数据文件,在需要的时候进行读写。并且由于干净集合仅使用原始标签,可以将集成标签从干净集合中删掉以减小内存占用。
在本文中,我们通过实验证明噪声标签会损害说话人模型的性能,并且进一步展示了在训练过程中说话人模型会先拟合干净标签然后拟合噪声标签的特征。基于深度说话人模型的特点 ,我们提出了一种新颖的标签集成和样本选择框架,该框架实现了学习、选择、矫正的集成。一方面,高置信度排名方法可以准确筛选干净标签。另一方面,标签集成方法将模型预测通过指数移动平均的方式平滑地矫正噪声说话人标签,该方法在训练过程中可以不断提升噪声样本的地面真值标签置信度以及降低噪声标签的置信度。我们在最流行的说话人数据集VoxCeleb和CN-Celeb上模拟各种比例和各种类型的噪声标签进行实验,出色的结果证明我们的方法可以有效处理噪声说话人标签。此外,我们还评估了我们提出的标签集成方法对噪声标签的矫正效果以及高置信度排名方法划分干净和噪声标签的准确性。
参考文献
[1] M. Pham, Z. Li, and J. Whitehill, “How Does Label Noise Affect the Quality of Speaker Embeddings?” in Proc. INTERSPEECH, 2020, pp. 3216–3220.
[2] H. Wei, H. Zhuang, R. Xie, L. Feng, G. Niu, B. An, and Y. Li, “Mitigating memorization of noisy labels by clipping the model prediction,” in Proc. ICML, 2023, pp. 36 868–36 886.[3] B. Han, Z. Chen, and Y. Qian, “Self-Supervised Speaker Verification Using Dynamic Loss-Gate and Label Correction,” in Proc. INTERSPEECH, 2022, pp. 4780–4784.[4] X. Qin, N. Li, C. Weng, D. Su, and M. Li, “Simple attention module based speaker verification with iterative noisy label detection,” in Proc. ICASSP, 2022, pp. 6722–6726.[5] F. Tong, Y. Liu, S. Li, J. Wang, L. Li, and Q. Hong, “Automatic Error Correction for Speaker Embedding Learning with Noisy Labels,” in Proc. INTERSPEECH, 2021, pp. 4628–4632.[6] L. Li, F. Tong, and Q. Hong, “When speaker recognition meets noisy labels: Optimizations for front-ends and back-ends,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 30, pp. 1586– 1599, 2022.
本文引用格式
Zhihua Fang, Liang He, Lin Li and Ying Hu, "Improving Speaker Verification With Noise-Aware Label Ensembling and Sample Selection: Learning and Correcting Noisy Speaker Labels," IEEE/ACM Transactions on Audio, Speech, and Language Processing,vol.32,pp.2988-3001,2024,doi: 10.1109/TASLP.2024.3407527.
 语音小管家