
 语音小管家
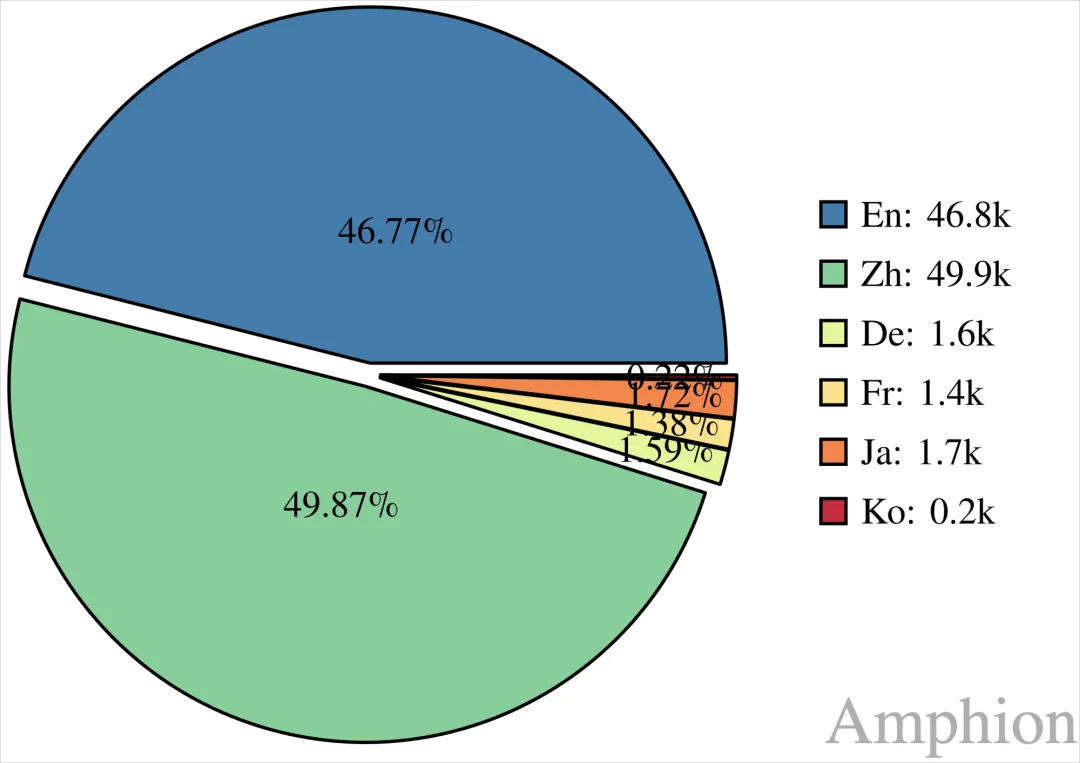
港中大(深圳)联合中科院声学所、上海人工智能实验室等机构发布了超过10万小时包含6种语言的多样化的语音生成数据集——Emilia!更重要的是,Amphion直接开源了Emilia-Pipe数据预处理框架,学术界也能众筹数据了,也能玩大模型了! 🎉🎉🎉
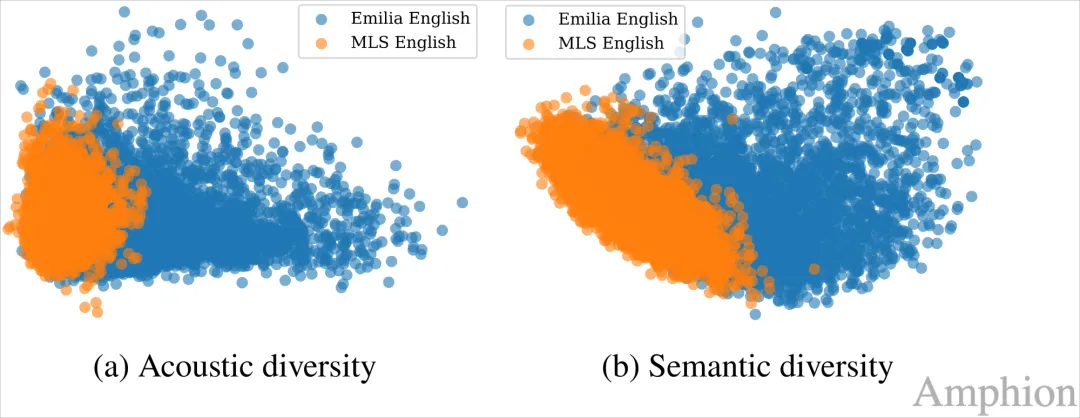
相较于MLS、Libri-Light等有声书数据集,Emilia数据集在声学特征和语义覆盖方面更为丰富,如下图所示。
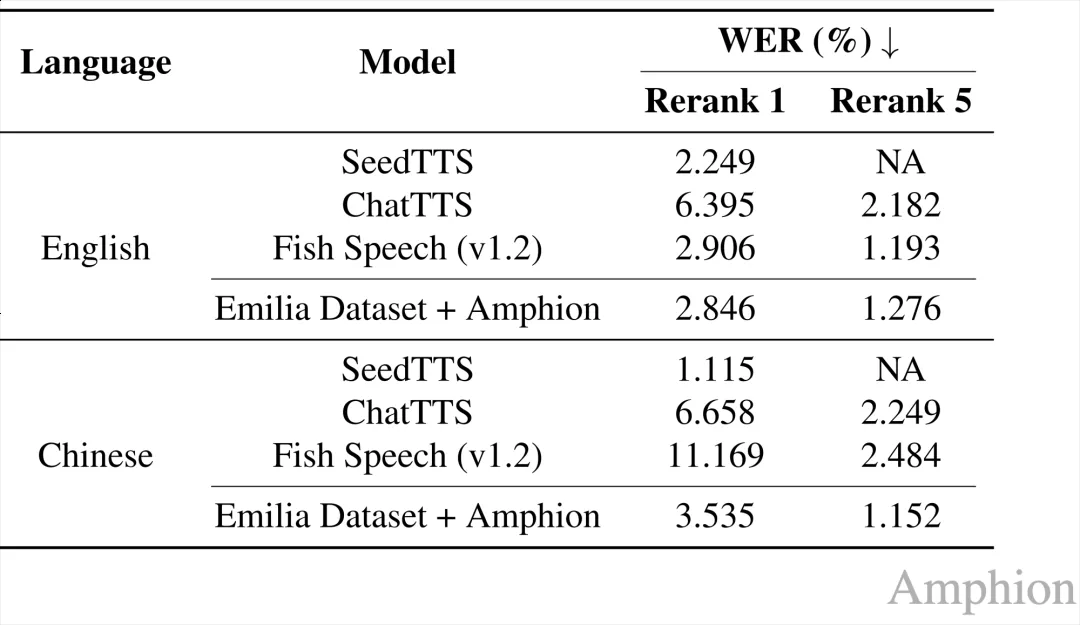
Emilia 10万小时数据集训练的TTS系统跟SeedTTS、ChatTTS等开源和商业系统/模型的客观指标对比(其中测试数据来自SeedTTS官方测试集)。
📌ArXiv:https://arxiv.org/abs/2407.05361
📌GitHub:https://github.com/open-mmlab/Amphion/tree/main/preprocessors/Emilia
📌Homepage:https://emilia-dataset.github.io/Emilia-Demo-Page/
📌HuggingFace:https://huggingface.co/datasets/amphion/Emilia
