
 语音小管家
摘要
01 研究背景
当前对于生成式对话模型性能提升的研究已经提出了多种具有前景的方法。
检索增强生成法(Retrieval-Augmented Generation, RAG),通过整合外部数据库中的知识,使得模型从外部信息库获取信息,进而提升生成式对话模型的性能和可靠性。由于检索增强生成的性能依赖于检索器的准确性和效率,因此低质量或不相关的检索结果反而会影响生成内容。另外,如何有效地将检索到的信息与模型的先验知识进行整合也是该方法面临的一大挑战。
思维链(Chain of Thought, CoT),将复杂推理任务分解为多个中间步骤依次进行计算,从而获得最终结果。当前思维链的常见应用方法——思维链提示法,通常需要依赖约100B参数量级的模型才能充分释放模型的推理能力。这一参数量级的模型不论是用于研究还是实际应用,都对计算资源有着较高的要求。
RAFT方法(RAG+SFT),将RAG与CoT相结合用于小规模模型的微调(SFT),从而优化生成式对话模型在推理任务中的表现。该方法不仅规避了思维链提示法对模型参数规模的需求,同时也缓解了检索增强生成方法对检索器性能的依赖以及知识整合的难点,提高了模型的复杂信息提取能力以及逻辑推理能力。
02 RAFT方法
如果用考试来类比生成式对话模型的问答任务,那么监督微调(SFT)是一场课后的闭卷考试,在考试时不借助任何参考资料, 仅利用课上学到的解题方法进行答题;检索增强生成法(RAG)是一场开卷考试,在考场上根据考题内容从外部知识库中寻找相关段落并推理出答案。RAFT方法则相当于让模型在考试前首先习得从相关信息中推理计算出结果的能力,从而在开卷考试中模型可以更快速、更准确地根据参考资料推理出答案。
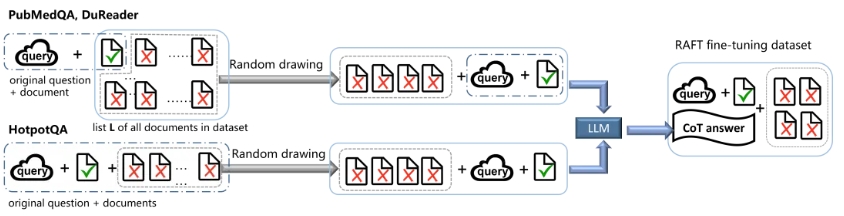
图1:RAFT方法示意图
具体来说,我们用特定的RAFT训练数据集对模型进行微调。RAFT方法具有以下两个核心特点:
1. 在问题之外附有若干参考文档,其中不仅包含携带有效信息的文档,还包含与问题内容无关联的干扰文档,从而训练模型的信息提取和处理能力。
2. 数据集中的答案采用思维链式答案作为微调的目标文本,通过微调提高模型的逻辑推理能力。
我们对开源数据集HotpotQA、PubMedQA和DuReader_robust进行了数据集重构用于RAFT微调:
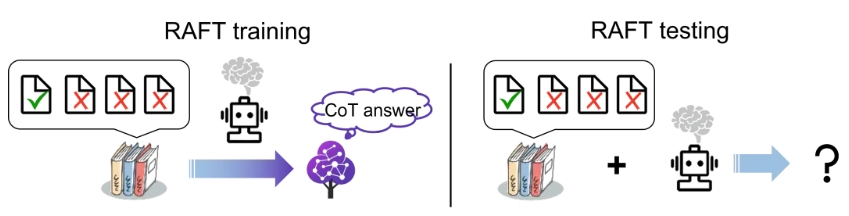
图2:数据集重构流程图
03 实验评估
我们分别在开源数据集HotpotQA、PubMedQA和DuReader_robust上对RAFT方法进行了评估,并采用了zero-shot prompting、zero-shot prompting+ RAG、DSF、DSF+RAG四个基线作为对照。以EM分数和F1分数为评估指标,统计了 RAFT 方法在包括长、短答案任务,中英文任务以及支持型、对比型等不同类型推理任务中的表现差异。此外,我们从 RAFT 的训练数据集中去除了思维链答案进行消融实验以验证思维链在RAFT方法中的作用。
对于英文数据集HotpotQA和PubMedQA,我们用LLaMA2-7B-chat作为预训练模型,对于中文数据集DuReader_robust,则用Qwen-1.5-7B-chat作为预训练模型。
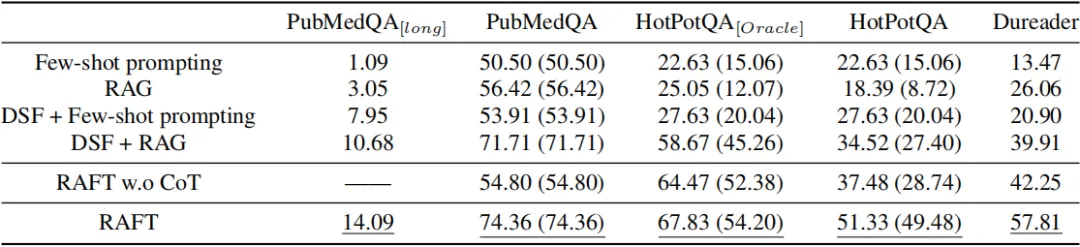
表1:实验评估结果,括号内为EM分数,括号外为F1分数
04 总结
RAFT方法,不仅提高了模型对于信息的提取和处理能力,同时也增强了模型面对复杂推理任务时的逻辑思维能力,在包括长、短答案任务,中英文任务以及支持型、对比性等不同类型推理任务中均展现出了优越的性能。更多实验结果的细节及分析,请见原文[1]。
参考文献
