本文整理了一些近期发表的关于音频在不同行业的应用相关论文,供大家了解科研进展。
来源丨21dB声学人
1.揭示旋律矩阵:使用机器学习技术探索数字音乐流行中的流派和音频动态
DOI:10.1108/mip-04-2024-0209作者:Jurui Zhang , Shan Yu , Raymond Liu , Guang-Xin Xie , Leon Zurawicki本文旨在使用机器学习方法探索影响音乐流行的因素。使用 Spotify 的 204,853 首歌曲数据集进行分析。使用预测机器学习模型预测歌曲的流行度,结果显示随机森林模型在关键性能指标方面具有优势。该分析确定了影响音乐流行度的关键类型和音频特征。此外,特定流派分析表明,音乐特征对音乐流行度的影响因流派而异。虽然以前的研究已经探讨了可能导致音乐流行的不同因素,但这项研究是一项开创性的努力,首次考虑了在预测数字音乐流行时流派和音频特征之间错综复杂的相互作用。
2.基于变压器进行的一种根据语音生成人体姿态的方法DOI:10.1007/s10489-024-05769-4肢体语言是一种跨越语言和文化的交流方法。在演讲中善用身体动作可以增强说服力,提高个人魅力,并使演讲更有效。根据内容为数字化身和社交机器人生成匹配的身体动作已成为一个重要的话题。在本文中,我们提出了一个基于 transformer 的网络模型,从输入语音中生成身体运动。我们的模型包括音频变压器编码器、运动变压器编码器、模板变分自动编码器、跨模态变压器编码器和运动解码器。此外,我们提出了一种新的评估指标,用于描述距离的运动变化趋势。实验结果表明,与最先进的模型相比,所提出的模型提供了更高质量的运动生成结果。正如视觉骨架运动所表明的那样,我们的结果比其他方法的结果更自然、更逼真。此外,生成的运动在多个评估指标方面产生了卓越的结果。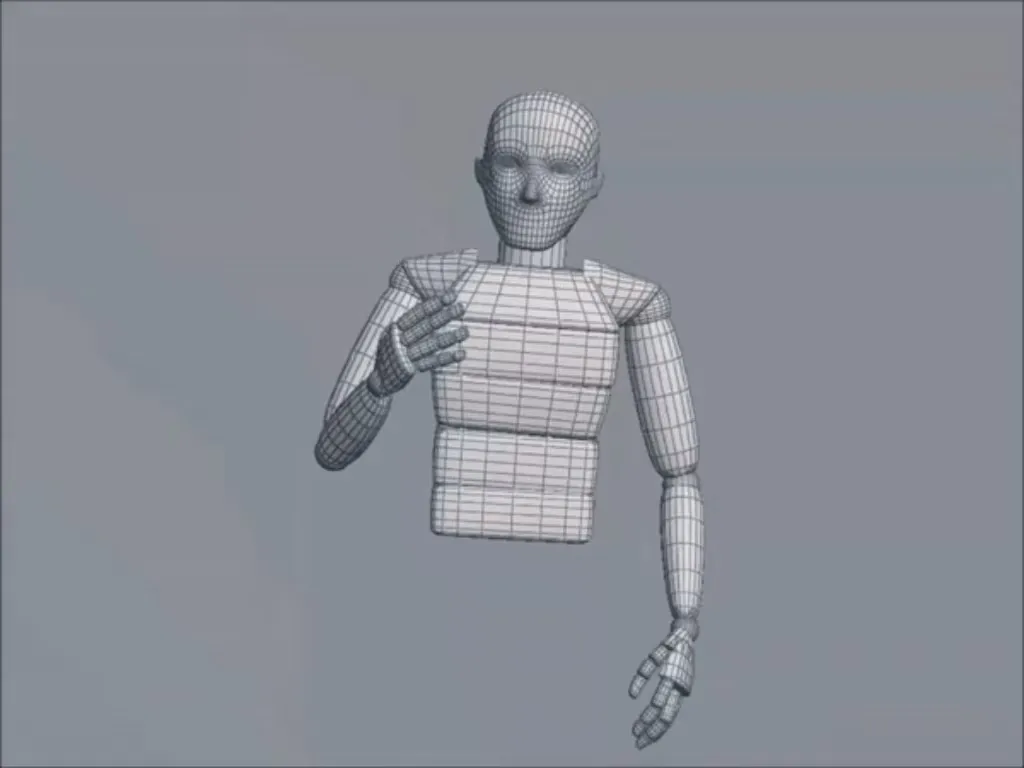
3.TAG2G:基于扩散的对话者感知协同语音手势生成方法DOI:10.3390/electronics13173364作者:Filippo Favali, Viktor Schmuck, Valeria Villani, Oya Celiktutan扩展现实 (XR) 系统即将融入我们的日常生活,并将在教育和辅导等各个领域提供支持。增强用户体验要求代理能够在这些系统中显示真实的情感和社交行为,并且作为先决条件,能够理解他们的交互伙伴并做出适当的响应。但是在代理是倾听者的环境中时,生成的手势缺乏我们期望的面对面对话的自然程度。为了克服这个问题,我们设计了一个名为 TAG2G 的管道,它由扩散模型和矢量量化变分自动编码器 (VQVAE) 组成,该模型被证明是手势生成中稳定而强大的工具,广泛用于生成有意义的手势嵌入。从单态到二元多模态输入设置(即考虑对话双方的文本、音频和先前的手势)使我们能够探索和推断平衡的双方对话中的复杂交互机制。根据我们的结果,多代理对话输入设置提高了生成的手势相对于对话手势的适当性。相反,当代理说话时,单一测试方法(monadic test) 在生成的手势与讲话的适当性方面表现得更好。
4.EA ViT:用于音频分类的外部注意力视觉转换器作者:Aquib Iqbal, Abid Hasan Zim, Md Asaduzzaman Tonmoy, Limengnan Zhou, Asad Malik, Minoru Kuribayashi本文提出了外部注意力视觉转换器 (EA ViT) 模型, 一种旨在提高音频分类准确性的新方法。随着数字音频资源的激增,在各种应用(包括音乐流媒体平台和环境声音识别)中,由于需要改进推荐系统和用户个性化,对精确高效的音频分类系统的需求也随之加剧。准确的音频分类对于将庞大的音频库组织成一致的类别至关重要,使用户能够快速找到他们的首选音频内容。在本研究中,我们利用了 GTZAN 数据集,其中包含涵盖 10 种不同流派的 1,000 首音乐片段。每个30秒的音频片段都被分成3秒的节录,以增强数据集的稳健性并减少过度拟合的风险,从而可以进行更细致的特征分析。EA VIT模型将多头外部注意(MEA)机制集成到Vision Transformer(ViT)框架中,有效地捕获样本之间的长期依赖关系和潜在的相关性。这种外部注意力(EA)机制采用可学习的内存单元,增强网络有效处理复杂音频特征的能力。研究表明, EAViT 的总体精度达到了惊人的93.99%,超过了最先进的模型。
作者:Tiago Tavares, Fabio Ayres, Zhepei Wang, Paris Smaragdis音频-文本跨模态对比学习的最新进展表明,它有可能实现零样本学习。一种可能性是将预训练骨干神经网络的项嵌入投影到跨模态空间中,在该空间中,项相似性可以在两个领域中计算。这个过程依赖于骨干网络强大的单模态预训练,以及投影器的密集数据训练任务。这两个过程可能会受到无意数据泄露的影响,这种泄露可能来自在预训练中使用监督学习,或者来自无意中使用零样本学习评估的标签训练跨模态投影。在这项研究中,我们表明,所测量的零样本学习准确性的很大一部分是由于音频和文本骨干的继承优势,也就是说,它们不是在跨模态域中学习的,也不是从一个模态转移到另一个模态。6.基于优化注意力的混合深度学习框架,用于从语音信号中自动识别说话人DOI:10.1007/s11042-024-19996-x作者:Venkata Subba Reddy Gade , M. Sumathi说话人识别(SR)是利用说话人语音笔记的特征来识别说话人,并且已经被广泛研究了很多年。近年来,技术进步使SR成为更热门的研究课题。基于深度学习 (DL) 的 SR 作品是文献中记录的广泛 SR 作品中最先进、最有效的,具有更高的准确性。然而,为了确定实际意义,必须仔细研究输入信号中噪声的影响以及学习阶段重要细节的忽略。这项工作提出了一种新颖的基于深度学习的自动化混合框架,用于准确识别男性语音说话者。预处理、特征提取、特征选择和 SR 是应用于从输入数据集中取出的语音笔记的一些阶段。首先,使用两级 Savitzky Golay 滤波技术 (2S-SGF) 消除音频样本中的噪声和干扰。去噪后,从输入信号中提取许多重要特征,以便为识别模型提供信息。从提取的特征中,使用混沌蜜獾优化算法(ChHBOA)来选择信息最丰富的特征。dendnet121_self-attention 深度卷积神经网络 (D121_SAttnDCNN) 模型接收这些选定的特征并使用它们来执行 SR。所提出的网络模型包括一个自注意力层,以关注高信息量的特征。最后通过Python平台上的模型仿真进行综合评价。使用各种实验来证明该模型的性能意义,并使用向公众开放的 Voxceleb-1 性别数据集进行评估。所提出的SR模型总体准确率达到98%,可应用于基于语音的身份验证实践的不同领域,包括取证管理、安全目的、个人智能设备、远程支付等。
作者:刘莫阳, 刘玉坤, 付瑞波, 温正琪, 陶建华, 刘雪飞, 李冠军随着 deepfake 技术的快速发展,尤其是深度音频假冒技术、社交媒体现场的错误信息检测遇到了巨大的挑战。社交媒体数据通常包含多模式信息,这些信息 包括音频、视频、文本和图像。但是,现有的多模态错误信息检测方法往往只关注其中的一些模态,未能全面处理来自所有模态的信息。全面解决可能出现在 社交媒体,本文构建了一个全面的多模态错误信息检测框架。通过使用相应的神经网络编码器每种模态,框架可以融合不同的模态信息和支持多模态错误信息检测任务。基于构建的框架,本文探讨了音频模态在社交媒体上的多模式错误信息检测任务。通过调整声学编码器的架构,不同声学的有效性功能编码器研究。此外,本文发现音频和视频信息必须仔细对齐,否则会出现不同的音频和视频模态严重损害模型性能。8.集成音频、视觉和语义信息,增强多模态说话人特征作者:程璐瑶, 王辉, 郑思琪, 陈亚峰, 黄荣杰, 张庆林, 陈倩, 李希浩说话人二值化是根据说话人身份将音频流或转录的语音内容分割成同质分区的过程,在人类语音的解释和分析中发挥着至关重要的作用。大多数现有的说话人二值化系统完全依赖于单峰声学信息,由于音频信号固有的模糊性,使得该任务特别具有挑战性。最近的研究在视听或音频语义建模以提高性能方面做出了巨大的努力。然而,即使结合最多两种模式也常常不足以解决自发和非结构化对话的复杂性。为了利用更有意义的对话模式,我们提出了一种新颖的多模态方法,联合利用音频、视觉和语义线索来增强说话者的二元化。我们的方法合理地将多模态建模表述为约束优化问题。首先,我们深入了解活跃说话者之间的视觉联系以及口语内容中的语义交互,从而建立丰富的成对约束。然后,我们引入联合成对约束传播算法,基于这些视觉和语义约束对说话者进行聚类。这种集成有效地利用了不同模式的互补优势,改进了各个说话人嵌入之间的亲和力估计。在多个多模态数据集上进行的广泛实验表明,我们的方法始终优于最先进的说话人二值化方法。DOI: 10.1016/j.heliyon.2024.e36484作者:Óscar Acosta, Carlos Montenegro, Rubén González Crespo本文提出了一种基于机器学习的模型,用于预测哥伦比亚波哥大市的道路交通噪声。该模型的输入变量为:车辆容量、速度、流量类型和车道数。输入数据是通过进行音频和录像的测量运动获得的。这些录音是使用在 4 米高度校准的测量麦克风制作的,可以通过软件处理来计算噪音水平。另一方面,通过处理视频数据,得到了车辆的容量和速度。这个过程是通过分类器进行的,该分类器使用现场拍摄的车辆图像和免费数据库进行训练。为了确定要使用的机器学习算法,对五个模型进行了比较,这些模型配置了通过网格搜索获得的相应超参数。结果表明,多层感知器 (MLP) 回归拟合最好,测试数据的 MAE 为 0.86 dB。最后,将所提出的 MLP 回归器与一些用于道路交通噪声预测的经典统计模型进行了比较。主要结论是 MLP 回归器相对于传统统计模型获得了最佳的误差和拟合指标。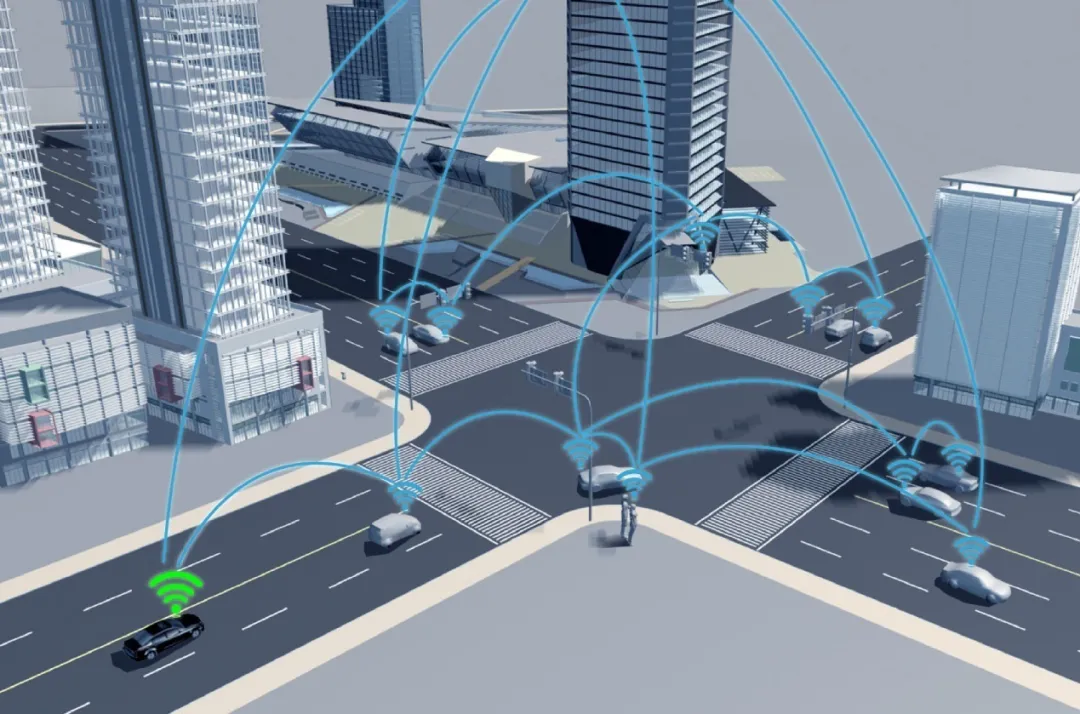
10.通过对比学习和音频预训练改进语音模仿查询(QBV)作者:Jonathan Greif, Florian Schmid, Paul Primus, Gerhard Widmer语音模仿查询 (Query-by-Vocal Imitation, QBV) 是指使用用户的声音模仿来搜索数据库中的音频文件。由于大多数人都可以通过语音有效地传达声音概念,因此与基于文本的搜索相比,QBV 提供了更直观、更方便的方法。为了充分利用 QBV,为声音模仿和原始声音开发强大的音频特征表示至关重要。在本文中,我们提出了一种新的 QBV 系统,该系统利用了使用大规模通用音频数据集预训练的卷积神经网络的特征提取能力。我们将这些预训练的模型集成到双编码器架构中,并使用对比学习对它们进行端到端的微调。我们提出的方法的一个独特方面是预训练模型的微调策略,使用经过调整的 NT-Xent 损失进行对比学习,为参考录音和声音模仿创建共享嵌入空间。所提出的系统显著增强了音频检索性能,在粗粒度和细粒度 QBV 任务上达到了新的技术水平。 语音小管家

