
 语音小管家
论文:Wavtokenizer: An Efficient Acoustic Discrete Codec Tokenizer For Audio Language Modeling
论文地址:https://arxiv.org/pdf/2408.16532Github
地址:https://github.com/jishengpeng/WavTokenizerHuggingFace
地址:https://huggingface.co/novateur/WavTokenizer
背景动机:解决音频语言建模的瓶颈,迈向更高效的音频处理
压缩与重构质量的权衡:大多数现有模型(如DAC、Encodec)通过多量化器层的设计来提升音频重构质量,但这也增加了计算复杂性和资源消耗。例如,DAC模型在9个量化器层的条件下,每秒需要900个token来重构一秒音频。如此高的压缩比率和计算成本,使得下游应用和模型部署变得复杂且代价高昂。
缺乏语义信息的丰富表达:当前的声学编码模型大多专注于音频的重构,而未能有效捕捉和保留语音和音频中的语义信息,这是重建任务和下游生成任务本身的训练gap。一些研究通过添加独立的语义模块来增强语义内容,但这通常需要多阶段的模型架构,增加了训练复杂度,并导致难以统一建模语音、音乐和其他音频数据。
单量化器模型的探索潜力:多量化器模型的复杂性推动了研究者对单量化器模型的探索,但在极端压缩条件下保持高质量重构仍是一个挑战。单量化器模型的优势在于更简单的架构和更低的计算成本,但如何优化矢量量化(VQ)空间以增强表示能力,并设计出避免重构伪影的解码器结构,依然是未解决的问题。
基于这些挑战,我们提出了WavTokenizer。通过创新设计扩展VQ空间、优化解码器架构、扩展上下文建模窗口和引入多尺度判别器,我们的模型实现了极致的压缩效果,同时显著提升了音频重构质量和语义信息表达能力。这一工作不仅为音频语言建模提供了新方向,也在音频生成和理解的未来应用中展现出巨大潜力。
实现细节:WavTokenizer的核心技术设计
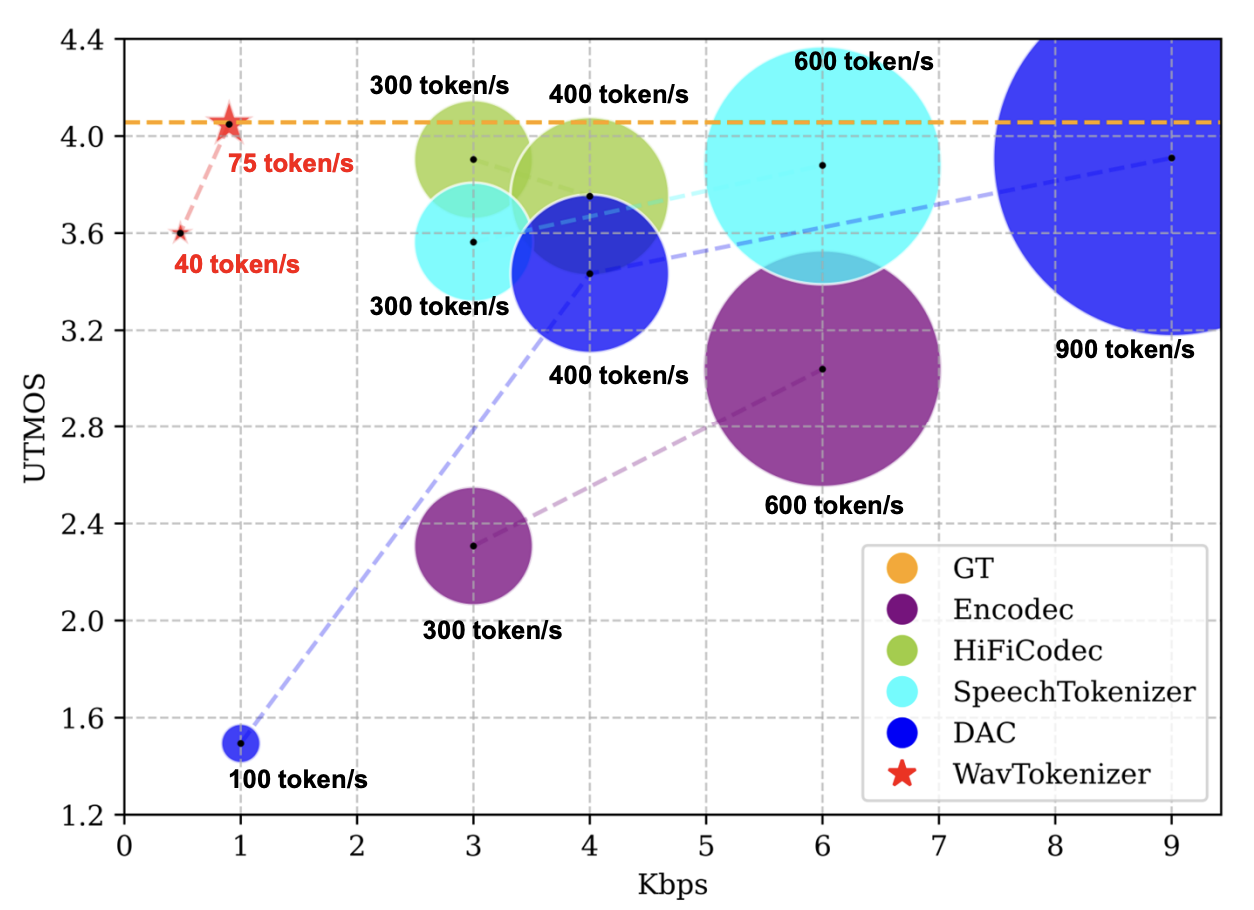
为了突破当前音频语言建模中存在的压缩和重构质量瓶颈,我们设计了一个新的离散声学编解码器模型——WavTokenizer。它在音频压缩、重构质量和语义信息表达能力上实现了前所未有的平衡。
1. 扩展矢量量化(VQ)空间,提高码本利用率
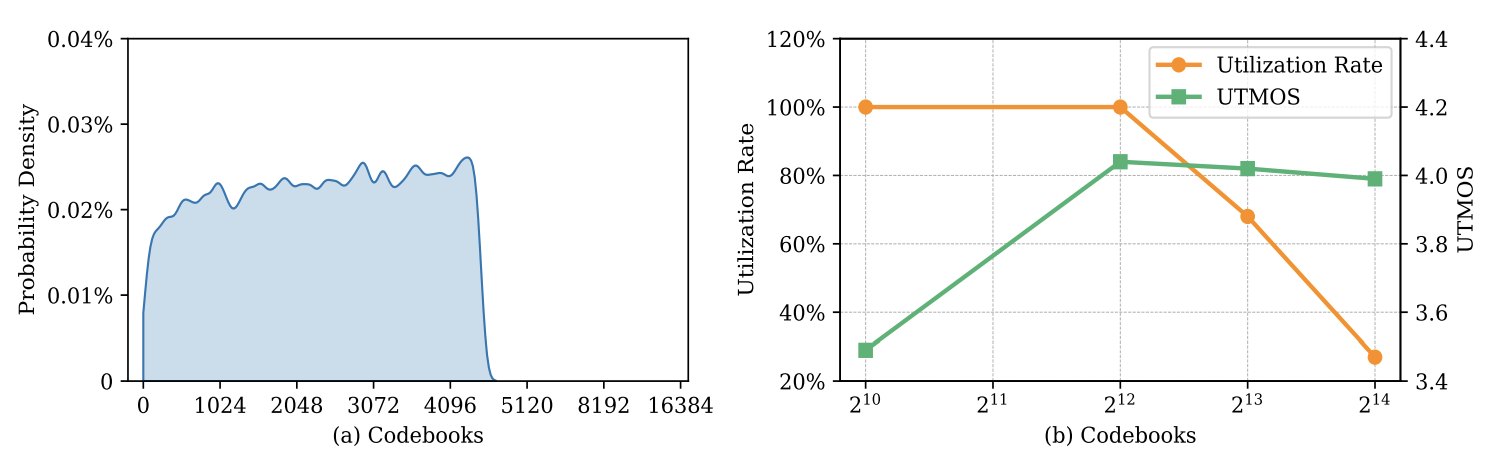
在传统的声学编解码器模型中,矢量量化(VQ)空间的大小通常是固定的,这限制了模型对音频信号的表达能力。我们通过将VQ空间从 1024 扩展到4096,显著提升了模型对高维音频数据的压缩和表达能力。为了确保扩展后的VQ空间得到充分利用,WavTokenizer 采用了基于K-means聚类初始化和随机唤醒策略的优化方法。这种设计能够在保证较低码率的同时,维持高质量的音频重构效果,并且能够有效减少信息损失。
2. 改进的解码器架构:逆傅里叶变换、注意力机制与扩展的上下文窗口结合
此外,WavTokenizer 在解码器中引入了注意力模块,并设计了扩展的上下文窗口来增强语义信息的建模能力。研究表明,使用更大的上下文窗口(例如 3 秒)有助于捕捉更多的语义信息,提升模型对长音频序列的重构质量。这种方法能够更好地处理音频中的静音段,提高了重构结果的连贯性和自然度。通过将注意力网络与逆傅里叶变换结合,WavTokenizer 在极低码率下实现了高质量的音频重构。
3. 多尺度判别器与复数STFT判别器的设计
4. 端到端优化策略,实现高效压缩
这些技术创新使得WavTokenizer能够在单量化器结构下实现音频的极致压缩和高质量重构,同时提供丰富的语义信息表达能力。我们相信,这一模型将为音频语言建模的未来应用提供新的可能性。
实验验证:WavTokenizer的卓越性能
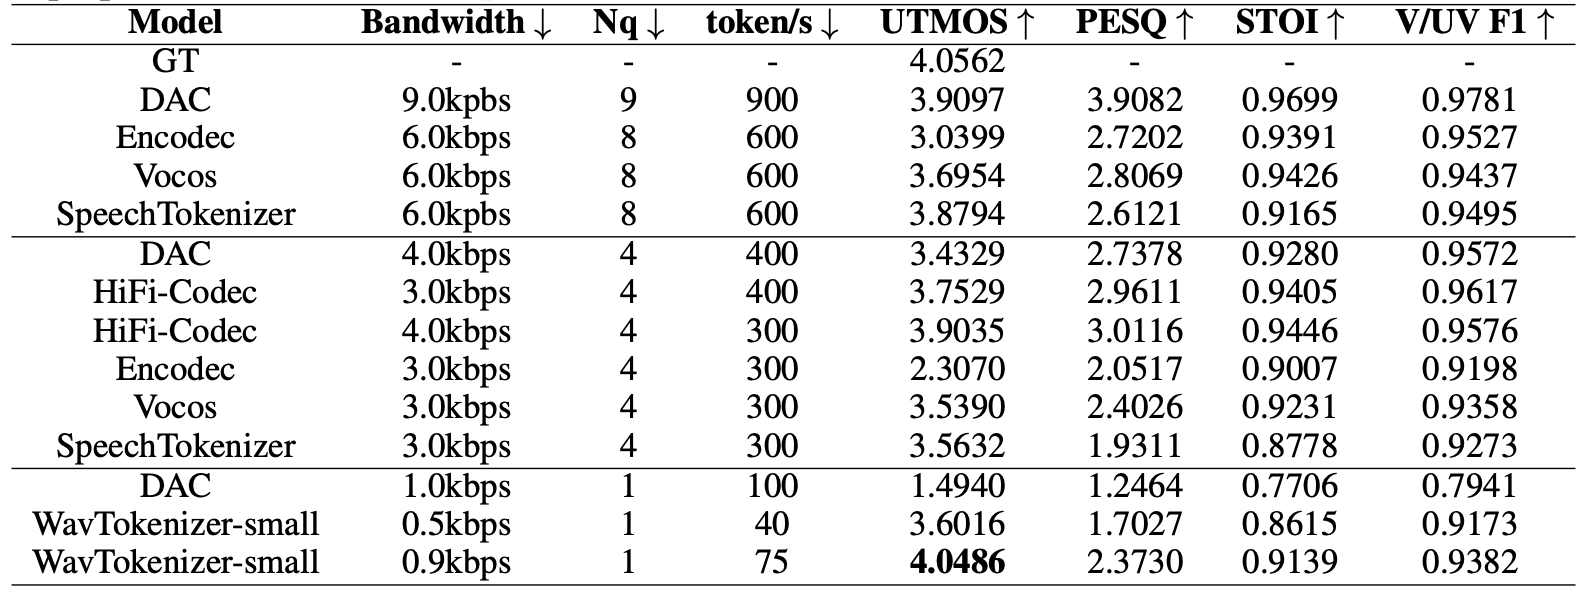
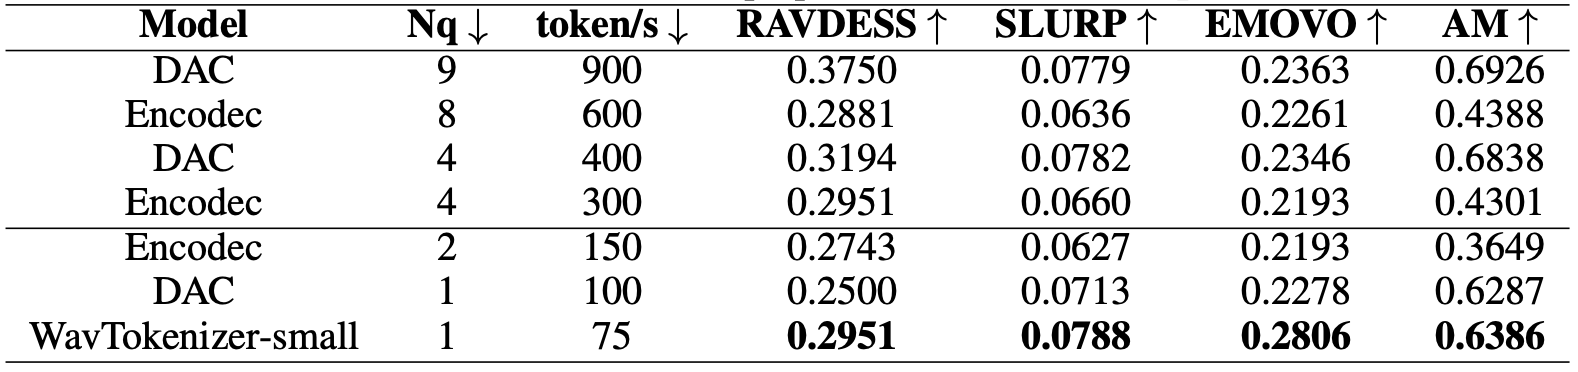
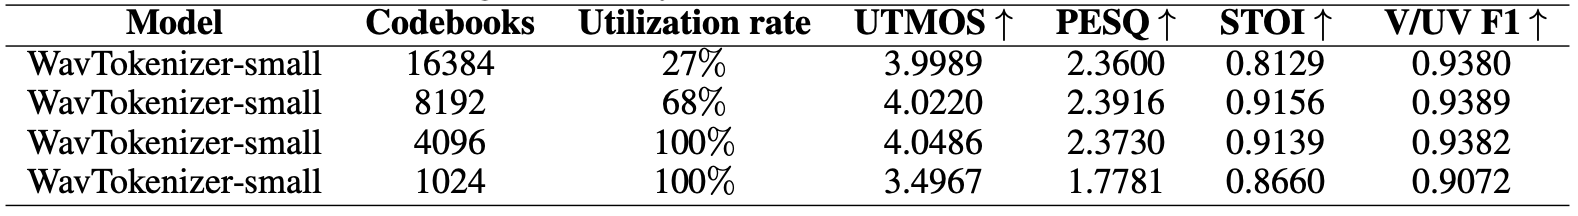
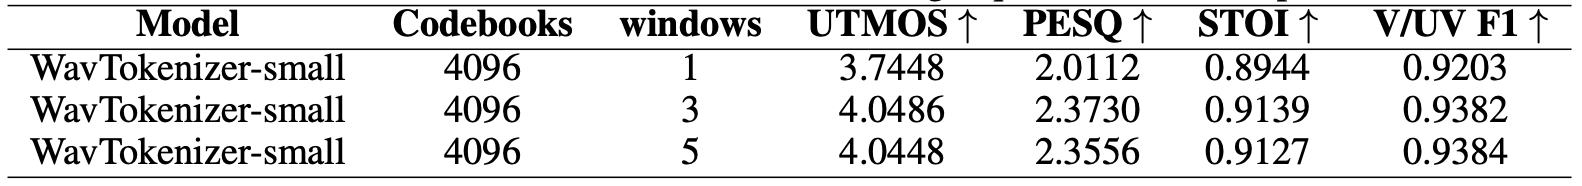
通过这些实验,WavTokenizer 展现出在极限压缩率和长序列生成任务中的强大适应性和稳定性,证明了其在音频压缩、重构质量和语义表达能力方面的全面优势。这些结果不仅为音频语言建模提供了新的可能性,也为未来多模态大模型的音频处理与生成提供了一个更高效、更有潜力的解决方案。
进一步探索
由于训练成本较大,我们将在十月之前补充WavTokenizer-medium,WavTokenizer-large版本的实验结果,以及在audio和music领域codec重建性和语义丰富性的实验。同时将进一步探索WavTokenizer模型在下游生成任务例如text-to-speech和GPT-4o范式任务上的性能,并且补充更多的消融实验结果。
总 结
通过对模型架构的改进和优化,WavTokenizer在保持高效压缩的同时,成功减少了模型的计算复杂性和带宽需求,在24kHz采样率下每秒音频仅需40或75个离散token。这一工作不仅验证了单量化器模型的可行性,还为音频生成和语义建模的未来发展提供了新的视角和方向。未来,我们计划进一步扩展模型的应用场景,探索WavTokenizer在更多下游任务和多模态数据处理中的潜力。
