
 语音小管家
近⽇,社交平台Soul App(以下简称“Soul”)语⾳⼤模型再次升级,上线⾃研端到端全双⼯语⾳通话⼤模型,能够以超低交互延迟、超快⾃动打断、超真实声⾳表达和情绪感知理解能⼒,直接理解丰富的声⾳世界,⽀持超拟⼈化的多⻛格语⾔,实现更接近⽣活⽇常的交互对话能⼒和“类真⼈”的情感陪伴体验。
⽬前,Soul⾃研的端到端语⾳通话⼤模型能⼒已上线旗下“异世界回响”实时通话场景(内测中),并将在后续拓展⾄AI苟蛋等多个AI陪伴、AI互动场景。
测试环境更真实;
超低交互延迟,超快⾃动打断,产品化的端到端的延迟最快仅需1.1秒左右;
超真实的声⾳表达,可直接⽀持多⻛格的声⾳克隆能⼒,随时更换你喜欢的声⾳;
超⾃然的⼈类思考⽅式,端到端的语⾳语义理解和响应以及更⾃然的语⾳指令控制,⽆需级联环节。
⾃2016年上线,Soul⼀直致⼒于以创新的技术⽅案和产品设计,实现社交体验的颠覆。2020年,Soul启动对AIGC的技术研发⼯作,系统推进在智能对话、语⾳技术、虚拟⼈等AIGC关键技术能⼒研发⼯作,并推动AI能⼒在社交场景的深度落地。
以AI升级社交的过程中,Soul的技术重点之⼀是致⼒于实现超拟⼈、⾃然情感陪伴体验。其中,声⾳是重要环节之⼀。作为传递信息和情感的重要媒介,声⾳最能在沟通中赋予“情绪温度”和“陪伴感”。特别是在社交场景中,情感化、低延迟、多⻛格的声⾳能⼒,可以打破“次元壁”,让线上社交特别是⼈机互动中,也能实现真实⽣活场景聊天的⾃然流畅感和沉浸现场感,真正完成类真⼈⽣活化互动场景中的交互体验。
因此,为⽤⼾带来更好的情绪反馈和陪伴感,情绪理解、延迟问题⼀直是Soul技术团队攻克的焦点。
此前,Soul团队已推出了⾃研的语⾳⽣成⼤模型、语⾳识别⼤模型、语⾳对话⼤模型、⾳乐⽣成⼤模型等语⾳⼤模型能⼒,⽀持真实⾳⾊⽣成、语⾳DIY、多语⾔切换、多情感拟真⼈实时对话等能⼒,并应⽤于Soul “AI苟蛋”、站内狼⼈游戏“狼⼈魅影”AI语⾳实时互动、独⽴新产品“异世界回响”等场景。
凭借对国际最前沿的技术发展保持密切关注和⾃⾝研发能⼒建设,Soul持续完善语⾳能⼒积累,创新AI社交应⽤体验。今年7⽉,在⼈⼯智能领域顶级的国际学术会议⸺国际⼈⼯智能联合会议(International Joint Conference on Artificial Intelligence,IJCAI)举办的第⼆届多模态情感识别挑战赛(MER24)上,Soul 语⾳技术团队在SEMI(半监督学习)赛道获得第⼀名,在国际赛事舞台上展现了Soul的前沿洞察和技术能⼒。
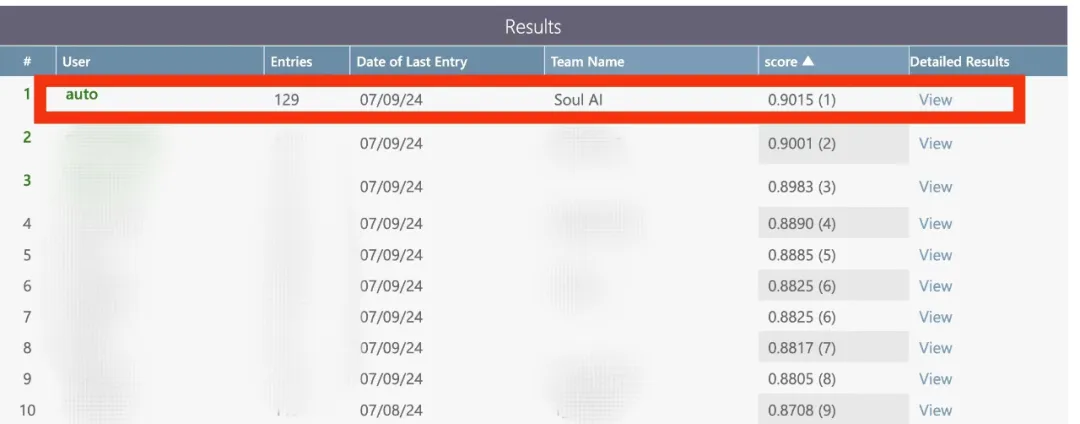
如今,⾃研端到端语⾳通话⼤模型的率先上线,再次证明了Soul在⾏业中扎实的技术能⼒积累。
区别于传统的级联⽅案,语⾳到语⾳的端到端建模,意味着语⾳交互体系的颠覆式升级,即不再需要从“语⾳识别、⾃然语⾔理解、语⾳⽣成”等多个环节流转,直接语⾳输⼊—语⾳输出的端到端模型能够最⼤程度实现信息⽆损传递,降低响应延迟时间。
此次Soul⾃研的端到端语⾳通话⼤模型便具备超低交互延迟、超快⾃动打断、超真实声⾳表达和超真实理解能⼒的特点,⽀持更⾃然的⼈机交互体验。
在延迟⽅⾯,于实际应⽤过程中,⽤⼾体验与“异世界回响”中虚拟⼈实时语⾳通话效果,延迟时间少于⾏业平均⽔平,真正实现即时的AI交流和陪伴。
值得⼀提的是,端到端的语⾳语义理解和响应以及更⾃然的语⾳指令控制,让Soul语⾳通话⼤模型不仅能够给予情感关怀、理解⼈声情绪情感并给出有温度的回复,还能够理解物理世界的声⾳场景,模拟物理世界动物声⾳、理解多⼈聊天内容、多⻛格语⾔切换、⽂艺内容创作和即兴演唱,接近现实交流互动场景需要。
