
 语音小管家
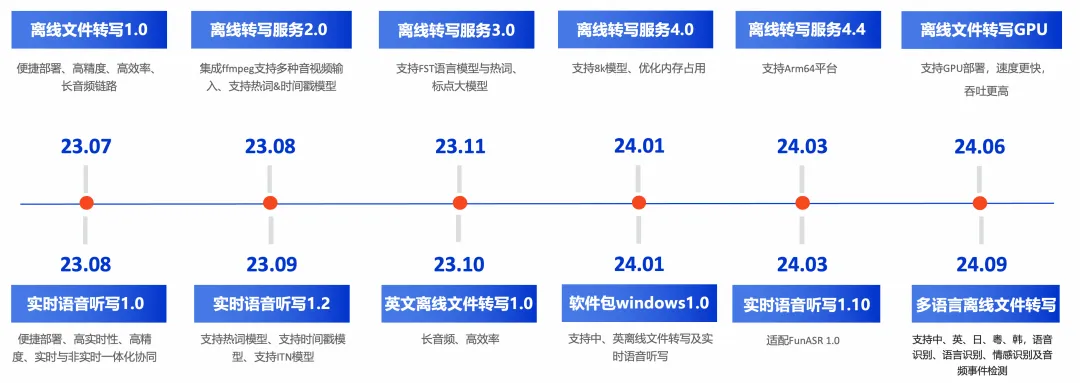
图1 FunASR社区软件包发布路线图
FunASR社区软件包地址:
https://github.com/modelscope/FunASR/blob/main/runtime/readme_cn.md
▎多语言离线文件转写软件包
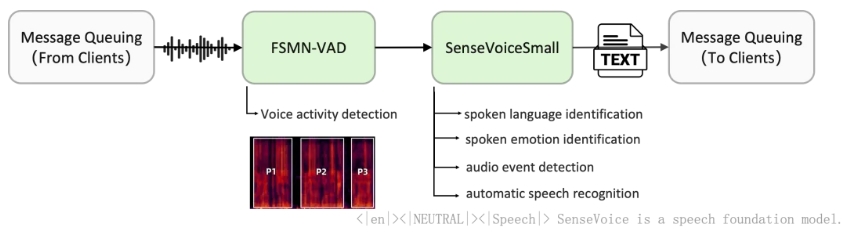
上图中,FSMN-VAD为语音端点检测模型,用于检测输入音频中有效语音的起止时间点信息,从而将输入的长音频转化为短音频,将检测出来的有效音频片段输入声学模型进行识别,减少无效语音带来的识别错误。
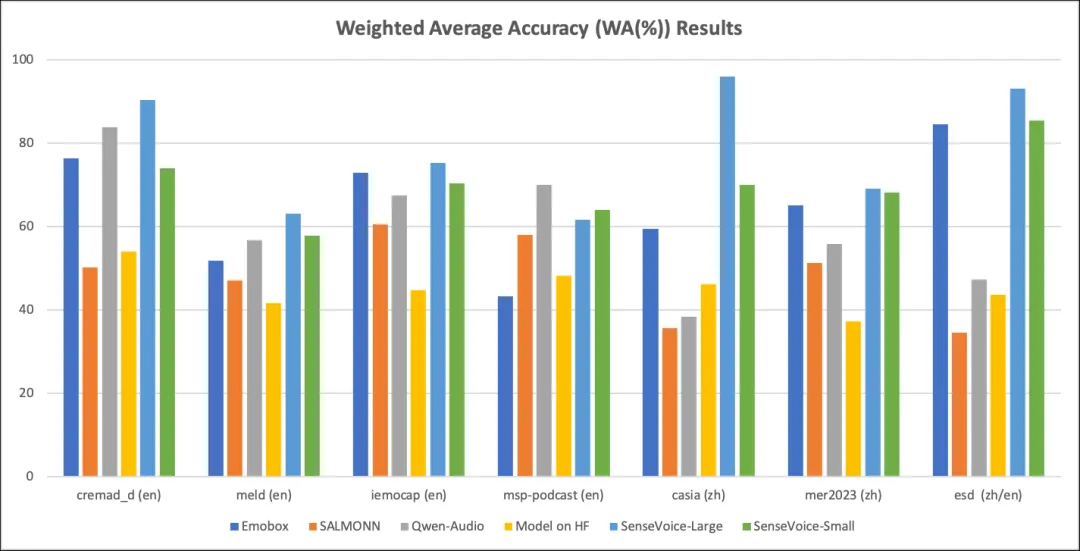
SenseVoiceSmall为声学模型,用于将输入的音频转化成文字序列,支持中、英、日、粤、韩五种语言,同时具备多种语音理解能力,涵盖了语音识别(ASR)、语言识别(LID)、情感识别(SER)以及音频事件检测(AED)。
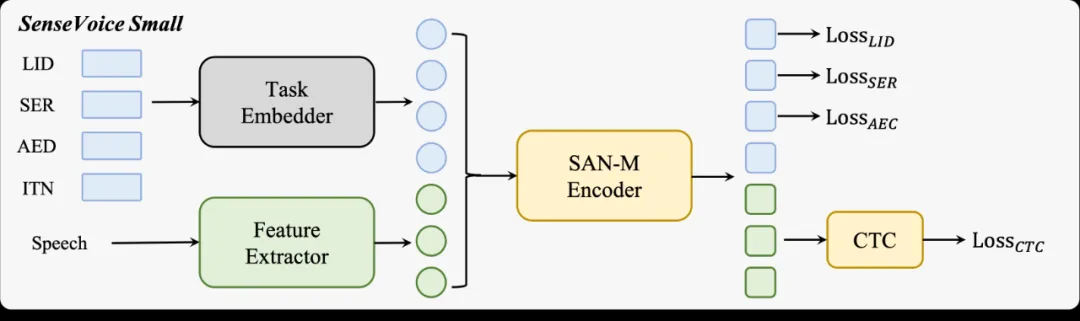
图3 SenseVoiceSmall模型结构图
>>>多语言语音识别性能
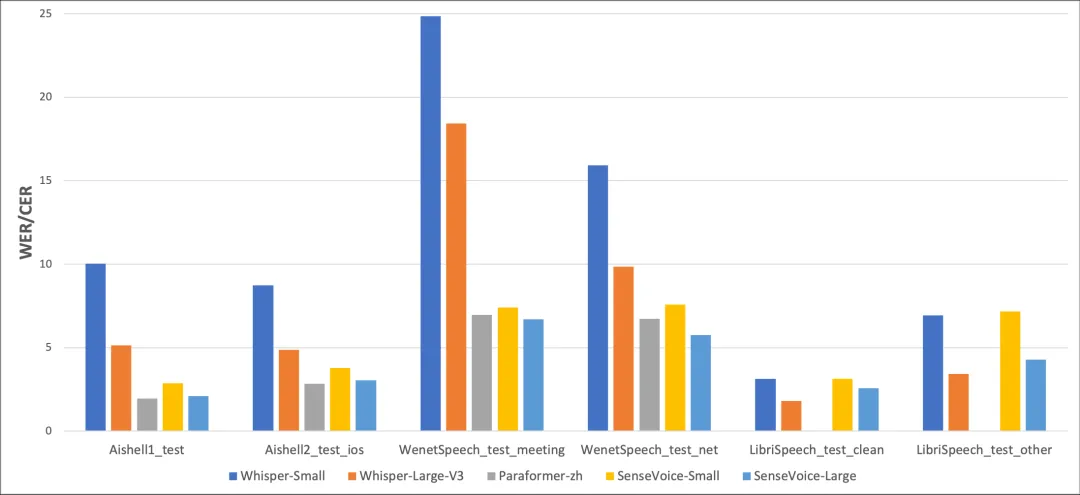
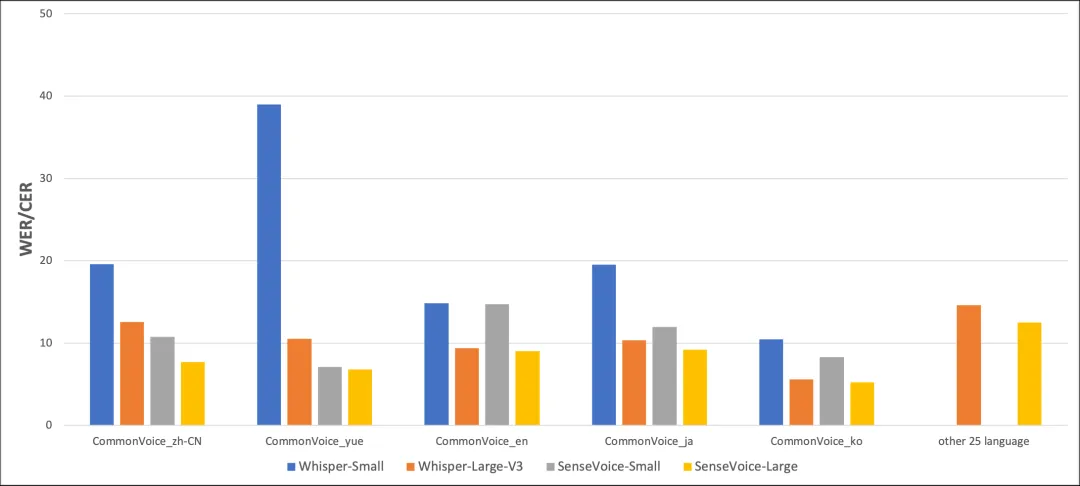
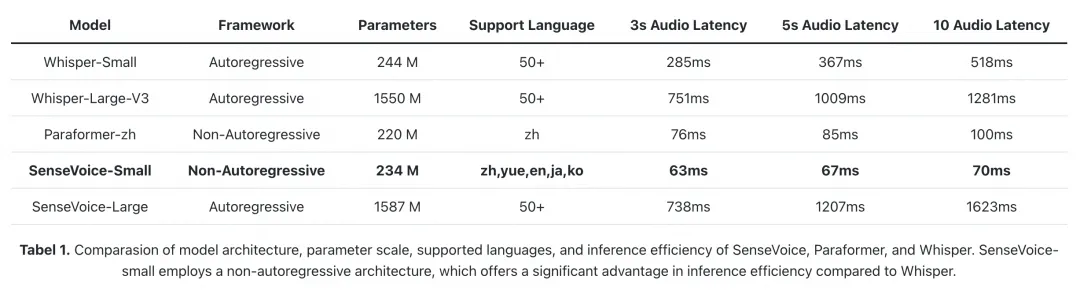
我们在开放源数据集上比较了SenseVoiceSmall和Whisper的多语言识别性能和推理效率,包括AISHELL-1、AISHELL-2、Wenetspeech、Librispeech和Common Voice,详见下图。
>>>语音情感识别性能
>>>音频事件检测性能
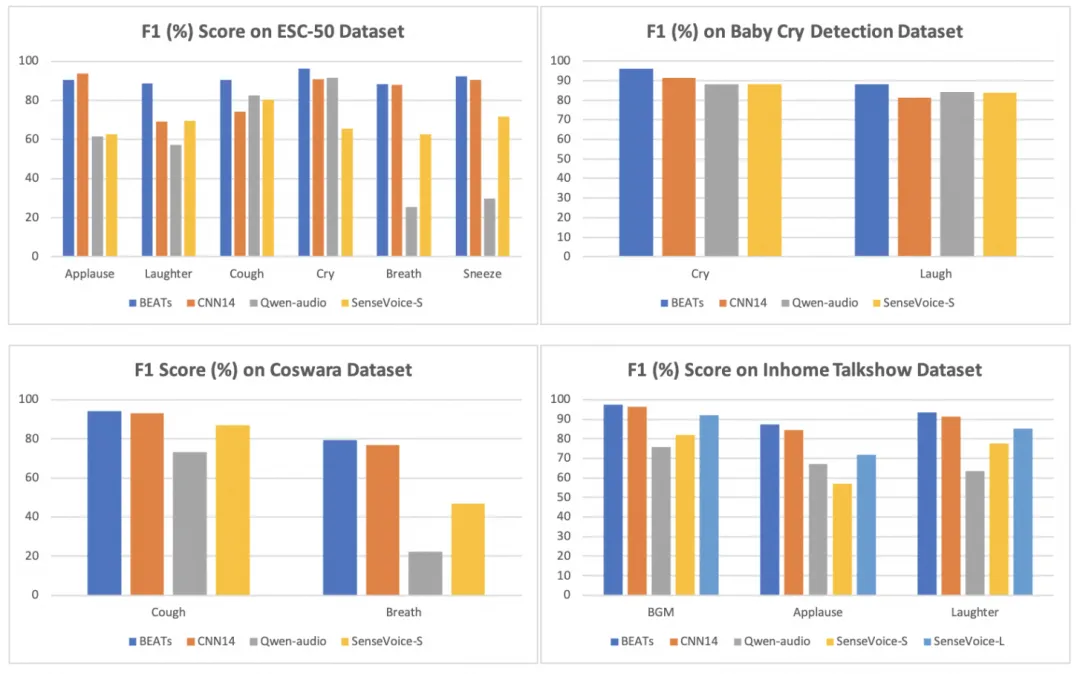
SenseVoiceSmall能在语音中检测音频事件,包括音乐、掌声和笑声,以及在人机互动过程中可能出现的咳嗽、打喷嚏、呼吸和哭泣等。
▎软件包安装使用指南
https://github.com/modelscope/FunASR/blob/main/runtime/readme_cn.md
>>>步骤:
# 如果您已安装docker,忽略本步骤
curl -O https://isv-data.oss-cn-hangzhou.aliyuncs.com/ics/MaaS/ASR/shell/install_docker.sh;
sudo bash install_docker.sh
第一步:镜像启动
sudo docker pull \
  registry.cn-hangzhou.aliyuncs.com/funasr_repo/funasr:funasr-runtime-sdk-cpu-0.4.6
mkdir -p ./funasr-runtime-resources/models
sudo docker run -p 10095:10095 -it --privileged=true \
  -v $PWD/funasr-runtime-resources/models:/workspace/models \
  registry.cn-hangzhou.aliyuncs.com/funasr_repo/funasr:funasr-runtime-sdk-cpu-0.4.6
第二步:服务端启动
cd FunASR/runtime; nohup bash run_server.sh --model-dir iic/SenseVoiceSmall-onnx > log.out 2>&1 & 第三步:测试与使用
等待服务端启动后,可以用客户端进行测试,支持python/c++/java/html网页等语言。
客户端下载地址:
https://isv-data.oss-cn-hangzhou.aliyuncs.com/ics/MaaS/ASR/sample/funasr_samples.tar.gz
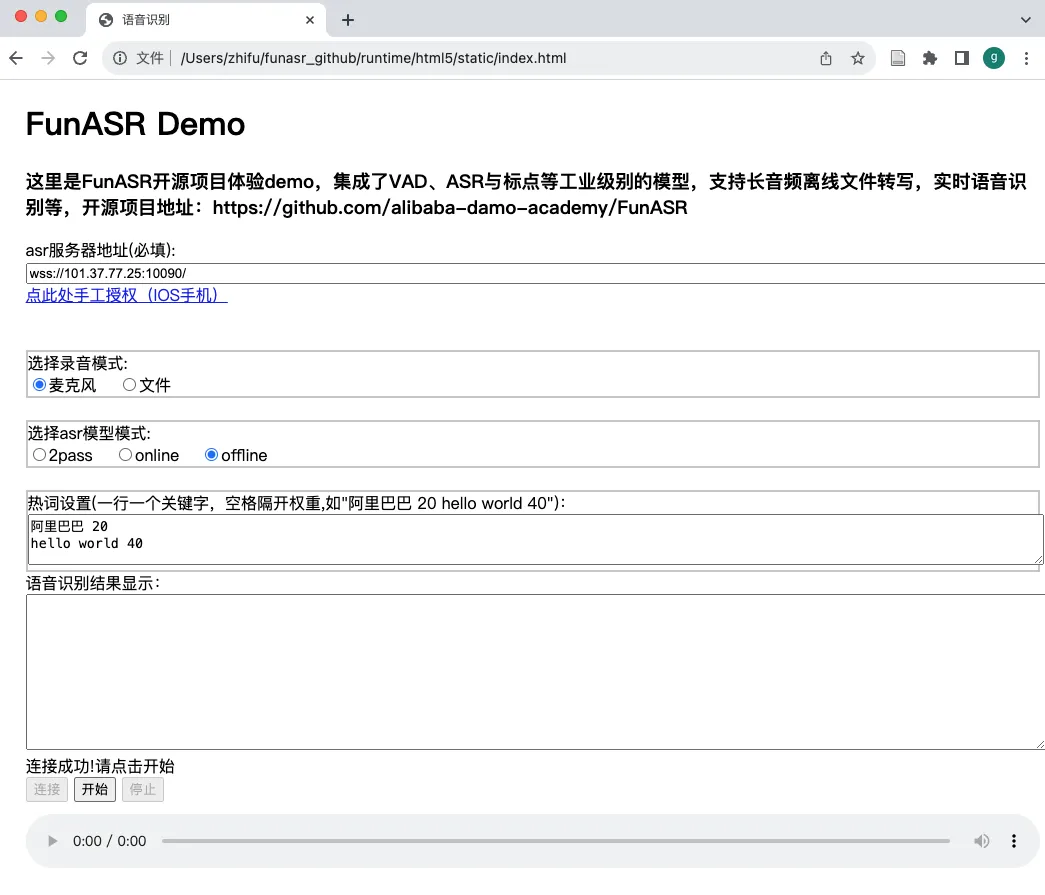
图5 html网页客户端体验
同时我们在云端部署了FunASR离线文件转写、实时语音听写等服务,用户可以直接在浏览器中进行体验:https://www.funasr.com/#/
