语音小管家
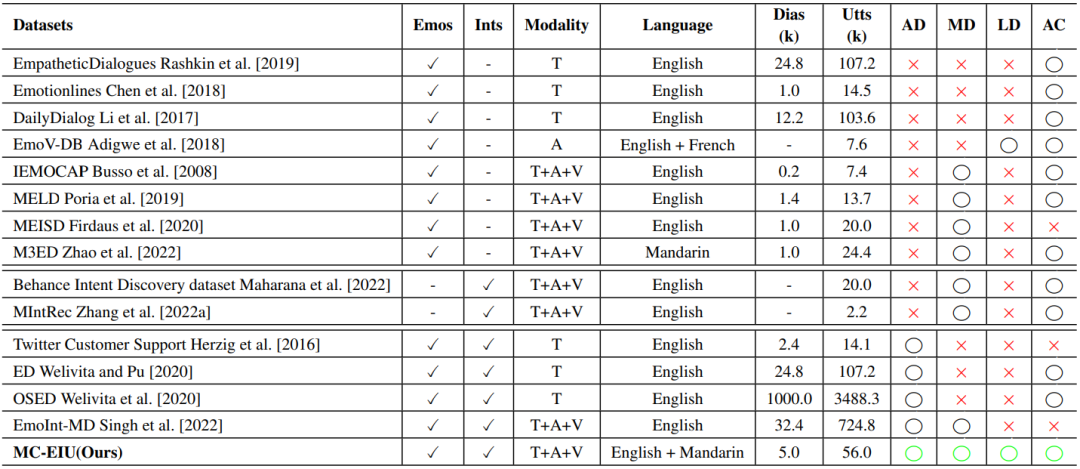
内蒙古大学S2LAB 刘瑞研究员联合中科院自动化所、华南理工大学、德国慕尼黑工业大学、香港中文大学(深圳)等单位推出了涵盖中英双语的多语种多模态对话情感意图联合理解数据集——MC-EIU。该数据集共计53小时,涉及到7种情感类别,9种意图类别,涵盖了文本、声学、视觉三种模态信息,由英语和普通话两个子集组成,总计56012条语句。该数据集已在GitHub等平台开源。在Hugging Face平台开放了数据下载页面。🚀🚀🚀
📌Hugging Face数据集页面:https://huggingface.co/datasets/YulangZhuo/MC-EIU
📌GitHub数据/源代码仓库:https://github.com/AI-S2-Lab/MC-EIU-main
📌 arXiv预印本论文:https://arxiv.org/abs/2407.02751
MC-EIU 数据集简介:
🔎超53小时多模态对话数据,数据源自互联网的电视剧片段。 🌏支持两种语言:英文(En)和普通话(Zh) 📣丰富的对话场景,涵盖多种对话主题和内容。 🏆提供了7种情感标注和9种意图标注。
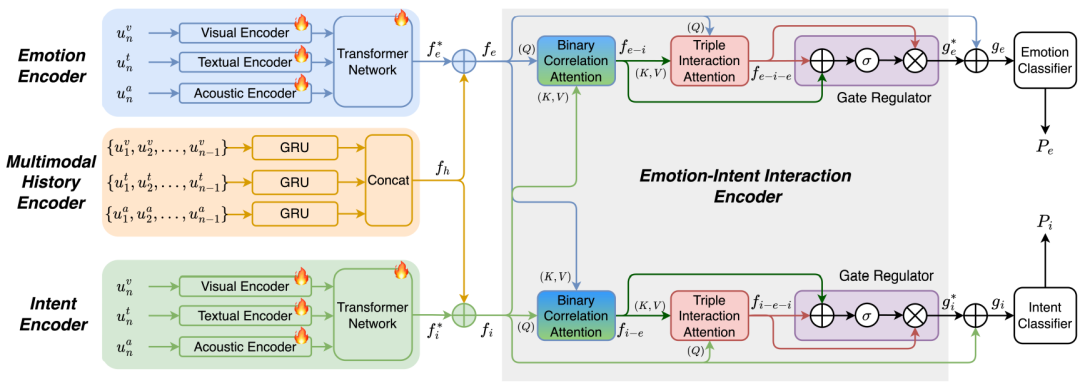
情感-意图交互(EI2)网络结构图