
 语音小管家
通义实验室开源 ClearerVoice-Studio,一个集成语音增强、语音分离和音视频说话人提取等功能的语音处理框架。通过融合复数域深度学习算法,我们大幅提升了语音降噪和分离的性能,能够最大限度地消除背景噪声并保留语音清晰度,同时保持语音失真最小化。
💡 ClearerVoice-Studio 能为您做什么?
高效去除背景噪声,将嘈杂语音处理成高质量、清晰的语音信号;
从复杂音频混合中轻松分离目标语音,满足多种语音处理需求;
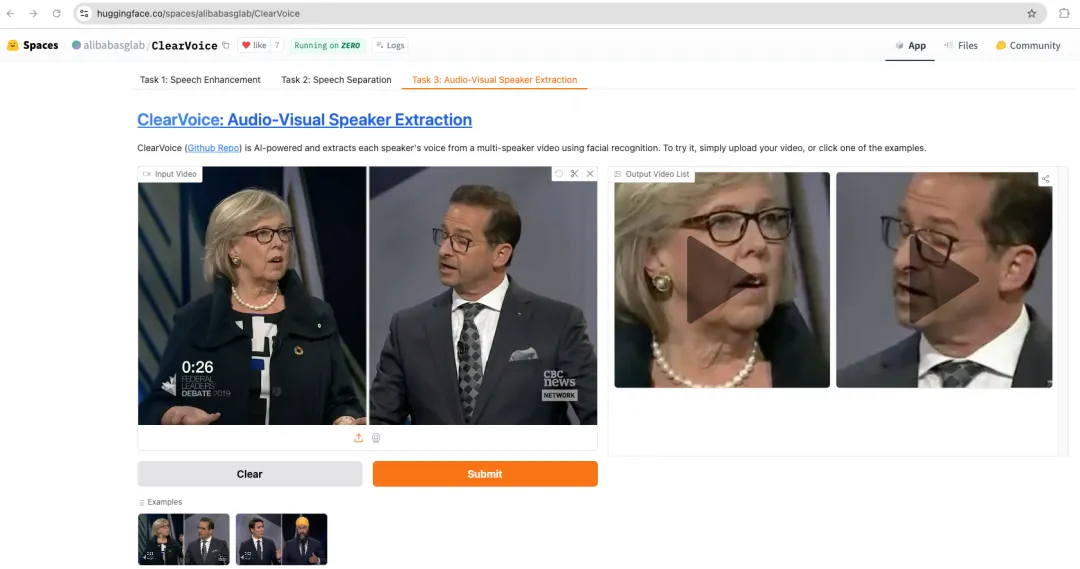
使用音视频结合的模型精确提取目标说话人的语音信号;
使用模型训练和调优工具进行模型效果打磨;
📂 代码仓库
GitHub 仓库:ClearerVoice-Studio:https://github.com/modelscope/ClearerVoice-Studio 在线 Demo:Hugging Face Space:https://huggingface.co/spaces/alibabasglab/ClearVoice
▎核心模型与算法亮点
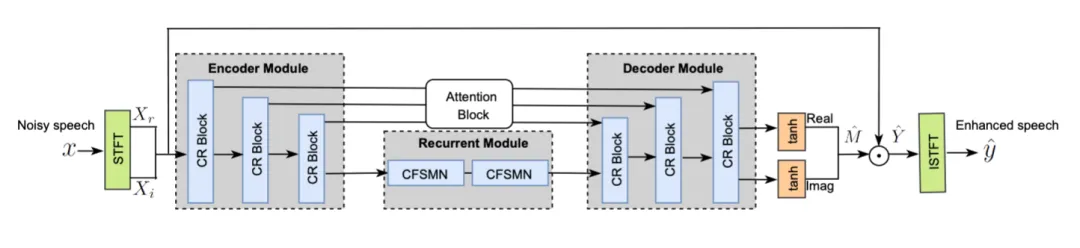
FRCRN 模型:在 2022 年 IEEE/INTER Speech DNS Challenge 中取得整体第二的优异成绩,展现出卓越的语音增强能力。
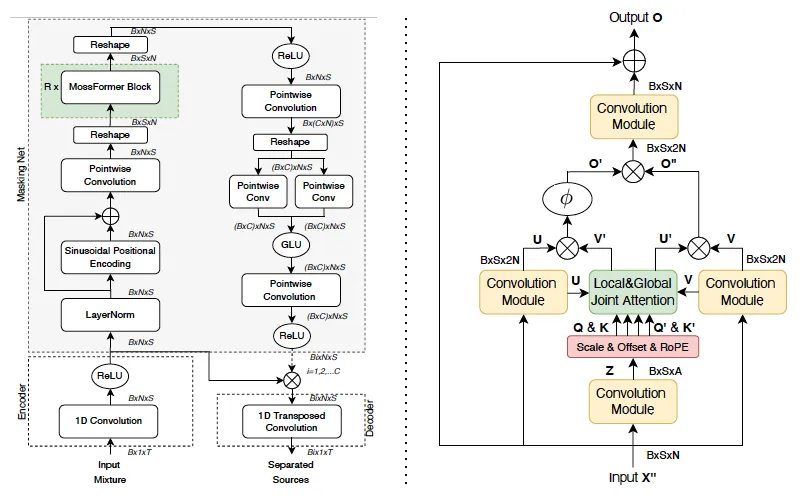
MossFormer 系列模型:在语音分离任务中表现卓越,首次超越 SepFormer,获得业内广泛认可。目前,MossFormer 框架已扩展至语音增强和目标说话人提取任务。基于 MossFormer2 的 48kHz 语音增强模型在有效抑制噪声的同时,大幅降低了语音失真。
我们致力于将这些先进模型和算法通过 ClearerVoice-Studio 平台开放给更多用户,希望为开发者、研究者和企业提供强大的语音处理工具,助力创新应用落地。
▎效果体验
如何操作:
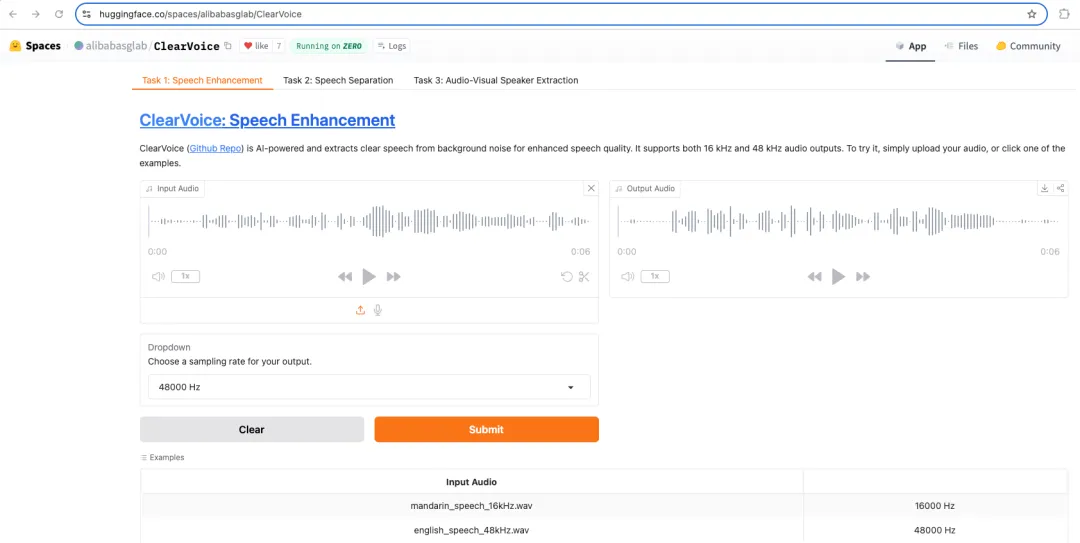
准备一段包含噪声的语音文件;
上传至指定页面; 一键处理后,您可以在线试听,也可以下载处理结果到本地。即刻获得清晰的音质、和卓越的降噪效果。
相关文献参考:
