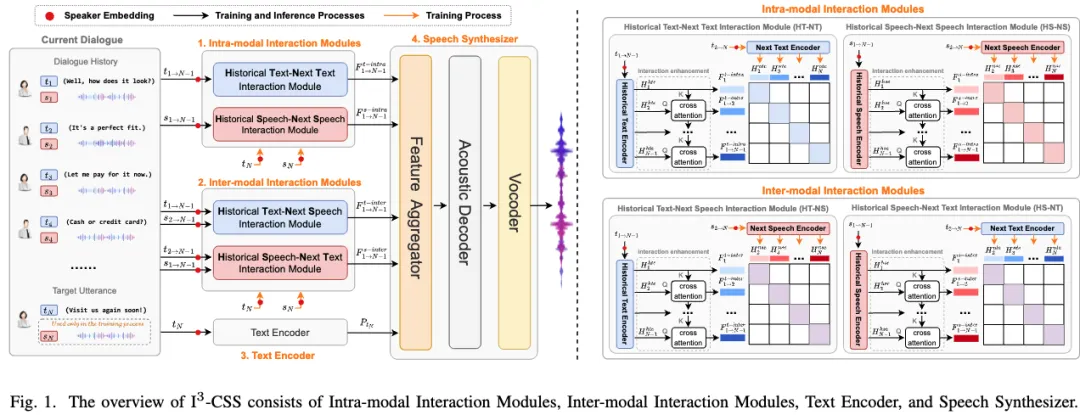
近日,2025年IEEE声学、语音与信号处理国际会议(2025 IEEE International Conference on Acoustics, Speech, and Signal Processing, ICASSP 2025)发布录用通知,内蒙古大学语音理解与生成实验室共3篇论文被录用。 实验室此次被录用的3篇论文涉及智能语音交互领域的诸多研究方向,包括对话语音合成、视频配音、大语言模型辅助的视觉语音合成等。
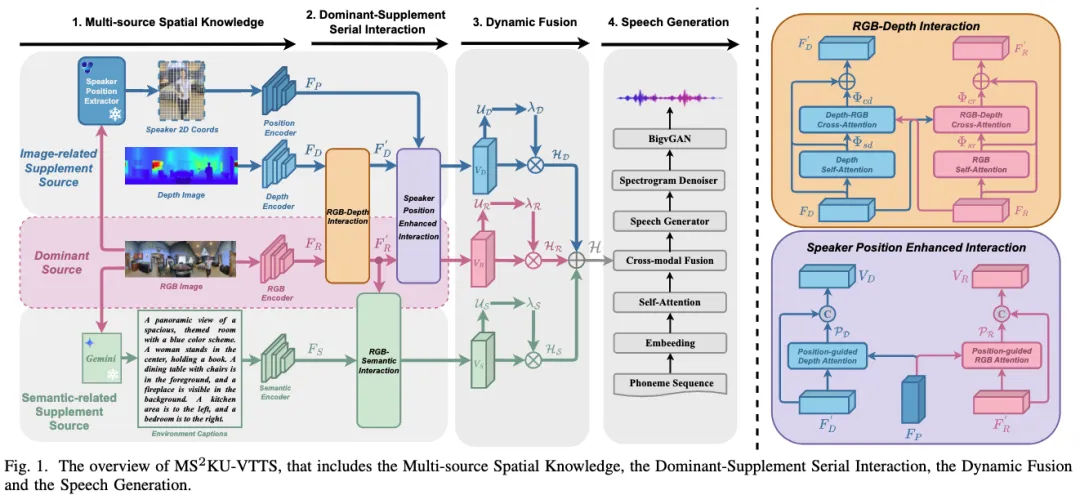
论文题目:Multi-Source Spatial Knowledge Understanding for Immersive Visual Text-to-Speech作者:何树伟,刘瑞
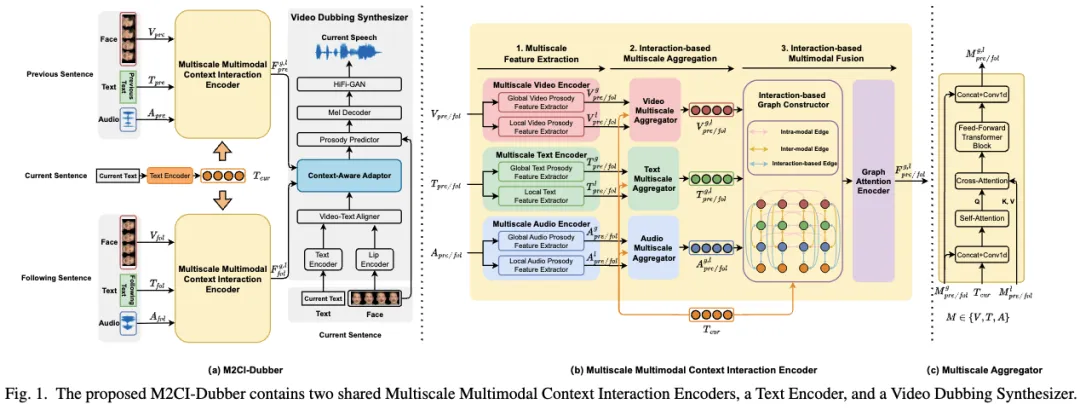
论文题目:Towards Expressive Video Dubbing with Multiscale Multimodal Context Interaction作者:赵源,刘瑞,丛高翔(中科院计算所)
工作简介:
自动视频配音(Automatic Video Dubbing,AVD)从脚本中生成与嘴唇运动和面部情绪对齐的语音。最近的研究关注建模多模态上下文以增强韵律表达,但忽略了两个关键问题:1)上下文中的多尺度韵律表达属性影响当前句子的韵律。2)上下文中的韵律线索与当前句子互动,影响最终的韵律表达。为了解决这些挑战,我们提出了M2CI-Dubber,一种用于AVD的多尺度多模态上下文交互方案。该方案包括两个共享的M2CI编码器,用于建模多尺度多模态上下文并促进其与当前句子的深度交互。通过为上下文中的每种模态提取全局和局部特征,利用基于注意力机制的聚合和交互,并采用基于交互的图注意力网络进行融合,所提出的方法增强了合成语音的韵律表达,使其更适合当前句子。对Chem数据集上的实验证明,我们的模型在配音表现方面优于基线模型。代码和Demo:https://github.com/AI-S2-Lab/M2CI-Dubber
 语音小管家