
 语音小管家
InspireMusic是由通义实验室开源的音乐生成技术,旨在打造一款集音乐生成、歌曲生成、音频生成能力为一体的开源AIGC工具包。
🎶 主要特点
统一的音频生成框架:基于音频大模型技术,InspireMusic支持音乐、歌曲及音频的生成,为用户提供多样化选择;
灵活可控生成:基于文本提示和音乐特征描述,用户可精准控制生成音乐的风格和结构;
简单易用:简便的模型微调和推理工具,为用户提供高效的训练与调优工具。
🌟代码仓库
GitHub 仓库:InspireMusic(https://github.com/FunAudioLLM/InspireMusic) Online Demo:
ModelScope创空间:https://modelscope.cn/studios/iic/InspireMusic/summary
▎核心模型
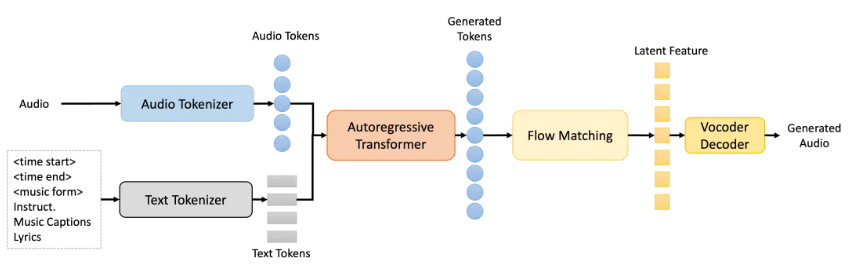
InspireMusic由音频tokenizer、自回归Transformer模型、基于常微分方程的扩散模型即Conditional Flow Matching (CFM)模型、Vocoder所组成,可支持文本生成音乐、音乐续写等任务。
通过具有高压缩比的单码本WavTokenizer将输入的连续音频特征转换成离散音频token,然后利用基于Qwen模型初始化的自回归Transformer模型预测音频token,再由CFM扩散模型重建音频的潜层特征,最终通过Vocoder输出高质量的音频波形。
两种推理模式的设计:fast模型和高音质模型,为不同需求的用户提供了灵活的选择。
▎Demo show
🎧输入简单的文本描述生成音乐
▎工具包安装使用指南
git clone --recursive https://github.com/FunAudioLLM/InspireMusic.git
# If you failed to clone submodule due to network failures, please run the following command until success
cd InspireMusic
git submodule update --init --recursive conda create -n inspiremusic python=3.8
conda activate inspiremusic
cd InspireMusic
# pynini is required by WeTextProcessing, use conda to install it as it can be executed on all platforms.
conda install -y -c conda-forge pynini==2.1.5
pip install -r requirements.txt -i https://mirrors.aliyun.com/pypi/simple/ --trusted-host=mirrors.aliyun.com
# install flash attention to speedup training
pip install flash-attn --no-build-isolation InspireMusic-Base模型(https://www.modelscope.cn/iic/InspireMusic)
# git模型下载,请确保已安装git lfs
mkdir -p pretrained_models
git clone https://www.modelscope.cn/iic/InspireMusic.git pretrained_models/InspireMusic-Base cd InspireMusic/examples/music_generation/
bash run.sh for model in llm flow
do
torchrun --nnodes=1 --nproc_per_node=8 \
--rdzv_id=1024 --rdzv_backend="c10d" --rdzv_endpoint="localhost:0" \
inspiremusic/bin/train.py \
--train_engine "torch_ddp" \
--config conf/inspiremusic.yaml \
--train_data data/train.data.list \
--cv_data data/dev.data.list \
--model $model \
--model_dir `pwd`/exp/music_generation/llm/ \
--tensorboard_dir `pwd`/tensorboard/music_generation/llm/ \
--ddp.dist_backend "nccl" \
--num_workers 8 \
--prefetch 100 \
--pin_memory \
--deepspeed_config ./conf/ds_stage2.json \
--deepspeed.save_states model+optimizer \
--fp16
done cd InspireMusic/examples/music_generation/
bash infer.sh pretrained_model_dir = "./pretrained_models/InspireMusic/"
for task in 'text-to-music' 'continuation'; do
python inspiremusic/bin/inference.py --task $task \
--gpu 0 \
--config conf/inspiremusic.yaml \
--prompt_data data/test/parquet/data.list \
--flow_model $pretrained_model_dir/flow.pt \
--llm_model $pretrained_model_dir/llm.pt \
--music_tokenizer $pretrained_model_dir/music_tokenizer \
--wavtokenizer $pretrained_model_dir/wavtokenizer \
--result_dir `pwd`/exp/inspiremusic/${task}_test \
--chorus verse \
--min_generate_audio_seconds 8 \
--max_generate_audio_seconds 30
done
pretrained_model_dir = "./pretrained_models/InspireMusic/"
for task in 'text-to-music' 'continuation'; do
  python inspiremusic/bin/inference.py --task $task \
      --gpu 0 \
      --config conf/inspiremusic.yaml \
      --prompt_data data/test/parquet/data.list \
      --flow_model $pretrained_model_dir/flow.pt \
      --llm_model $pretrained_model_dir/llm.pt \
      --music_tokenizer $pretrained_model_dir/music_tokenizer \
      --wavtokenizer $pretrained_model_dir/wavtokenizer \
      --result_dir `pwd`/exp/inspiremusic/${task}_test \
      --chorus verse \
      --fast True \
      --min_generate_audio_seconds 8 \
      --max_generate_audio_seconds 30
done
相关文献参考:
【1】Shengpeng Ji, Ziyue Jiang, Wen Wang, Yifu Chen, Minghui Fang, Jialong Zuo, Qian Yang, Xize Cheng, Zehan Wang, Ruiqi Li, Ziang Zhang, Xiaoda Yang, Rongjie Huang, Yidi Jiang, Qian Chen, Siqi Zheng, Wen Wang, Zhou Zhao, WavTokenizer: an Efficient Acoustic Discrete Codec Tokenizer for Audio Language Modeling. arXiv. Available at:https://arxiv.org/abs/2408.16532., 2024
