
 语音小管家
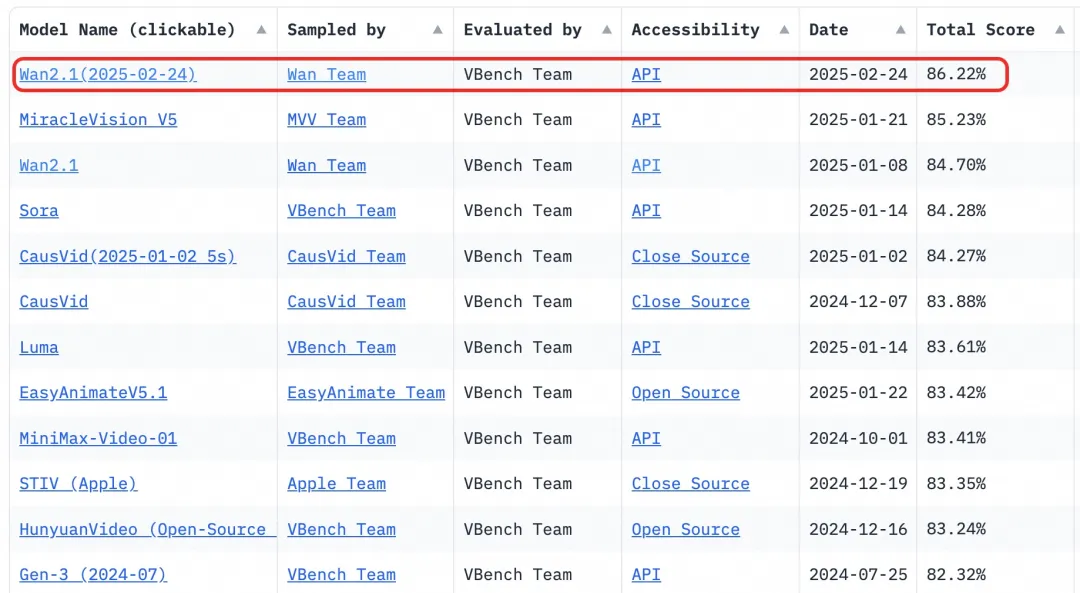
#模型性能
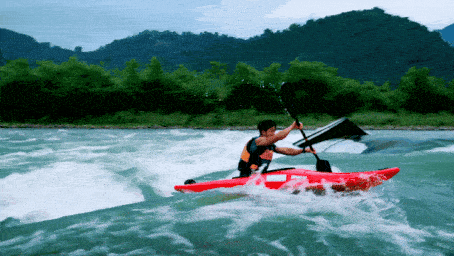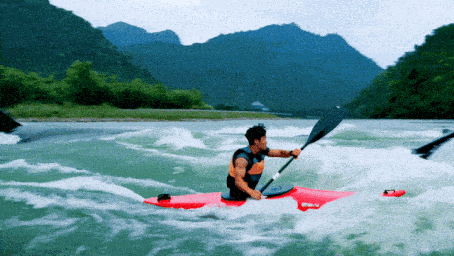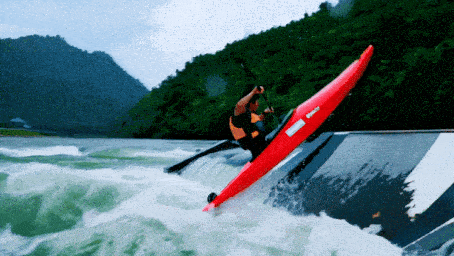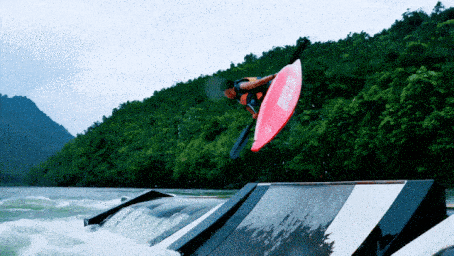
在指令遵循能力方面,能够准确理解中英文长文本指令,还原各种场景切换、角色互动。
#关键技术
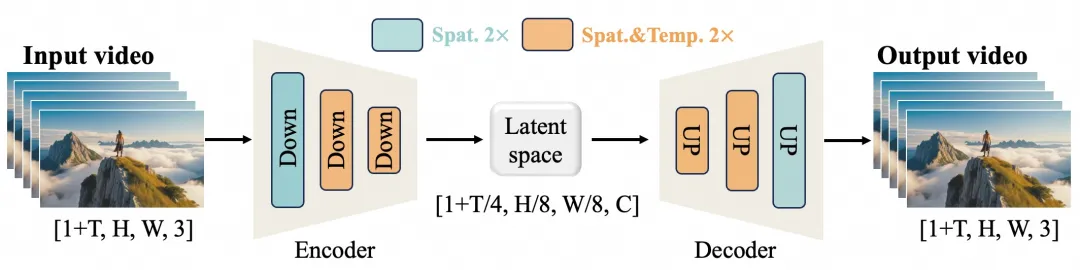
高效的因果3D VAE:万相自研了一种专为视频生成设计的新型因果3D VAE架构,并结合多种策略来改进时空压缩、降低内存使用以及确保时间因果性。
视频Diffusion Transformer:万相模型架构基于主流的视频DiT结构,通过Full Attention机制确保长时程时空依赖的有效建模,实现时空一致的视频生成。
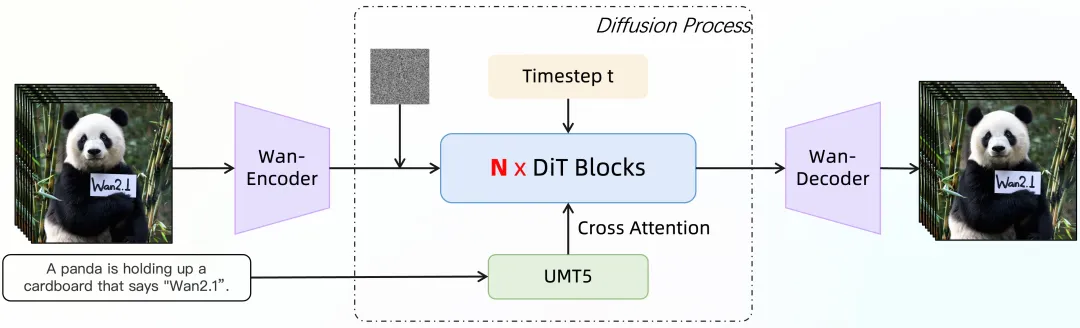
万相视频模型架构图
模型训练和推理效率优化:训练阶段,对于文本、视频编码模块,我们使用DP 和FSDP 组合的分布式策略;对于DiT模块,我们采用DP、FSDP、RingAttention、Ulysses混合的并行策略。在推理阶段,为了使用多卡减少生成单个视频的延迟,我们需要选择CP来进行分布式加速。此外,当模型较大时,还需要进行模型切分。
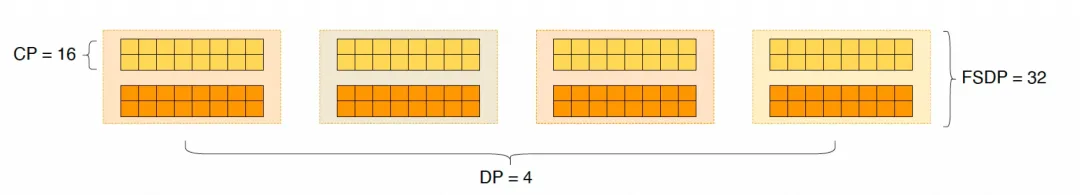
DiT并行策略
2023年8月,阿里云率先开源Qwen模型,正式拉开了开源大模型的序幕。随后,Qwen1.5、Qwen2、Qwen2.5等四代模型相继开源,覆盖了从0.5B到110B的全尺寸范围,涵盖大语言、多模态等领域。目前其千问(Qwen)衍生模型数量已超过10万个。其官方文章显示,随着万相的开源,阿里云实现了全模态、全尺寸的开源。
从大语言模型到视觉生成模型,从基础模型到多样化的衍生模型,开源生态的发展正不断被注入强大的动力。
