
 语音小管家
近日,Nari Labs开源了Dia-1.6B,能够生成关于任何主题的对话,语音音色自然,还会添加语气、咳嗽声、笑声等。
GitHub 项目地址:https://github.com/nari-labs/dia
HF 模型地址:https://huggingface.co/nari-labs/Dia-1.6B
在线Demo:https://huggingface.co/spaces/nari-labs/Dia-1.6B
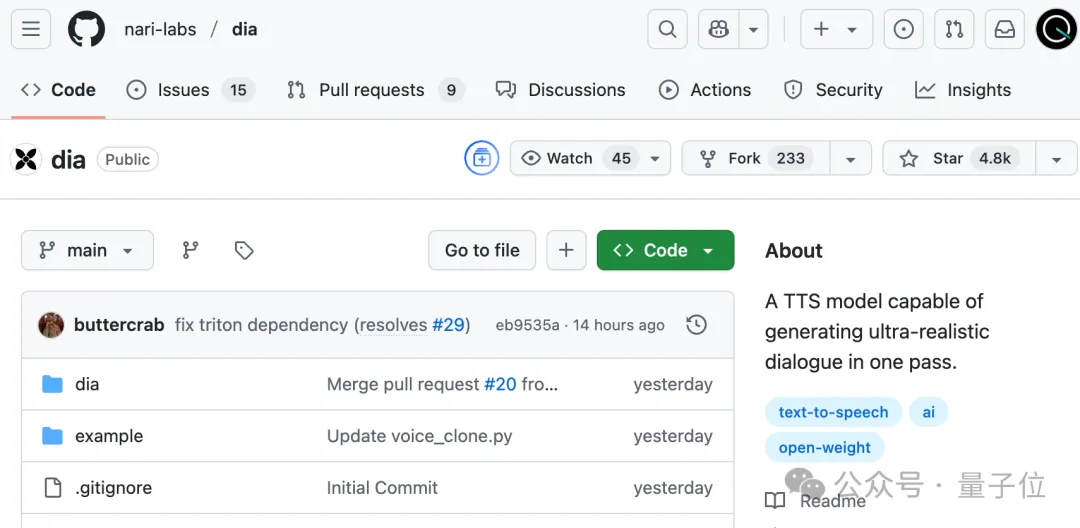
Dia-1.6B模型权重与推理代码全开源,在GitHub上不到一天就获得近5000标星。
目前Dia 1.6B在单张英伟达RTX A4000上每秒约可生成40个token,而86个token大约是1秒的音频内容。
也就是说,在更强的GPU或者多卡配置下可以做到实时生成音频。
官方表示完整版模型需要10GB显存运行,未来会添加量化版本,以及CPU支持。
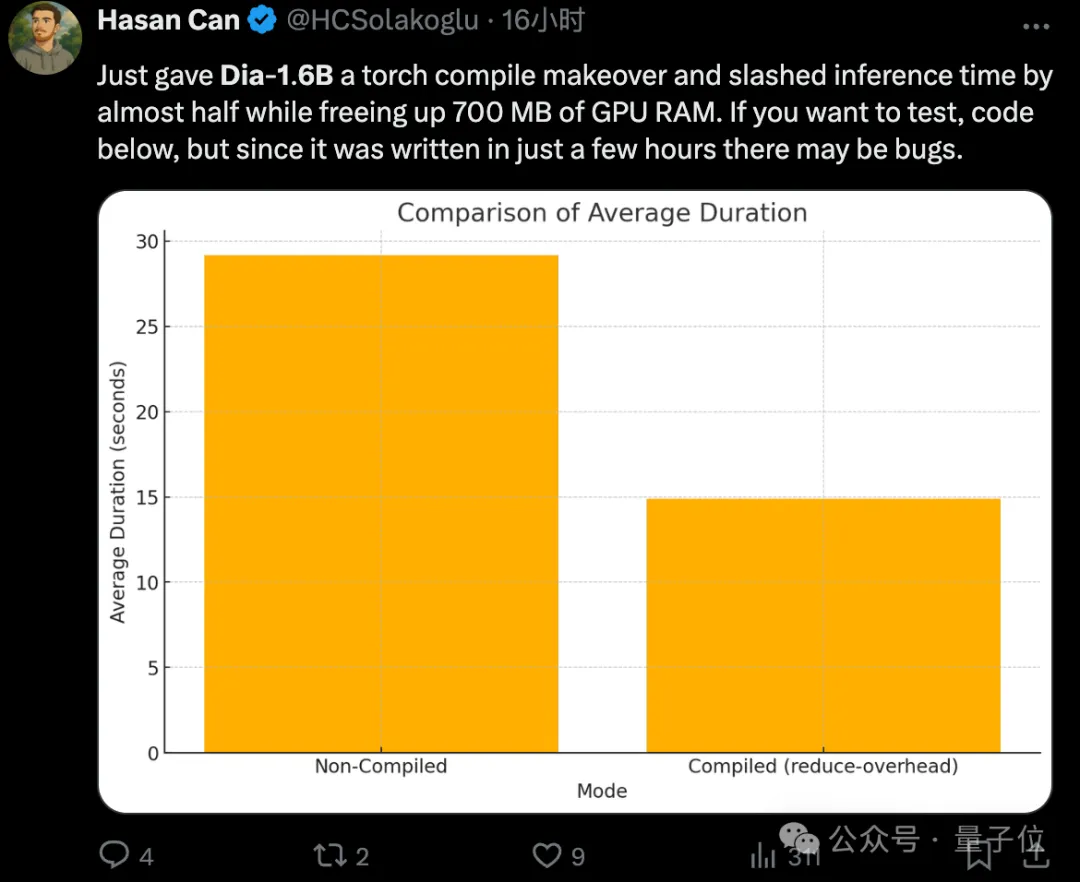
不过开源社区已经通过优化torch编译进一步提高推理速度和节省显存。
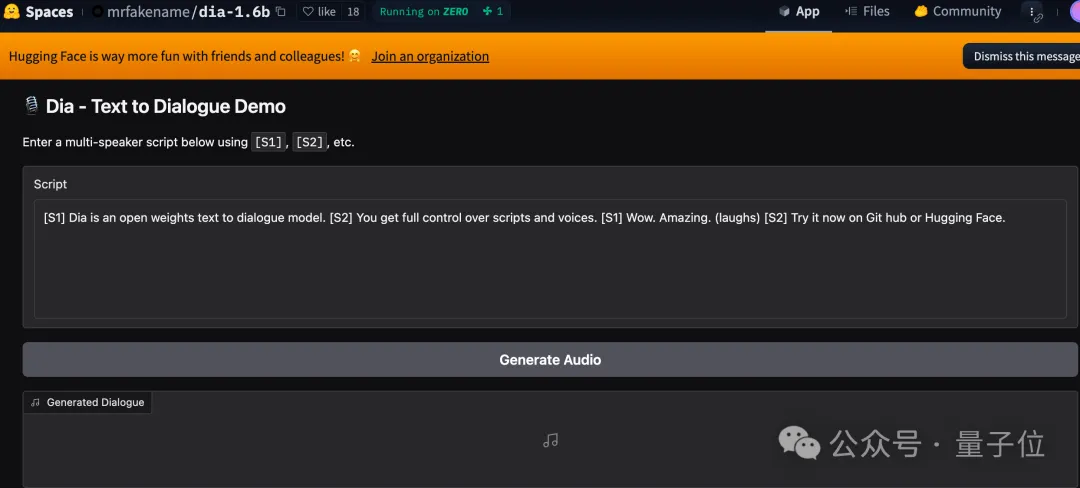
如果没有算力资源,也可以到HuggingFace试玩Demo,不过很可惜,目前版本不支持中文。
真实语气语音生成
使用Dia-1.6B非常简单,用[s1] [s2]标签带标两个不同的音色,目前模型为针对任何音色微调,每次都会随机得到不同的音色。
如果想保持特定音色,可以添加音色提示词(教程稍后发布)或固定随机种子。
语气会自动适应文字内容,如官方演示中一段与着火了有关的对话,AI语气就明显紧张起来。
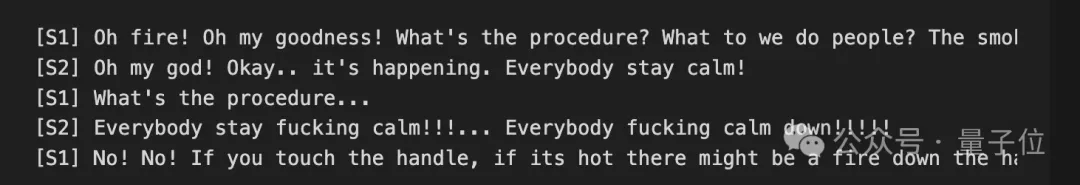
相比之下,Eleven Labs和Seasame模型生成的语气还是不紧不慢的。
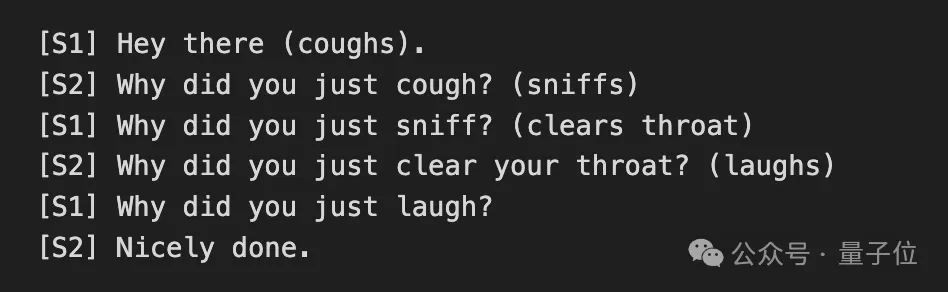
只需使用括号可添加咳嗽、吸鼻子、清嗓子、笑声等要素,特别是笑声会与。其他模型暂不支持这个功能。
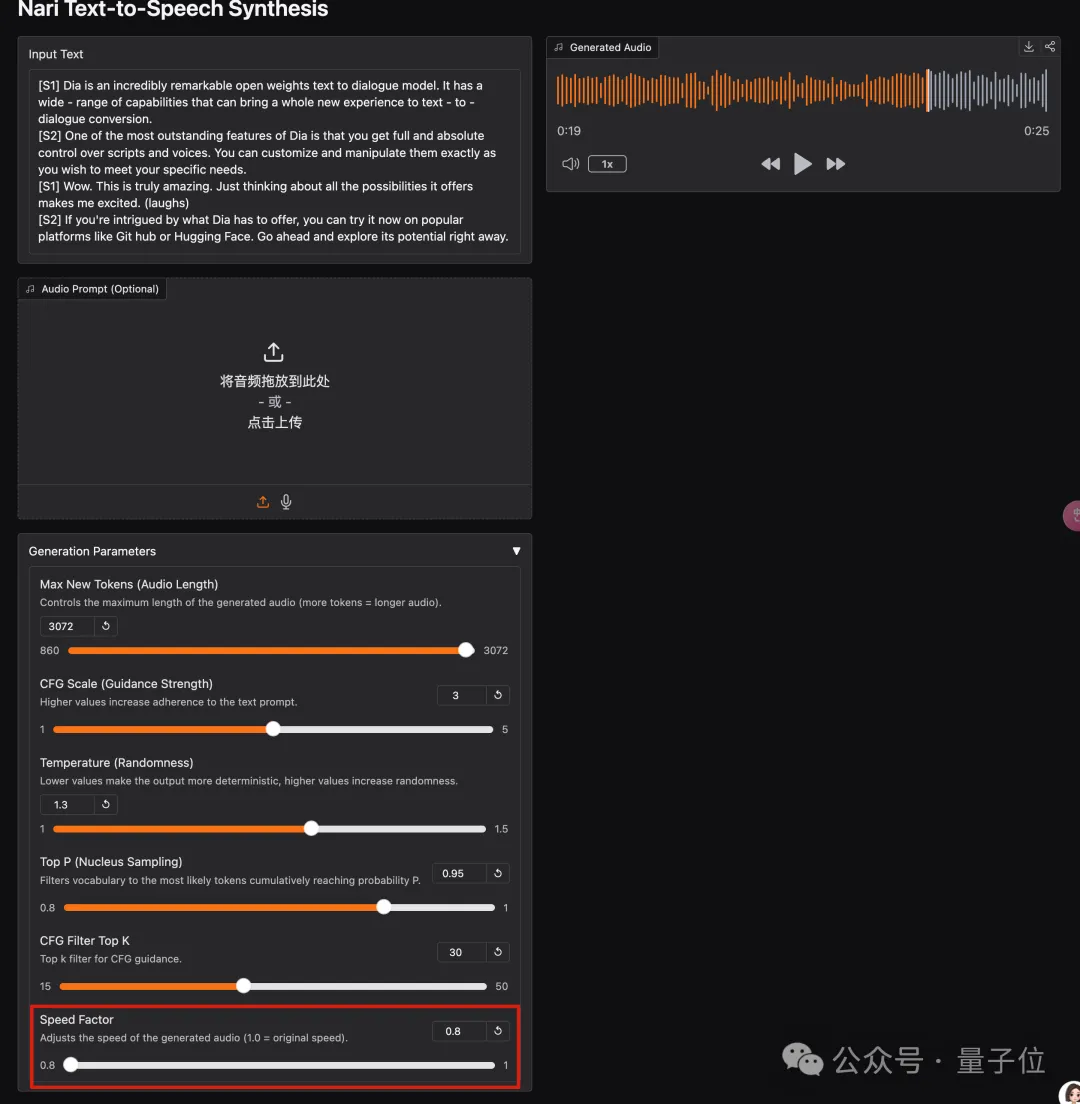
不过目前版本的在线Demo也有一些问题,由于最大生成时长相对固定,输入的文字越多语速就会越快。
如果在参数中调整速度因子,会像调整音频播放速度一样让声音更低沉,没那么自然了。
快速上手
安装部署与使用步骤:
1、克隆项目
gitclonehttps://github.com/nari-labs/dia.gitcddia
2、创建虚拟环境
python -m venv .venvsource.venv/bin/activate
3、安装依赖
pip install -e .
4、启动 Gradio UI
python app.py
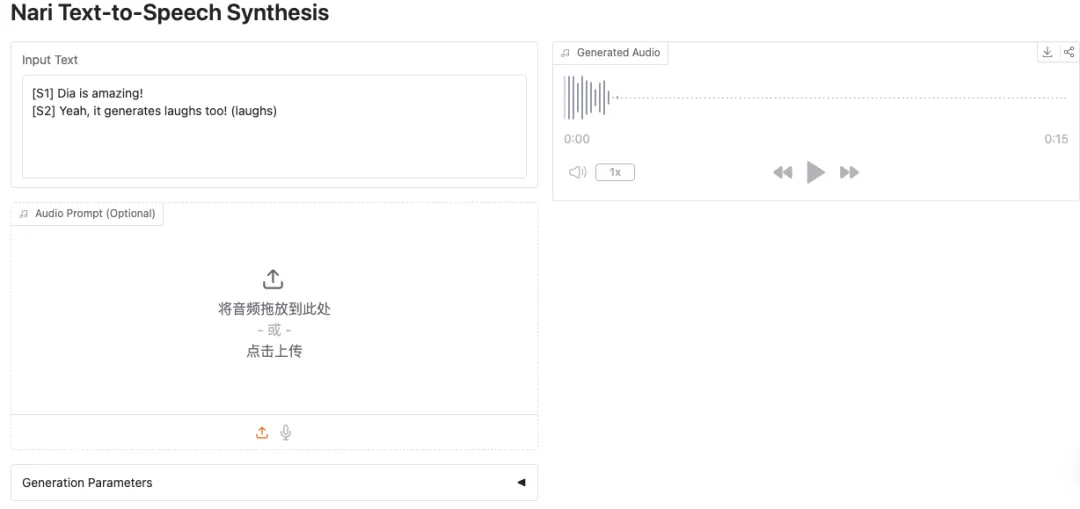
访问http://localhost:7860,输入脚本或上传音频,生成对话。
示例脚本:
[S1] Dia is amazing! [S2] Yeah, it generates laughs too! (laughs)
还可以通过 Python 包安装 Dia 的API
# Install directly from GitHub
pip install git+https://github.com/nari-labs/dia.git
Python 调用示例:
import soundfile as sf

from dia.model import Dia


model = Dia.from_pretrained("nari-labs/Dia-1.6B")

text = "[S1] Dia is an open weights text to dialogue model. [S2] You get full control over scripts and voices. [S1] Wow. Amazing. (laughs) [S2] Try it now on Git hub or Hugging Face."

output = model.generate(text)

sf.write("simple.mp3", output, 44100)
后续也将推出 pypi包和CLI工具。
两位本科生自学3个月打造
Nari Lab创始成员Toby Kim与Jaeyong Sung,来自韩国首尔大学和韩国科学技术院(KAIST),其中还有一人在服兵役兼职工作,整个项目0融资启动,自学3个月完成。
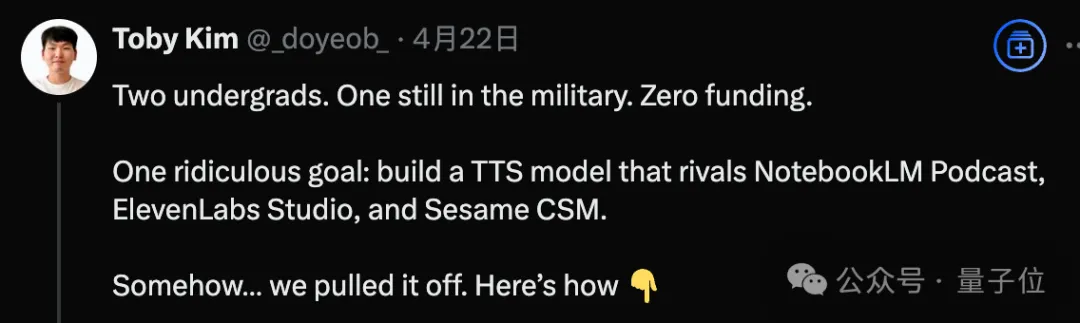
Toby Kim透露项目灵感正是来自谷歌去年爆火的NoteBook LM自动生成播客对话功能,但他们想要对声音的控制力更强,脚本的自由度更高。
他们尝试了当时市面上所有的文本转语音API后,认为没有一个听起来像真实的人类对话。
于是他们靠申请免费的谷歌研究计划TPU资源训练模型,并推荐学习入门TPU的团队去看DeepMind的《How to Scale Your Model》 和HuggingFace的《Ultra-Scale Playbook》
未来,他们计划把Dia打造成一款完整应用,可以创建有趣的对话、重新组合内容并与好友分享。
参考链接:
[1] https://x.com/_doyeob_/status/1914464979266449863
[2] https://techcrunch.com/2025/04/22/two-undergrads-built-an-ai-speech-model-to-rival-notebooklm/
