
 语音小管家
昨天,阿里通义开源新一代语音交互模型 Fun-Audio-Chat-8B。该模型在OpenAudioBench、VoiceBench、UltraEval-Audio、MMAU、MMSU、SpeechFunctionCall 等多项权威基准测评中,超过一众同量级开源模型。
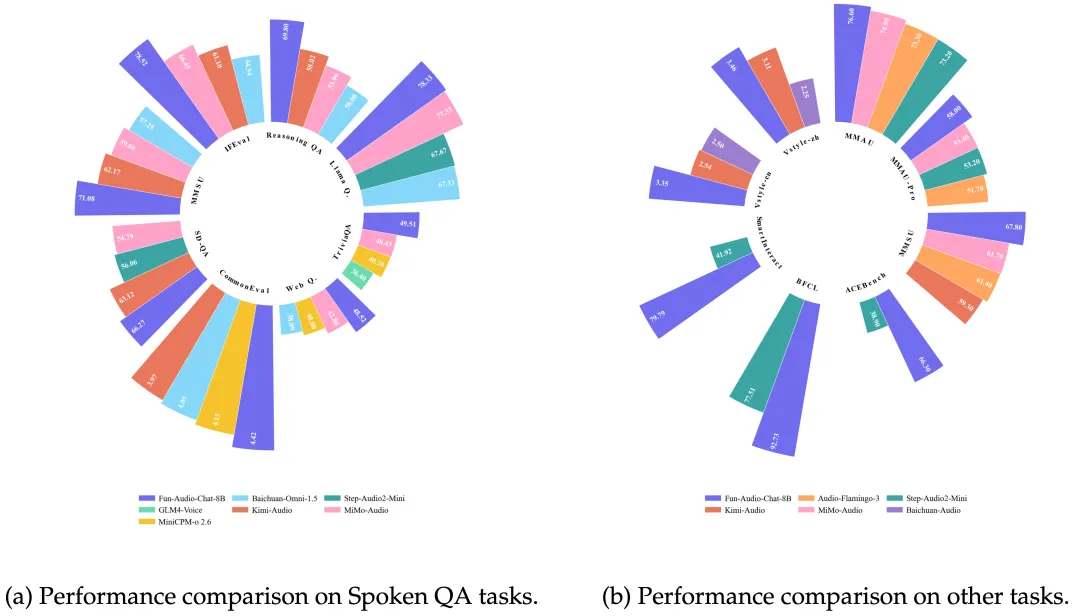
Fun-Audio-Chat 是为自然、低延迟语音交互构建的大型音频语言模型。它引入了双分辨率语音表示(一个高效的 5Hz 共享主干 + 一个 25Hz 的精炼头)以在降低计算的同时保持高语音质量,并采用 Core-Cocktail 训练以保留强大的文本LLM能力。它在语音问答、音频理解、语音函数调用以及语音指令遵循和情感共鸣基准上都取得了顶级成果。
模型开源下载地址
ModelScope:https://modelscope.cn/FunAudioLLM/Fun-Audio-Chat-8B
HuggingFace:https://huggingface.co/FunAudioLLM/Fun-Audio-Chat-8B
⏩高效低算力架构,节省近50%GPU计算
在加入大规模语音、多模态能力后,Fun-Audio-Chat-8B还能保持“原有智商”,得益于两个创新的音频模型训练模式。
采用Core-Cocktail两阶段训练策略,先快速学新本事,再把“新本事”和“老底子”融合起来,为了避免学新东西把原来的能力忘掉(灾难性遗忘),第一阶段训练得到的模型和原始的纯文本大模型参数合并后,再进行微调。
与人类偏好对齐。通过多阶段和多任务的后训练设计,模型在真实对话场景中能更好地理解用户语音内容与情绪线索,作出更自然、更符合人类期望的回应。
此外,Fun-Audio-Chat-8B的高效低算力架构也是重大创新,通过压缩-自回归-解压缩的双分辨率端到端设计,音频帧率降到业界最低的5Hz,在保证语音质量的同时节省近50%GPU计算。
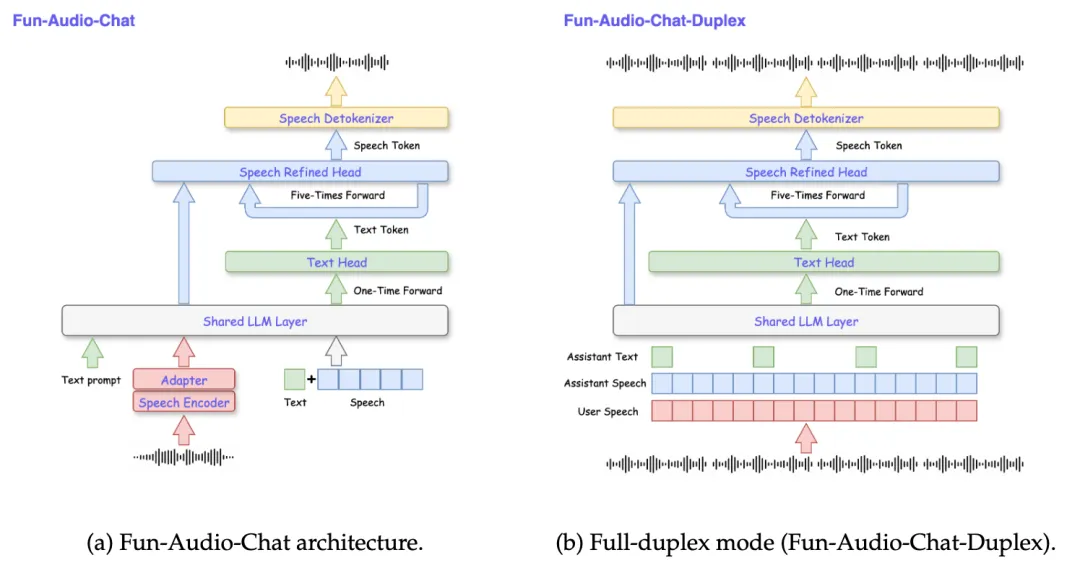
Fun-Audio-Chat-8B模型架构,
通过压缩-自回归-解压缩设计,节省近 50% GPU 计算
⏩出色共情对话能力,可自动感知用户情绪
无提示词、情绪标签下可自动感知用户情绪
没有任何情绪标签或提示词的情况下,该模型能通过用户的语义、语气、语速、停顿、重音等细微信号,感知对方的情绪状态,并给出恰到好处的关切、安慰或鼓励式回应。
支持角色扮演等量身定制语音
用户还可尝试角色扮演,量身定制语音的情绪、说话风格、语速、高低音和音量等。
