
 语音小管家
近日,阶跃星辰开源的原生语音推理模型Step-Audio-R1 更新升级至Step-Audio-R1.1,并在全球知名权威大模型评测榜单 Artificial Analysis Speech Reasoning 登顶榜首。
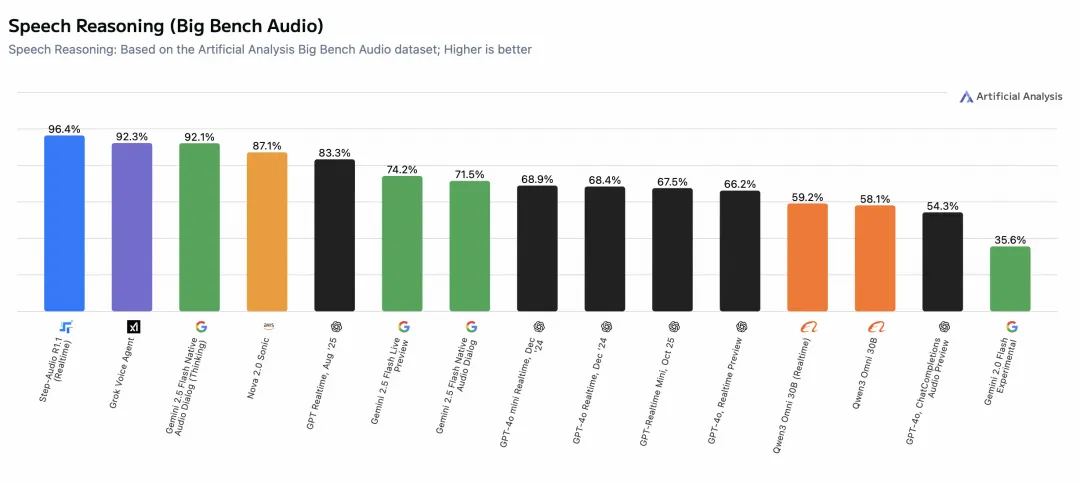
该榜单是目前业界评估“原生语音模型”(Native Audio Models)最权威的第三方基准之一。核心考量模型直接处理音频并进行复杂逻辑推理的能力,主要考察维度包括准确率、首包延迟等。
和大语言模型同理,语音模型同样需要具备强大推理能力,才能提供更高阶智能、更自然交互。
Step-Audio-R1.1 以 96.4% 准确率,超越 Grok、Gemini、GPT-Realtime 等主流一线模型,刷新历史最好成绩。
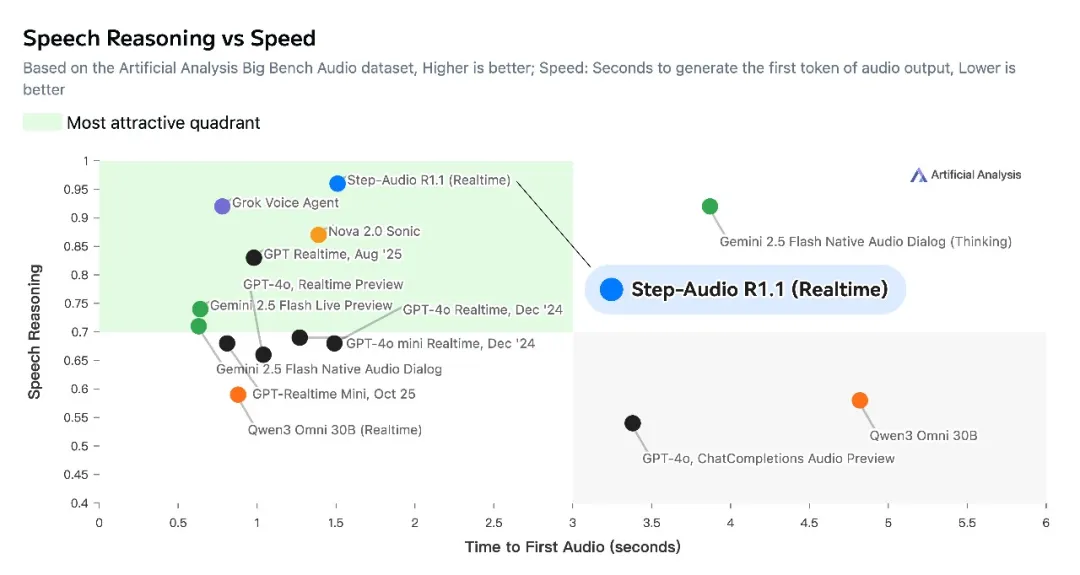
核心能力包括:
深度语音推理
实时响应能力
音频领域的可扩展 CoT
Step-Audio-R1.1 是最新升级版本,兼顾更强实时对话和复杂语音推理能力。完整的实时语音 API 将在 2 月上线,目前开放的chat模式已搭载 R1.1 核心,支持边想边说的流式推理。
目前,Step-Audio-R1.1 权重已上传至 HuggingFace:https://huggingface.co/stepfun-ai/Step-Audio-R1.1
下载体验:https://www.stepfun.com/studio/audio?tab=conversation
GitHub地址:https://github.com/stepfun-ai/Step-Audio-R1
魔搭ModelScope:https://modelscope.cn/studios/stepfun-ai/Step-Audio-R1
