
世界上有数千种语言,但真正拥有大规模标注语音数据的语言并不多。自动语音识别要走向更广阔的真实世界,关键不只是把英文或中文做得更准,而是让低资源语言、方言、混合语码和跨语言场景也能获得可靠、可扩展的语音技术。
大语言模型正在为这一问题带来新的解法。它不仅能生成文本,更能把跨语言知识、上下文推理、错误纠正和语言建模能力引入 ASR 系统。INTERSPEECH 2026 教程报告将围绕这一方向,系统梳理由 LLM 驱动的数据高效多语言与跨语言语音识别进展,为研究者和工程团队提供一份从理论到实践的路线图。
这是一场关于“让更多语言被听见”的教程,也是一场关于下一代语音识别技术路线的集中讨论。
⏩活动信息
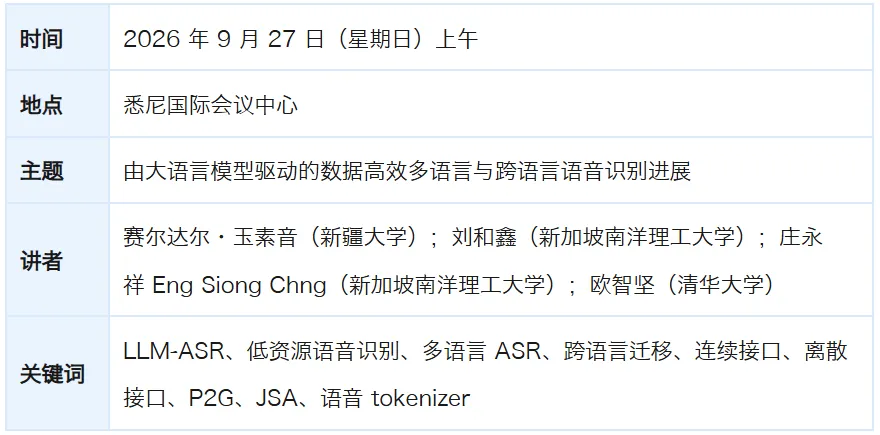
⏩为什么这场教程值得关注?
- ASR 的下一道关,不只是模型规模,而是数据效率。许多语言和真实场景缺少充足标注数据,传统“堆数据”的路径难以覆盖世界语言的多样性。
- LLM-ASR 正从“尝试连接”走向“方法体系”。连续接口、离散接口、错误纠正、音素到字素转换、免发音词典训练、语音 tokenizer 等路线,正在形成清晰的技术版图。
- 低资源、多语言和跨语言部署,是语音技术普惠化的关键战场。让更多语言被准确识别,是语音智能走向全球真实应用的重要一步。
- 本教程兼具框架、方法和实践路线。参与者不仅能了解最新进展,也能获得可迁移到研究选题、系统设计和工程落地中的方法清单。
⏩四大看点
看点一:从 ASR 基础出发,重新理解 LLM-ASR。教程将回顾 CTC、AED 等现代语音识别模型,解释数据效率为何成为多语言与跨语言 ASR 的核心问题,并引出 LLM 在语音系统中的新角色。
看点二:连续接口方法——如何把“语音编码器”接入“大语言模型”。教程将系统介绍声学编码器、Linear/MLP/Transformer 投影器、卷积下采样以及模态对齐和训练策略。
看点三:离散接口方法——如何把语音转成 LLM 更擅长处理的符号。教程将覆盖基于 LLM 的 ASR 错误纠正、音素到字素(P2G)转换、DANP/TKM/SKM、联合随机逼近(JSA)免发音词典训练,以及可纳入 LLM 词表的语音 token。
看点四:面向未来的开放问题。连续接口与离散接口如何融合?低资源部署如何兼顾鲁棒性与可扩展性?语音 tokenizer 会不会成为多模态 LLM 的关键入口?这些问题将在教程中展开讨论。
⏩适合谁参加?
- 从事自动语音识别、语音语言处理、多模态大模型、低资源语言技术、多语种 NLP/SLP 研究的学者和学生。
- 关注方言、少数民族语言、混合语码、跨语言迁移、语音交互系统的研究团队。
- 希望把 LLM 能力引入 ASR 产品、语音助手、会议转写、呼叫中心、智能终端等应用的工程团队。
⏩你将带走什么?
- 一套理解 LLM-ASR 的清晰分类框架:连续接口 vs. 离散接口。
- 一份面向低资源、多语种与跨语言 ASR 的技术路线图。
- 对声学编码器、连接器、P2G、错误纠正、JSA、语音 tokenizer 等关键模块的系统认识。
- 对未来研究问题和落地挑战的判断:如何在更少数据、更复杂语言、更真实场景中构建可靠 ASR。
⏩教程安排
第 1 部分:语音识别与 LLM 基础(50 分钟,欧智坚)
- 现代语音识别模型:CTC 与基于注意力的编码器-解码器(AED)
- 多语种、多语言与跨语言语音识别中的数据效率:动机与方法
- LLM 简介:GPT 风格模型、提示技术与无监督学习思想
- LLM-ASR 概览与分类:连续接口与离散接口
第 2 部分:基于连续接口的方法(50 分钟,刘和鑫、庄永祥)
- 作为前端的声学编码器:自监督预训练、基于字素转写的监督预训练、基于音素转写的监督预训练
- 语音与 LLM 之间的连接器:Linear/MLP/Transformer 投影器、卷积下采样
- 模态对齐与训练策略:何时微调 LLM,何时微调语音编码器
第 3 部分:基于离散接口的方法(50 分钟,赛尔达尔·玉素音,欧智坚)
- 基于 LLM 的 ASR 错误纠正:使用 single-best 假设或 N-best 列表
- 面向基于音素 ASR 的 LLM 音素到字素(P2G)方法:DANP、TKM 与 SKM
- 通过联合随机逼近(JSA)实现免发音词典训练
- 结合 LLM 的语音 tokenizer:生成可纳入 LLM 词表的语音 token
第 4 部分:开放问题与未来方向(20 分钟,庄永祥,欧智坚)
- 未来 LLM-ASR 系统中的连续接口与离散接口
- 数据效率、鲁棒性与低资源部署
- 10 分钟问答与讨论
⏩讲者阵容
本次教程汇聚来自新疆大学、新加坡南洋理工大学与清华大学的研究者,覆盖多语种/低资源 ASR、语音与语言处理、LLM-ASR、半监督学习与产业化语音系统等方向。
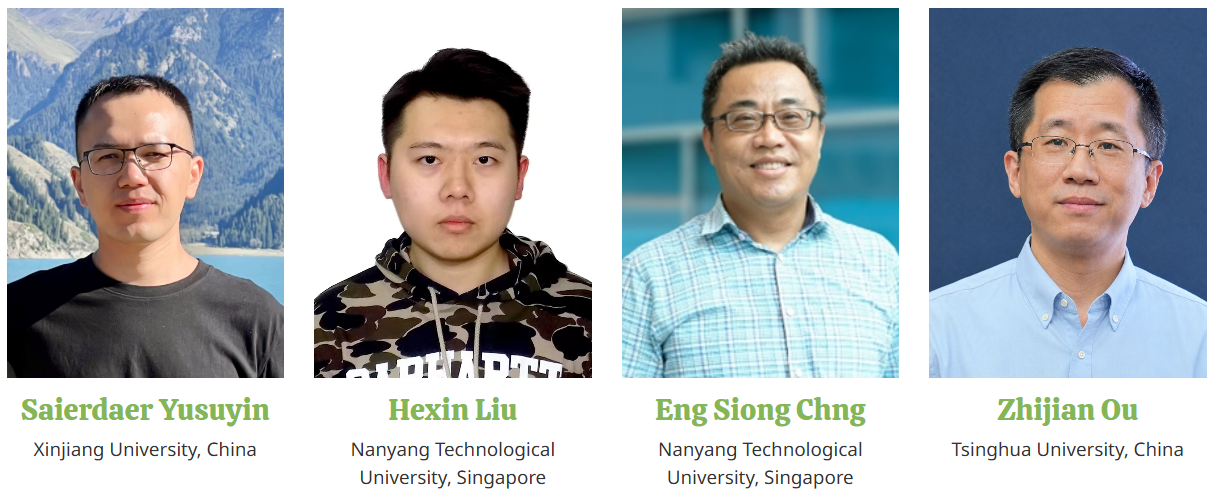
赛尔达尔·玉素音于 2019 年获得西北工业大学软件工程学士学位,现为新疆大学计算机科学与技术学院博士研究生,并在清华大学语音与智能实验室(THU-SPMI)开展研究。他的研究兴趣包括多语种、多语言语音识别和半监督学习理论。
刘和鑫于 2016 年获得哈尔滨工业大学学士学位,2023 年获得新加坡南洋理工大学博士学位,目前为 NTU 计算与数据科学学院博士后研究员。他的研究兴趣包括机器学习、深度学习和多语种、多语言口语语言处理,并担任 APSIPA 语音与语言处理技术委员会成员。
庄永祥(Eng Siong Chng)是新加坡南洋理工大学计算与数据科学学院计算机科学教授,并自 2025 年 1 月起担任助理院长(创新与产业)。他领导 Speech and Language Laboratory,研究方向覆盖语音与语言处理、大语言模型、语音增强、分类和机器学习,并长期服务国际语音技术社区。
欧智坚于 2003 年获得清华大学博士学位,现为清华大学电子工程系教授、它思科技联合创始人。他长期从事语音与语言处理研究,尤其关注端到端语音识别和对话系统中的数据高效方法,并持续主持国家级及企业合作项目。
⏩结语:欢迎关注与转发
如果你正在关注 LLM 与语音的交叉,正在研究多语言、方言、低资源或跨语言 ASR,或者希望把大语言模型的语言能力真正接入语音系统,欢迎关注并参加本次 INTERSPEECH 2026 教程报告。
2026 年 9 月 27 日上午,悉尼国际会议中心,期待共同讨论:下一代 ASR,如何在更少数据、更复杂语言、更真实场景中可靠工作?欢迎转发给从事 ASR、多语种 NLP/SLP、低资源语言技术与多模态大模型研究的同学和同行。
参会信息请关注 INTERSPEECH 2026 官方通知和本教程网站:
本教程网站:https://oa.ee.tsinghua.edu.cn/~ouzhijian/INTERSPEECH2026