
1)基本信息
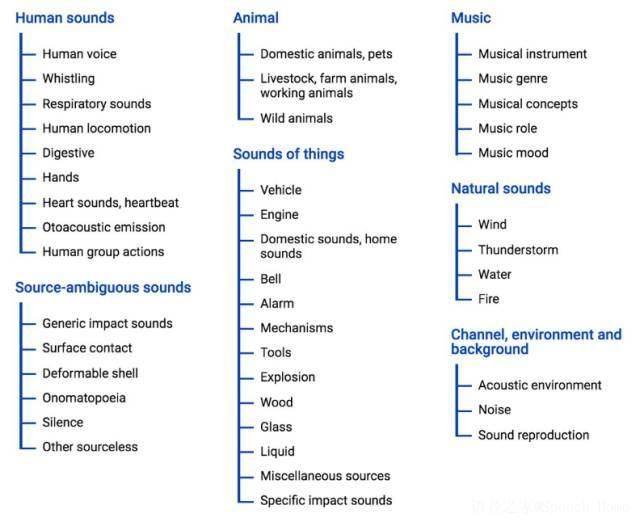
AudioSet是谷歌17年开放的大规模的音频数据集。该数据集包含了632类的音频类别以及2084320条人工标记的每段10秒长度的声音剪辑片段(包括527个标签,片段来自YouTube视频)。音频本体(ontology)被确定为事件类别的一张层级图,覆盖大范围的人类与动物声音、乐器与音乐流派声音、日常的环境声音。此项研究论文已发表于IEEE ICASSP 2017大会上。音频本体类别如下图
2)特点
AudioSet提供了两种格式:
1csv文件,包括音频所在的YouTube视频的ID,开始时间,结束时间 以及标签(可能是多标签)
2128维的特征,采样率为1Hz,也就是把音频按秒提取为128维特征。特征是使用VGGish模型来提取的,VGGish下载地址为
https://github.com/tensorflow/models/tree/master/research/audioset可以使用该模型提取我们自己的数据。VGGish也是用来提取YouTube-8M的。这些数据被存储为.tfrecord格式。
128维特征的下载地址(基于所在地)
storage.googleapis.com/us_audioset/youtube_corpus/v1/features/features.tar.gz
storage.googleapis.com/eu_audioset/youtube_corpus/v1/features/features.tar.gz
storage.googleapis.com/asia_audioset/youtube_corpus/v1/features/features.tar.gz