
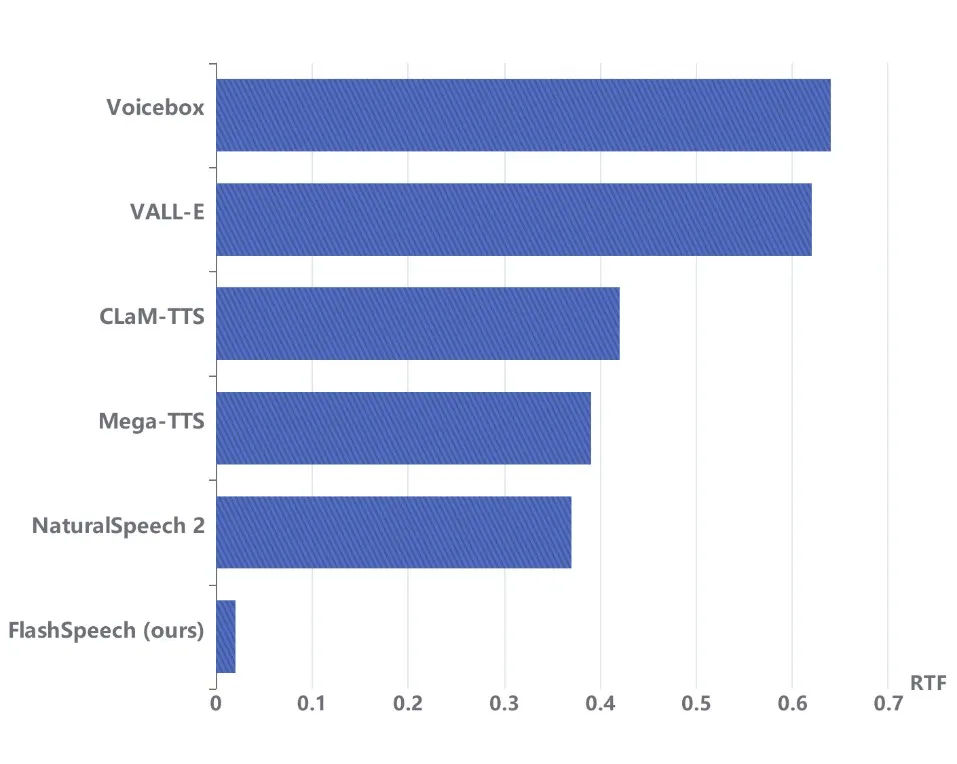
2024年,语音合成领域再次迎来了一次重大创新。由香港科技大学和微软联合开发的 FlashSpeech 模型,在零样本语音合成领域取得了显著进展。这款基于潜在一致性模型Latent Consistency Model的系统,不仅在语音合成速度上实现了20倍速度的飞跃,音质和相似度上却可以在与现有SOTA持平。
论文链接:
Demo链接:
论文题目:FlashSpeech: Efficient Zero-Shot Speech Synthesis
通常zero-shot TTS通过diffusion模型或者语言模型构建,这两类方法需要从左到右自回归预测或者大量的去噪步数,因而导致生成过程缓慢且计算开销大。FlashSpeech 的出现,极大地解决了这些问题。它不仅能够在极低的计算预算下完成高质量的语音生成,还能够在未见过的声音样本中实现准确的音色克隆。
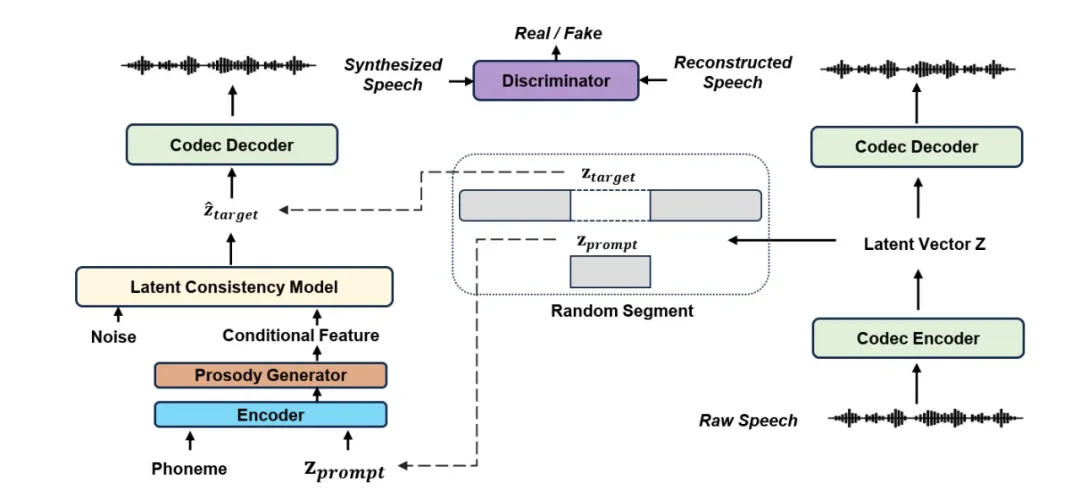
采用了创新的adversarial consistency training 方法,该方法结合了对抗训练和一致性训练的优势,无需预训练模型即可从零开始训练;
引入了全新的韵律生成模块,增强了语音的自然度和多样性;
实验结果表明,FlashSpeech的推理速度是之前模型的20倍,与之前方法相比,在音质和相似度上持平或有显著提升。
1. 潜在一致性模型(Latent Consistency Model, LCM)的实现
LCM的核心思想是在潜在空间中直接学习并生成语音数据的分布,这种方法允许模型通过极少的采样步骤(通常为一步或两步)快速生成完整的语音样本。LCM通过对潜在特征进行编码,将音频数据利用codec映射到一个潜在空间,这大大减少了计算负担。
2. 对抗一致性训练(Adversarial Consistency Training)
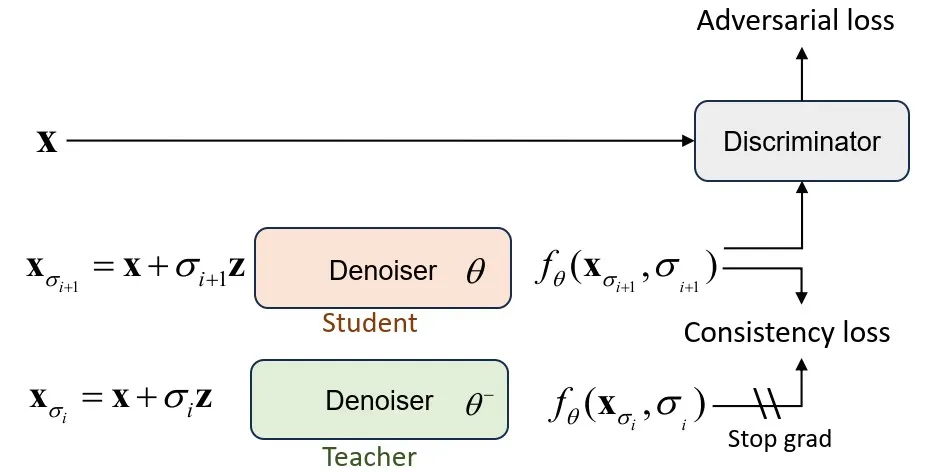
该训练策略结合了生成对抗网络(GAN)中的对抗训练和一致性模型的训练。模型在训练时不仅通过对抗训练减小生成音频和真实音频的区别,同时还依靠一致性模型维持了生成结果的多样性,从而实现了又快又好的采样。
3. 韵律生成模块(Prosody Generator Module)的创新
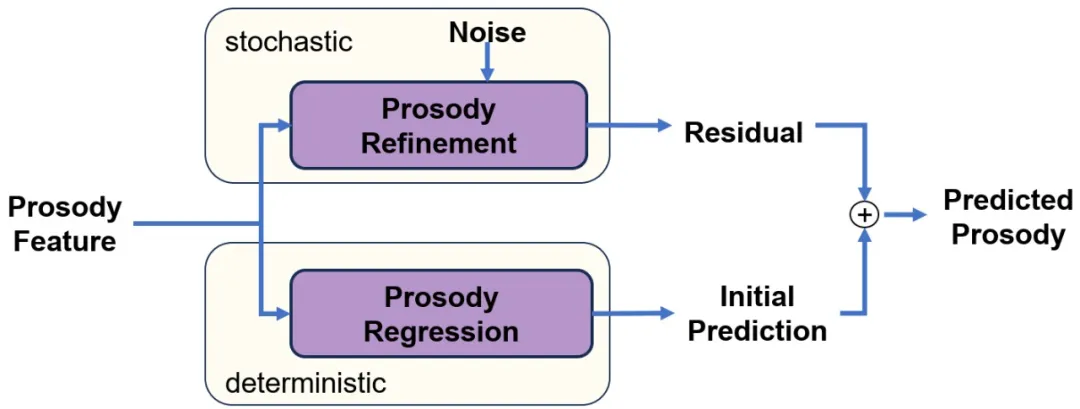
4. 高效的实时处理能力
与传统的基于迭代的合成方法相比,FlashSpeech 的一个显著优势在于其处理速度极快,可以实时生成语音,使得模型即使在较低的硬件配置上也能保持高效的运行性能。
在标准的开源语音数据集LibriSpeech testclean上的测试显示,FlashSpeech 在多个关键指标上超越了当前的先进模型。它不仅在音质和相似度测试中获得高分,而且在语音合成的速度测试中也显示出了显著的优势。这些成果验证了FlashSpeech在实际应用中的潜力,特别是在需要快速响应的场景中,如实时通信和交互式媒体。
FlashSpeech 的成功开发,不仅推动了语音合成技术的发展,也为未来的实时应用如虚拟助手、在线教育等领域提供了新的可能。未来,团队将进一步优化模型的效率和泛化能力,扩大其应用场景。