
 语音小管家
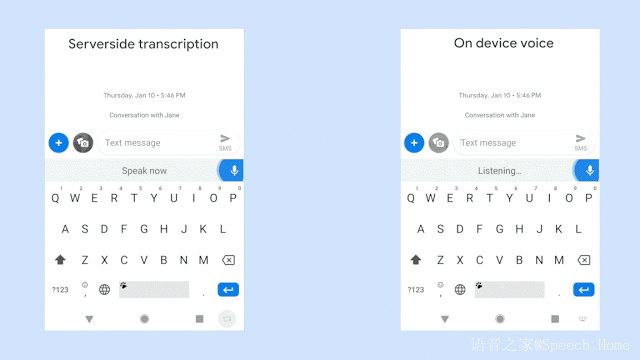
但是由于技术限制,在过去你使用语音听写的时候必须联网,这是因为你所有的语音识别能力都是通过云端来实现的,手机把你说的话上传到服务器,然后利用训练好的模型进行语音识别,在传回到手机端。
不过Google也没闲着,近日他们发布了一个基于 RNN-T(递归神经网络变换器)的模型,这个模型最大的亮点就是他的体积非常小,这也意味这它可以内置在内存有限的手机中,并且以本地保存的形式而存在。
而3月13日Google 宣布将在Gboard 手机输入法植入其功能,这就代表着,只要你能够使用Gboard输入法那么就能体验到离线状态的语音听写黑科技。
不过目前此技术显然还尚未完善,Google 表示目前此技术只支持自家Pixel 系列手机,语种选择也极其有限只有美国英语。
Google AI 语音识别团队的 Johan Schalkwyk 在博客中写道:自从2012年通过深度学习技术助力其语音识别研究并取得了非常大的进展之后,连锁反应下越来越多的产品开始采用这项技术,比如谷歌的语音搜索。
随着各类产品使用频率的增加,也促使其深度学习模型的发展,之后每年都会有新的深度学习模型开发出来,如深度神经网络 DNN、递归神经网络 RNN、长短时记忆网络 LSTM、卷积神经网络 CNN 等。
然而,延迟问题一直是模型的阿喀琉斯之踵,因为这些模型本身较大,需要联网使用,所以在语音识别的典型使用场景下,仍有瑕疵。
其实不难看到在去年12月,Google就在相关论文《串流移动设备端到端语音识别》提出并展示过一个使用 RNN transducer (RNN-T)技术训练的模型,该模型大小不到100M完全可以存放在手机本地的输入法中。
1)因为可以在本地离线使用,这个新模型解决了过去的技术(大模型)需要联网的延迟问题。
2)”串流“(streaming)两个字的意思是随说随听随写,也就是支持逐字识别,所以给用户的延迟感觉更低,就像一个实时的听写装置。
01语音识别背景
一直以来,语音识别系统包含多个组件:将音频片段(通常为 10毫秒帧)映射到音素上的声学模型、将各音素结合在一起形成单词的发音模型,以及表达给定短语似然的语言模型。在早期语音识别系统中,这些组件保持独立优化。
2014年左右,研究人员开始着重训练单一神经网络,直接将输入的音频波形映射到输出语句上。这种序列到序列的方法基于给定音频特征序列生成单词或字素序列,从而学习模型,这促进了「基于注意力」和「倾听-注意-拼写」(listen-attend-spell)模型的发展。虽然这些模型能够极大地保证准确性,但它们通常需要检查整个输入序列,并且在输入的同时无法实现输出,而这又是实时语音转录的必要特征。
与此同时,一种名为 connectionist temporalclassification (CTC)的自主技术已经帮助生产级识别器将自身延迟减半。事实证明,这对创建 RNN-T架构(最新发布版本采用的架构)来说是很重要的一步,RNN-T 可以看作是 CTC 技术的泛化。
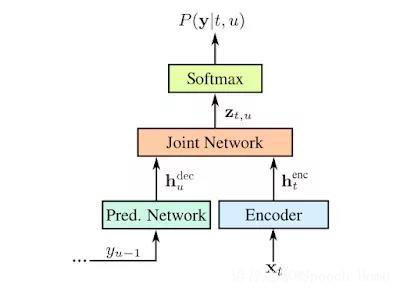
简单来说,RNN-Ts是一种不采用注意力机制的 seq2seq 模型。如前述,传统的 seq2seq 类模型需要对整个句子的波形进行处理,才能产生结果,也就是句子。而 RNN-T 可以连续处理输入样本并输出符号,也就是逐字输出字符,并在正确的地方加入空白,从而让字符转化成单词,非常适合语音识别。
当然,训练这样一个模型,并且降低错误率到用户可以接受的范围,对计算量要求是可观的。不过这难不倒坐拥第二代 Cloud TPU 服务器的 Google。采用 TPU 集群训练的速度提升到了三倍。
03如何实现移动端离线翻译
在传统的语音识别引擎中,上述的声学、发音和语言模型被「组合」成一个大型的搜索图。该搜索图的边是用语音单元及其概率来标记的。当语音波形被输入给识别器时,「解码器」会在该图中搜索给定输入信号的最大似然路径,并读取该路径采用的单词序列。通常,解码器假设底层模型的有限状态转换器(FST)表示。然而,虽然有复杂的解码技术,搜索图仍然很大,对谷歌的生产模型来说差不多是2GB。因此该技术无法轻易地在移动手机上部署,而是需要在线连接才能正常工作。
为了提高语音识别的有用性,谷歌通过直接在设备上部署新模型,来避免通信网络的延迟和固有的不可靠性。所以,其端到端方法不需要在大型解码器图上进行搜索。相反,解码包括通过单个神经网络进行集束搜索(beamsearch)。谷歌训练的 RNN-T 模型的准确率能够媲美基于服务器的传统模型,但大小只有450MB,本质上更智能地使用参数和更密集地打包信息。但即使是对现在的智能手机来说,450MB 也是不小的容量了,而在如此大的网络上传播信号会有些慢。
谷歌使用其在 2016 年开发的参数量化和混合核技术来进一步缩小模型体积,然后使用 TensorFlow Lite库中的模型优化工具包使其公开可用。模型量化对训练好的浮点模型提供了 4 倍的压缩,实现了 4 倍的运行时加速,因此 RNN-T在单核上的运行速度比实时语音要快。经过压缩后,最终模型只有 80MB 大小。
谷歌发布的这一新型全神经移动端 Gboard 语音识别器将首先用于所有使用美式英语的 Pixel 手机。
目前来看虽然 Google支持的语言不足。仅有美国英语一种但是我们相信随着项目的不断深入,和其他业界参与者的共同努力,这项技术也会在不久的将来支持更多的语种。当然我们也期待着它能在语种数量增加的同时能够适应更多不同的使用场景。
