语音小管家
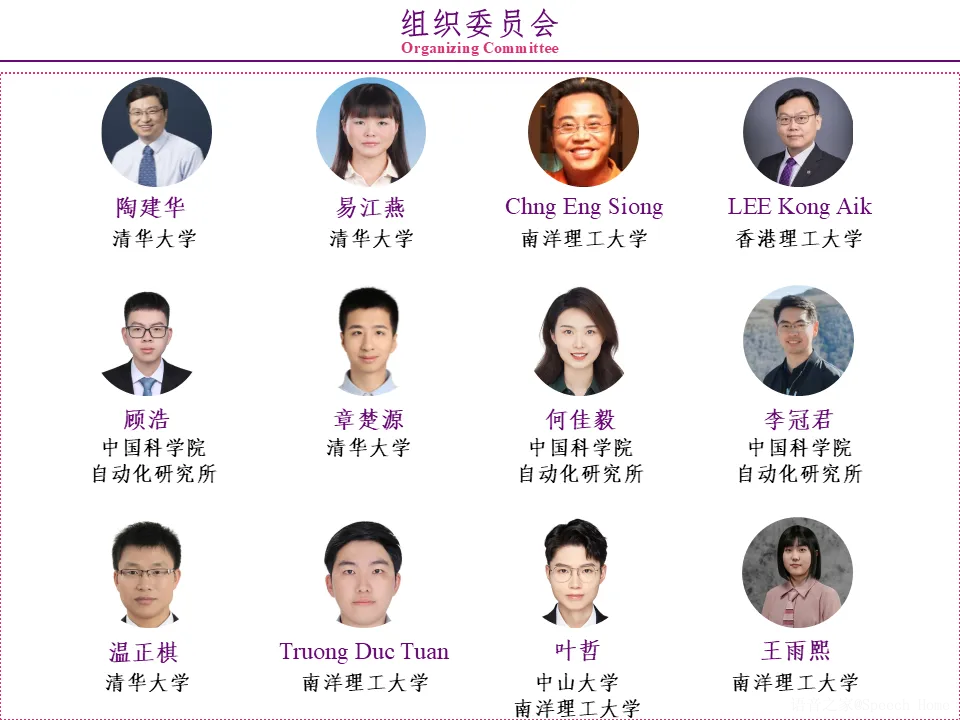
虚假音频检测技术日益受到关注,但现有技术仍存在两方面的局限:一是人工模仿音频检测。真人模仿者可复现目标说话人的韵律、音色和风格,与AI合成音频不同,人工模仿音频无明显生成痕迹,对现有检测方法构成严峻挑战。二是可解释性检测。为增强检测可信度,需明确判别依据与理由,而当前相关研究尚不够深入。为此,继 ADD 2022 与 ADD 2023 两届语音深度合成鉴别国际挑战赛之后,清华大学陶建华教授和易江燕副研究员联合南洋理工大学 Chng Eng Siong 教授、香港理工大学 LEE Kong Aik教授在语音领域国际顶级会议ICASSP 2027上举办第三届语音深度合成鉴别国际挑战赛(ADD 2026),诚邀全球研究者共同参与,攻克上述技术难题,推动该领域持续发展。
在各赛道中成绩排名前列和做出具有创新性工作的参赛队伍将有机会在ICASSP 2027会议上展示参赛技术的论文,共5篇论文收录于会议论文集。此外,在 ICASSP 2027 现场展示成果的参赛队伍,还有机会获邀向 IEEE Open Journal of Signal Processing(OJ-SP)投稿相关完整论文。
ADD 2026设置2个赛道:
🏁赛道1--人工模仿音频鉴别(Audio impersonation detection, AID)
评估对人工模仿音频与真实音频的区分能力。
🏁赛道2--可解释虚假音频鉴别(Explainable audio deepfake detection, EAD)
评估鉴别虚假音频并给出判别依据的能力。
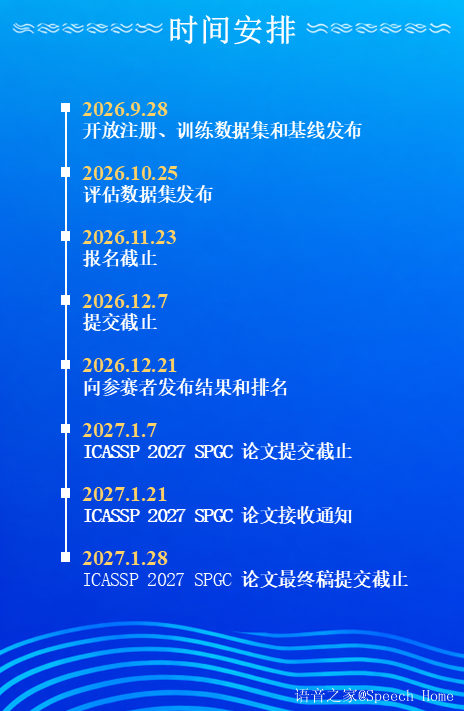
本次竞赛的注册报名时间为 2026 年 9 月 28 日至 11 月 23 日,诚邀海内外研究者踊跃参与,共同推动该领域发展。注册与报名方式如下。
竞赛网址:http://addchallenge.cn/add2026
联系方式:addchallenge@126.com