
 语音小管家
关键词:音乐、音频提取、构建模型、情感传感器
人跟人面对面的交流很可能都没有办法愉快地理解彼此,如果把对话放到电话里可能就会更加困难,那如果把这段对话转换成文字那真是难上加难。有时候由于立场不同,还能产生歧义。口是心非和言语匮乏往往会让人彼此之间难以相互理解,并且产生误会。
怎样能避免沟通产生的误会?避免社交尴尬?即使不善表达也会被理解呢?也许你需要一个声乐情感传感器。
这可能超出了我的能力范围
如今的语音识别软件发展十分迅速,语音被很多人认为是人机交互的下一个入口。不过到目前为止,也依然有很多小伙伴认为一些语音智能不够聪明机灵,不够精准智能。就语音识别来说,通过识别语音来把文字拼接在一起以重现口语单词和句子这种技术现在已经十分成熟了。但是,这种识别并不能完全理解说话人的信息。除了面部表情和肢体语言之外,与音频相比,文本捕捉情感意图的能力非常有限。比如好多人试图跟Siri对话,最后被Siri逼疯的情况。
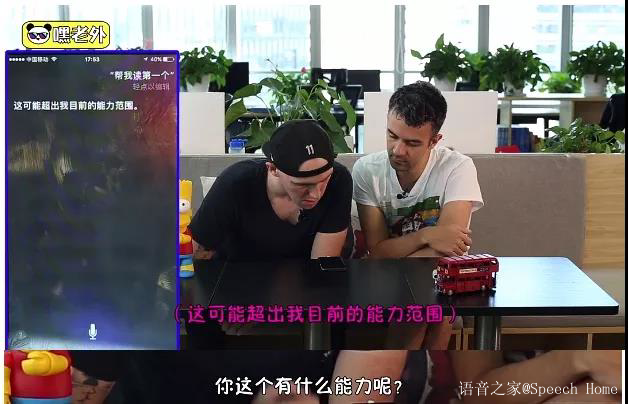
要求Siri读备忘录失败▲
当然,这只是一个例子。事实上想要做到语音情感识别并非易事。但是最近在GitHub上的一篇分享构建了一个声音情感传感器,它不但可以通过人的声音识别人的喜怒哀乐等情感,还可以根据情感为您放应景的音乐。
声乐情感传感器在,便是晴天
那么构建情感分类器的数据集分别是RAVDESS,TESS和SAVEE(悄声说,它们都是免费开放的哟)。这些数据集是由30位演员和女演员制作的4,500个标记音频文件中超过160分钟的音频,共拥有:中立、快乐、悲伤、愤怒、恐惧、厌恶和惊讶这七种情绪。
从这些音频种提取特征时则采用了梅尔频率倒谱系数(简称MFCC)。MFCC试图以更符合人类感知的方式表示音频。而关键点则在于需要决定使用多少频率区以及分段的时间步宽。这些决定决定了输出MFCC数据的粒度。语音识别应用的标准做法是在20Hz-20kHz之间应用26个频率箱,并且仅使用前13个用于分类。最有用的信息是在较低频率范围内,并且包括较高频率范围通常会导致较差的性能。对于时间步长,通常在10到100毫秒之间的值。选择使用25毫秒。通过导出的MFCC比对我们可以发现女性的声音往往具有更强的高频成分。
倒出的MFCC并不能揭示情感类别之间的任何明显差异,为了解决情绪分类问题还需要用到卷积神经网络(CNN),并对数据进行了训练。
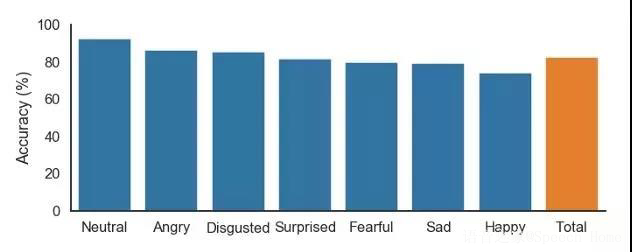
每个特定情绪的准确度▲
作者在做模型测试时应用了一个类似于用于创建训练数据的流程工作流程,并用这套工作流程应用于测试集中的所有889个文件,总体准确度得分为83%。这里必须注意的一点是要切掉所有沉默。音频预处理真的至关重要。
拥有了这个声乐情感传感器,你就拥有了全世界。
话语是误解的根源?NO!
”.....你先坐在草地上,离我稍微远些,就像这样。我从眼角里瞅着你,你什么也不要说。话语是误解的根源。但是,每天,你都可以坐得离我稍微近一些……”小王子说。
什么?当然不!人类怎么可以没有话语交流。你需要情感传感器啦。
拥有了情感传感器可以让你更能get到别人的情感,或者说你即使不善表达也不用担心你的AI不懂你。
GitHub链接:
https://github.com/alexmuhr/Voice_Emotion
