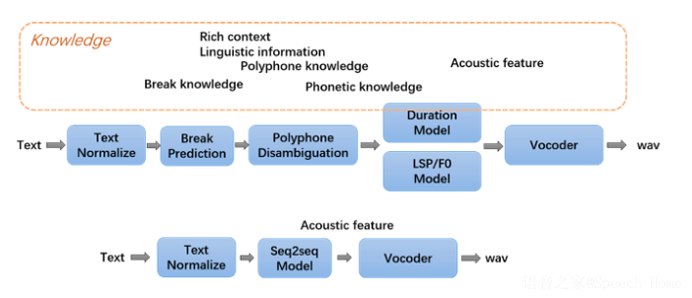
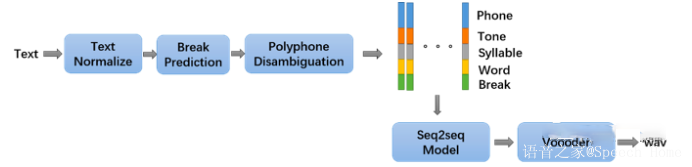
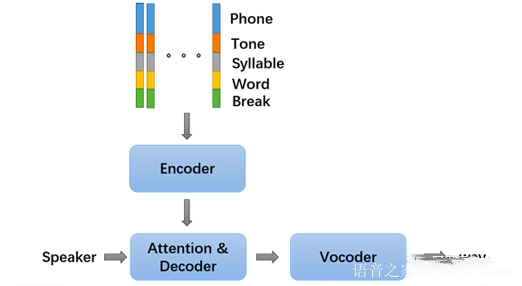
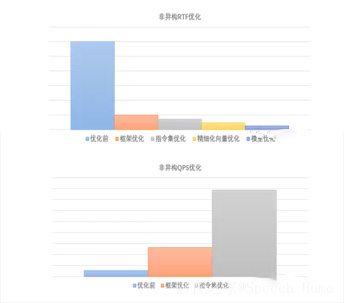
随着深度学习技术的进步,模型的建模能力越来越强大,随之而来的计算量需求也越来越高。近年来,很多公司都采用异构计算进行模型的inference,例如采用高性能或者inference专用GPU,甚至采用FPGA/ASIC这样的专用芯片技术,来加速inference部分的计算,服务实际需求。我们仔细对比了不同的inference方案,考虑到我们最终的使用场景要求,对快速扩展的要求,甚至客户不同机器的部署能力,我们最终选择以非异构计算的形式进行inference计算,即不采用任何异构计算的模块,包括GPU/FPGA/ASIC等。根据KAN-TTS的特性,以及语音合成服务的需求,我们针对性的做了若干优化,包括模型层面的算法优化以及工程层面的框架和指令集优化。最终,经过我们的一系列优化,效果如下图所示: 其中RTF是借鉴了语音识别中的指标,即Real Time Factor,度量合成1s的一句话所需要的计算时间。QPS为实际同时能够支撑的服务请求数。
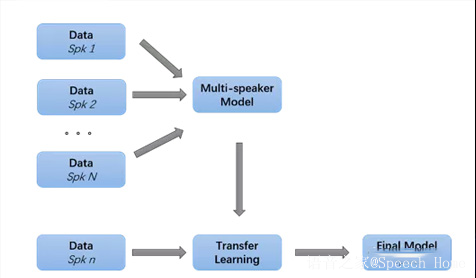
Knowledge-awareNeural TTS(KAN-TTS)技术是结合了我们最新的语音技术、海量的文本和声学数据以及大规模计算能力,对语音合成技术进行的改进。我们通过深度融合了传统语音合成技术以及End2end系统,并结合各种domain knowledge,从而提供高表现力高稳定性的在线实时语音合成服务。同时,考虑到客户的实际需求,我们采用了完全基于CPU的服务部署方式,并推出了低成本精品定制,可以基于客户的实际需求进行部署客户和声音定制。现在,用户可以在阿里云官网(https://ai.aliyun.com/nls/tts)感受到Knowledge-aware Neural TTS(KAN-TTS)的合成效果。在未来的工作中,我们还将基于KAN-TTS技术对语音合成技术做进一步的改进,提供给大家更好的语音合成服务。[1] Yuxuan Wang, RJ Skerry-Ryan, et al. "Tacotron:Towards End-to-End Speech Synthesis", Interspeech 2017.[2] Jonathan Shen, Ruoming Pang, et al. "NaturalTTS Synthesis by ConditioningWavenet on MEL Spectrogram Predictions",ICASSP 2018.[3] K Tokuda, T Yoshimura, T Masuko, TKobayashi, T Kitamura, "Speech parametergeneration algorithms for HMM-based speech synthesis", ICASSP 2000.[4] ZH Ling, RH Wang, "HMM-based hierarchical unit selection combining Kullback-Leiblerdivergence with likelihood criterion", ICASSP 2007.[5] Heiga Zen, Andrew Senior, Mike Schuster,"Statistical Parametric Speech Synthesis Using DeepNeural Networks",ICASSP 2013.[6] Changhao Shan, Lei Xie, Kaisheng Yao, "ABi-directional LSTM Approach for Polyphone Disambiguation in Mandarin Chinese",ISCSLP 2016.[7] Chuang Ding, Lei Xie, Jie Yan, Weini Zhang, Yang Liu, "AutomaticProsody Prediction for Chinese Speech Synthesis using BLSTM-RNN and EmbeddingFeatures", ASRU 2015.[8] Ming Lei, Yijian Wu, Frank K. Soong,Zhen-Hua Ling, Lirong Dai, "A Hierarchical F0 Modeling Method forHMM-Based Speech Synthesis", Interspeech 2010.[9] Zhen-HuaLing , Zhi-Guo Wang, Li-Rong Dai, "Statistical Modeling ofSyllable-Level F0 Features for HMM-based Unit Selection Speech Synthesis",ISCSLP 2010.[10] T. Drugman and T. Dutoit, "Thedeterministic plus stochastic model of the residual signal and its applications",IEEE Trans. Audio, Speech and Language Processing, vol. 20, no. 3, pp. 968–981,March 2012.[11] T. Raitio, A. Suni, J. Yamagishi, H.Pulakka, J. Nurminen, M. Vainio, and P. Alku, "HMM-based speech synthesisutilizing glottal inverse filtering", IEEE Trans. on Audio, Speech, andLang. Proc., vol. 19, no. 1, pp. 153–165, Jan. 2011.[12] Yu-An Chung, Yuxuan Wang, Wei-NingHsu, Yu Zhang, RJ Skerry-Ryan, "Semi-Supervised Training for ImprovingData Efficiency in End-to-End Speech Synthesis",https://arxiv.org/abs/1808.10128
 语音小管家