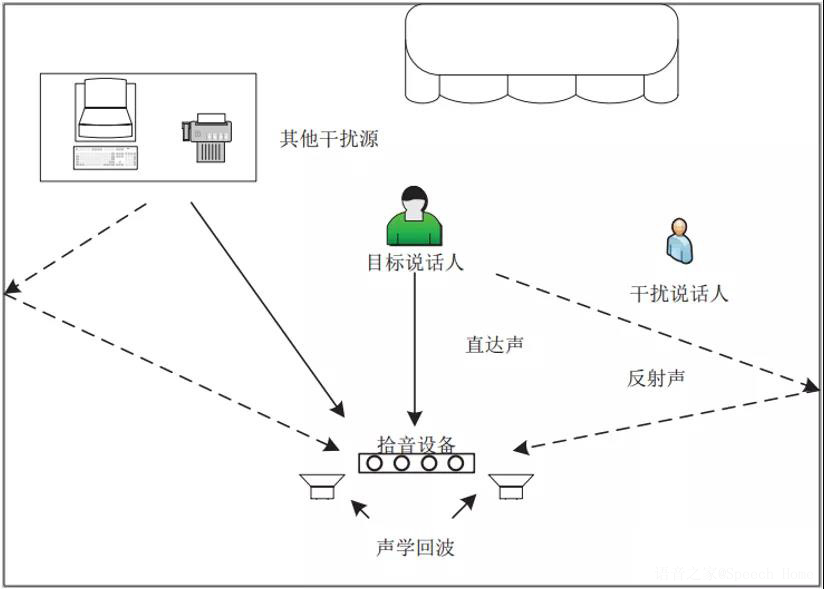
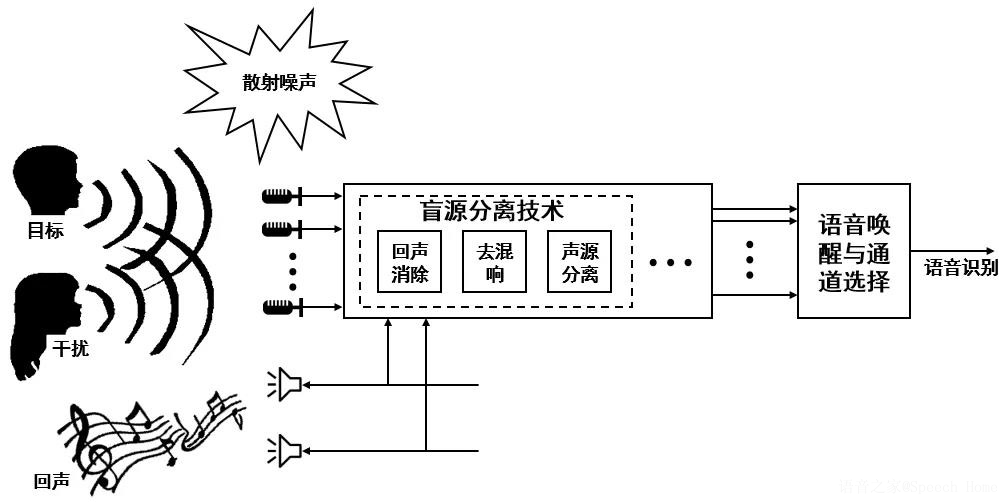
设想在一个“鸡尾酒会”上,不同客人的说话声、脚步声、音乐声等各种声音混合在一起。对于宴会中的客人来说,即使处于嘈杂的环境中,他们也能够很轻松的理解同伴说话的内容,然而对于计算机来说,例如语音识别程序,却很难在这样一个有干扰的环境下将接收到的声音信号准确的识别成文字。但是,如果能用某种算法首先将各种声源所产生的声音信号从麦克风接收到的混合信号中分离开来,再选择所需的声源进行识别,由于消除了其它声源的干扰,所以语音识别的准确率将会显著提高。以上就是著名的“鸡尾酒会问题(The Cocktail Party Problem)”。在人们的日常生活中,类似于“鸡尾酒会问题”的例子还很多,这类问题有着共同的特点,即人们实际观测得到的是多个源信号混合而成的结果,而各个源信号事先却无法得知,但是在后续的处理中往往需要用到某个或某几个源信号。
为了实现更好的人机/人人交互体验,智能设备上通常同时装有麦克风阵列和扬声器,设备既可以录音,也可以放音。所以,智能设备自己播放的声音将被其自身的麦克风采集到,即我们通常说的声学回声(Acoustic Echo),而回声消除(Acoustic Echo Cancellation, AEC)技术通常用于抑制回声,减小其对有用信号造成的影响。传统的回声消除算法,例如NLMS(Normalized Least Mean Square),其信号模型一般建立在单讲模型(即只有回声或将近端信号建模为高斯噪声的情形)之上,并结合梯度下降法在单讲段进行更新。对于双讲情况(即近端语音和回声同时出现),为了防止有用的近端语音被抑制,通常采用的方法是暂停滤波器更新或者减小迭代步长以放慢更新速度。
 语音小管家