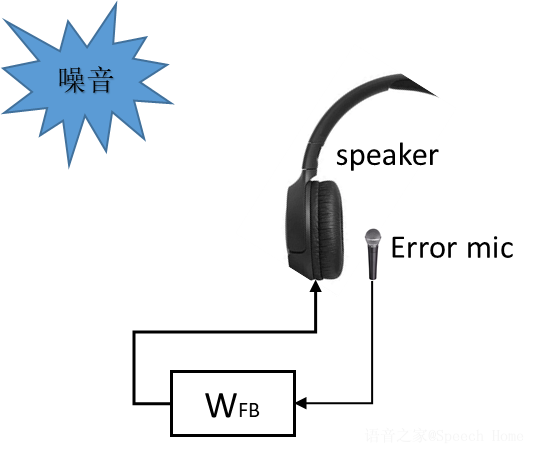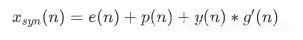
如果大家还记得FF ANC的结构图,应该知道对于非自适应FF ANC来说,只有Ref mic会被用来采集环境噪声从而进行FF ANC处理,Error mic是没有被用到的。对于自适应FF ANC来说,Error mic 会被用来检测冗余噪声从而来调节自适应FF ANC滤波器。对于FB ANC来说,无论自适应还是非自适应,始终只有 Error mic 会被用到,Ref mic是不会被用到的。
FB ANC基本原理就是通过Error mic采集的冗余噪音来进行降噪处理。对比于FF ANC,FB ANC好处就是这个用Error mic测量到的噪声和方向无关啦。整个降噪系统的输入信号就是这个Error mic测量到的噪声。然而对于FF ANC来说,整个降噪系统的输入信号是Ref mic测量到的环境噪声。
缺点显而易见,FB ANC总是慢一拍!观察整一个降噪的过程,可以理解为我在n时刻听到了一个噪声x(n),对听到的这个噪声x(n)进行处理产生一个降噪声y(n),最后用耳机播放 y(n) 。可是要注意的是,当播放这个降噪声y(n)的时候已经不是时刻n了,而是下一个时刻n+1了!在 n+1时刻,这个听到的噪声也已经不是x(n)了,所以FB ANC总是慢一拍!当然信号处理的时间也不容忽视。
对于 FF ANC 来说,如果 Ref mic收到环境噪声的时间 + 信号处理时间 < Error mic收到环境噪声的时间,那么是可以进行一个相对来说比较完美的降噪的。对于FB ANC 来说就算没有信号处理的时间,也总是晚一个节拍。
这个时候大家可能会困惑,这个FB ANC总是慢一拍,如何能进行降噪?
答案是,看运气!如果n时刻和n+1时刻的噪声差不多,那么FB ANC就可以有效的进行降噪工作。那什么样的情况下n时刻和n+1时刻的噪声会差不多呢?
这取决于两点,第一点是噪声本身的频率大小。频率越低,波形随着时间变化缓慢。反之,对于高频信号来说,波形随着时间的变化要快于低频。
第二点是整个信号处理的延迟:对于FB ANC来说这个信号处理的延迟比FF ANC要重要很多。极端例子,假设Error mic在n时测量到了冗余噪声,在 1000 Years later 后才能将生成的降噪声音从耳机播放出去,那么结果显而易见。。。


你都没有了,还哪有声?

总结前面两点,就是说在n时刻生成的降噪声要和在n+1时刻的噪声相差180°左右。这就对硬件的性能提出一定要求,DSP的处理速度够快、ADC和DAC的延迟够低等等。当然这两点不只是对FB ANC来说的,对于FF ANC也是类似,只是对于 FB ANC更加重要,所以把这两点放在了这里来说。
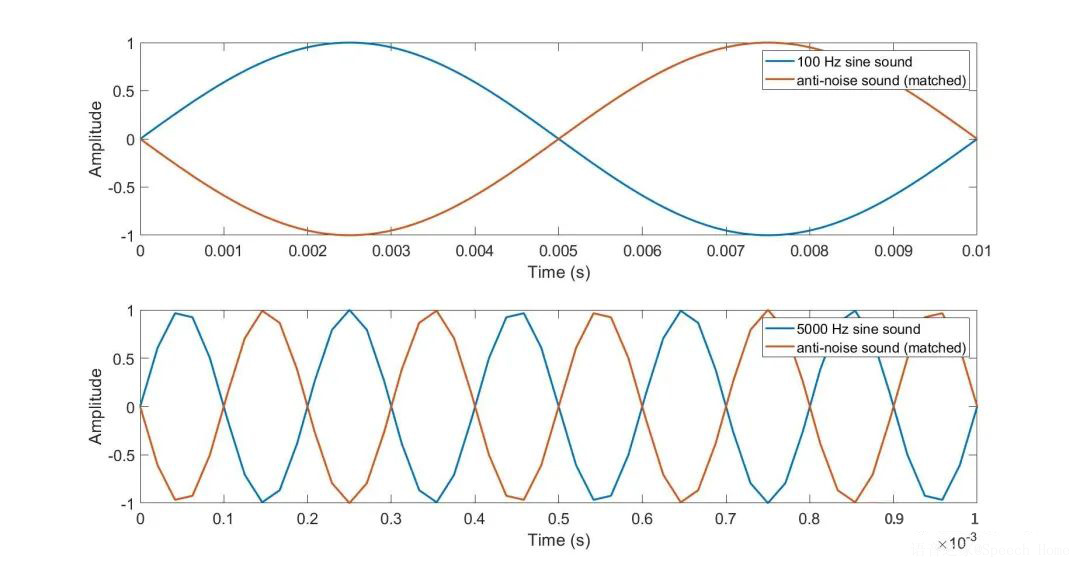
如图一所示,我这里用Matlab简单画了两个图来解释高低频声音对于延迟的敏感度。每幅图里由两条曲线,蓝色的是噪声(noise),红色线是降噪声(anti-noise)。从上到下的顺序,第一张图是一个100Hz的噪声和一个没有延迟的降噪声。第二张图显示的是一个5000Hz的噪声和一个没有延迟的降噪声。我们可以看到,如果降噪声和噪声的相位差180°,那么这个噪声可以被完美抵消。
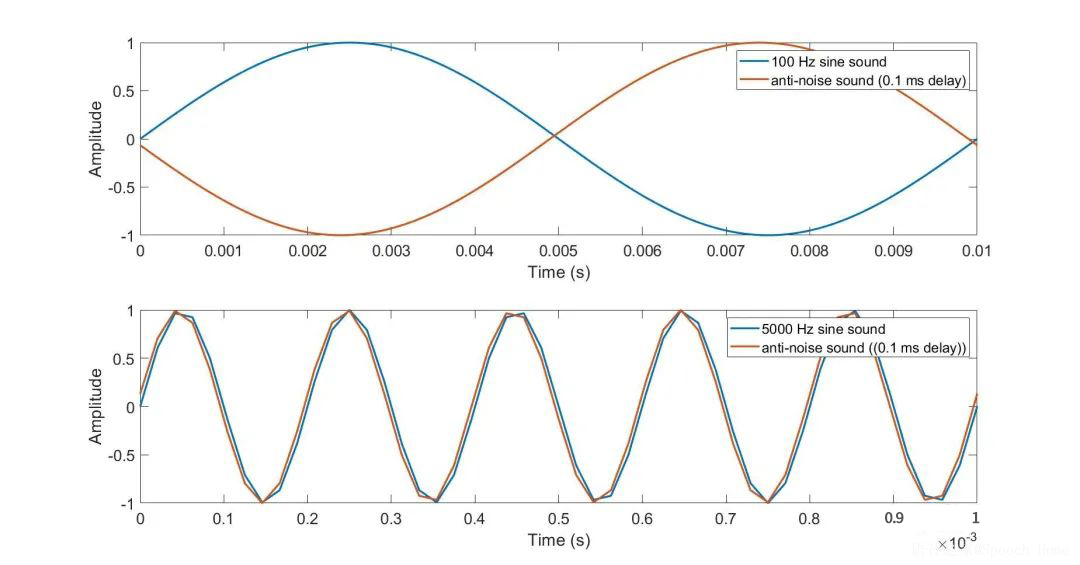
但是现实是残酷的,信号处理延迟永远是ANC的心病!如第三和第四幅图片所示,我加了一个0.1毫秒的延迟在降噪声上面,来看看降噪声和噪声的情况怎么样。显而易见,对于低频声音(100 Hz)来说,依然可以做到降噪(图三),降噪声和噪声的相位还是在180°左右。但是对于5000Hz的信号来说,降噪声和噪声相位变得很小了,你把俩声音加起来就完美变成了主动升噪!


图一:延迟对于低频高频信号的影响


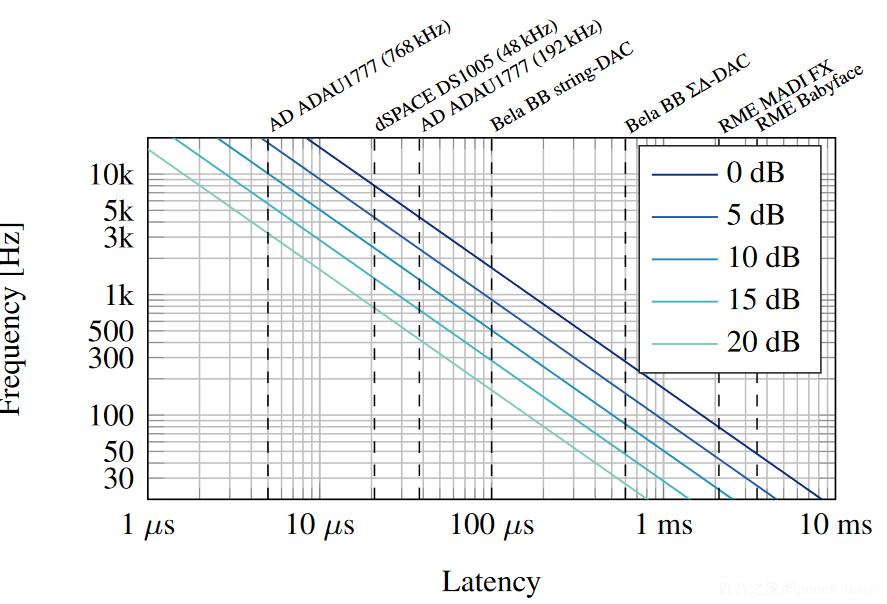
Liebich [1] 计算了信号处理器延迟和可降噪频率上限的关系。如图二所示, x 轴为输入输出延迟 (这里主要包括硬件延迟,比如 ADC, DAC等等), y轴为最高可降频率。不同颜色的斜线表示最高可降低噪声的分贝大小。

图二:可降噪频率上限和延迟以及降噪能力(0, 5, 10, 15, 20 dB)的关系 (某些ADC 和 DAC的实例) [1].
这里想到一个关于ANC的笑话:飞机轰鸣,还有小孩儿哭。我打开了降噪,然后世界里只剩下了小孩儿哭 。这是因为飞机引擎声是低频而孩子的哭叫声可是高频啊!
回归正题,现在来说说 FB ANC滤波器的计算。首先我们从非自适FB ANC开始讲起,毕竟目前市场上的降噪耳机绝大部分都是非自适应的ANC。

图三:非自适应反馈ANC的结构图


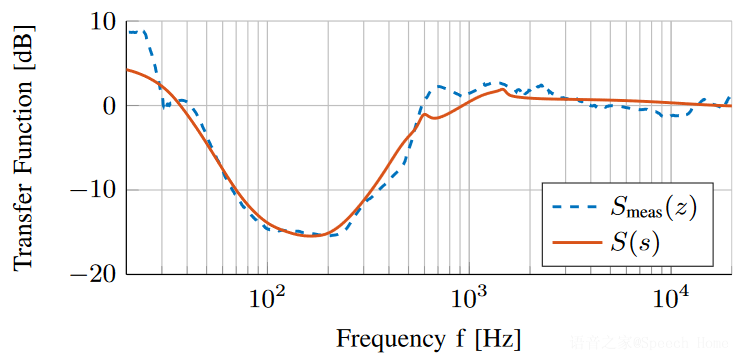
图四:典型的FB ANC降噪能力图 [2]


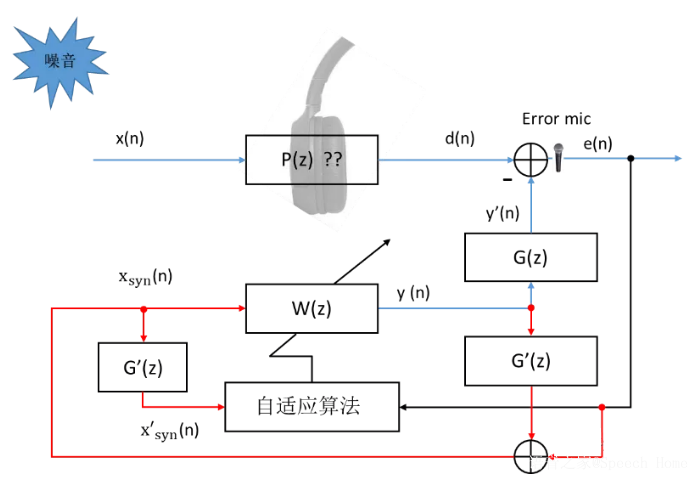
图五:基于FxLMS的自适应FB ANC系统


Error mic测到的冗余信号 e(n)可以表示为 噪声信号(d(n))和测量到的降噪信号(y’(n))的差值。测量到的降噪信号可以表示成FB滤波器W(z)的输出信号(y(n)) 经过G(z)的滤波。因为W(z)的输出信号是已知的,并且我们可以用G(z)的平均值(G’(z))来估计当时的G(z),那么我们可以估计出噪声信号的大小(时域表达式)。

有了这个合成的输入信号,后面的步骤就和FF ANC一模一样了。
这是一个自适应ANC的过程。这个过程可以实时(online),也可以线下(offline)。线下的过程就是假设图四中的噪声d(n)为白噪声,然后进行ANC来得到optimal的W(z)。如FF ANC一样,还可以在这个FB ANC过程里加入心理声学的模块,等等。
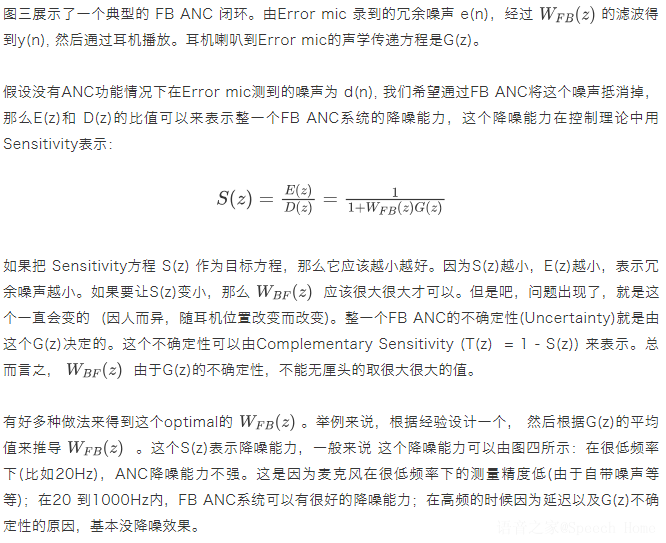
罗里吧嗦一大堆,还想重复一点,FB ANC是一个闭环。这个闭环的鲁棒性,稳定性由多变的G(z)来决定。如果没有考虑多变的G(z)(这里是指计算过程只考虑了G(z)的均值,等等),这个负反馈闭环很容易变成正反馈闭环。效果嘛,想象一下KTV里唱歌,把麦克风靠近音箱的那个啸叫声就是了。
上面是我对FB ANC的一点浅见,如果有疑问或者觉得哪里不对请指正。在接下来的文章中我会写写实时测量G(z)的方法。

作者:S.Li
在德国流浪多年的声学博士生,主要研究课题有双耳声,心理声学,主动降噪等。
参考
[1] S. Liebich, J. Fabry, P. Jax and P. Vary, Signal processing challenges for active noise cancellation headphones in ITG-Fachtagung Sprachkommunikation, VDE. VDE Verlag GmbH, Oct. 2018.
[2] S. Liebich, P. Jax and P. Vary, Active Cancellation of the Occlusion Effect in Hearing Aids by Time Invariant Robust Feedback, Speech Communication; 12. ITG Symposium, pp. 1-5, 2016.
封面来源:licensetoblog.com