
 语音小管家
歌唱合成SVS(singing voice synthesis)是根据歌词和乐谱信息合成歌唱,相比于TTS使机器“开口说话”,歌唱合成则是让机器唱歌,因此更具有欣赏性。
互联网的时代,人机交互更加频繁和智能,歌唱合成则添加了人机交互的趣味性,因此受到工业界和学术界的关注。相比TTS,歌唱合成需要更多的输入信息,比如乐谱中的音高信息,节拍信息等等。但是歌唱合成的训练语料十分昂贵,为获得较高品质的歌唱干声和乐谱信息,研究者需要付出上百万的开销,这也阻碍大量研究人员的脚步。本文针对2020年歌唱合成的发展状况,总结在是否拥有大量训练数据前提下采用的不同方案,以供同行参考。
各家demo的链接:
https://welkinyang.github.io/learn2sing/
https://bytesings.github.io/paper1.html
https://xiaoicesing.github.io/
https://speechresearch.github.io/hifisinger/
https://tencent-ailab.github.io/learning_singing_from_speech/
https://speechresearch.github.io/deepsinger/
研究情况
是否拥有充足的训练数据导致不同的研究方向和策略,因此根据训练数据是否充足进行以下分类:
数据充足
系统架构设计
1)ByteSing: A Chinese Singing Voice Synthesis System Using Duration Allocated Encoder-Decoder Acoustic Models and WaveRNN Vocoders
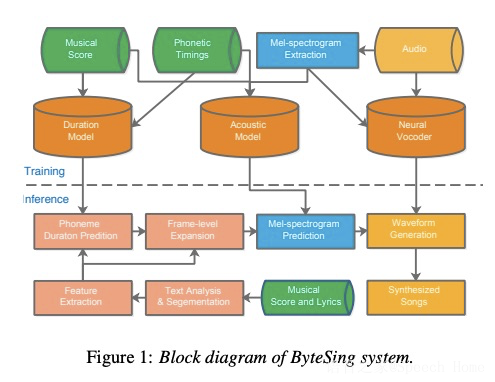
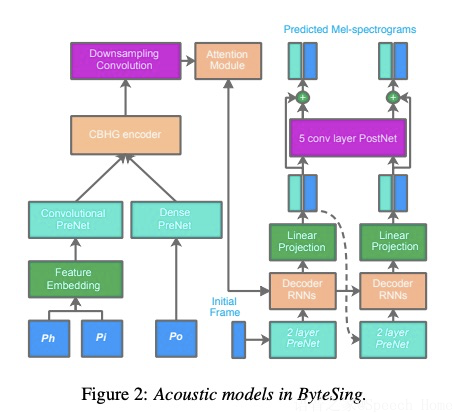
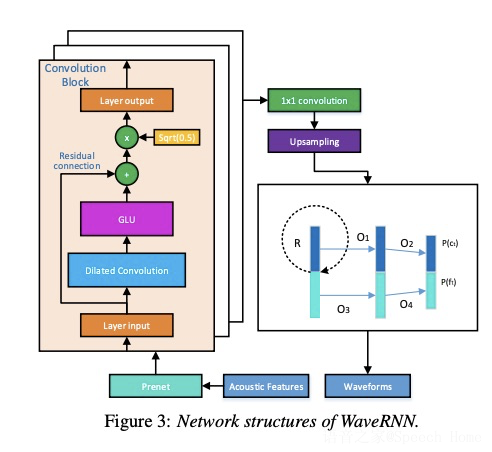
图一展示了ByteSing 系统的整体架构,该系统包含时长模型,声学模型和神经网络声码器。时长模型的输入为音素+音素类型+节奏和音符时长,输出为音素对应的时长。声学模型的输入为音素+音符音高+每帧的位置信息,输出为声学信息,具体为图2展示。看到图2结构可能大家跟我有相同的疑惑,既然时长模型已经预测出了每个音素时长,为什么还使用attention?本文在实验部分给出了实验结果:使用attention的效果更好。神经网络声码器是把声学特征转成波形,具体结构图3所示。
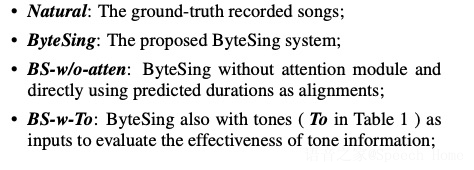
本文实验对比一下几个方面:Natural是原始录音,ByteSing为本文提出方案,BS-w/o-attention为不使用attention方案,BS-w-To为输入特征添加音调信息。
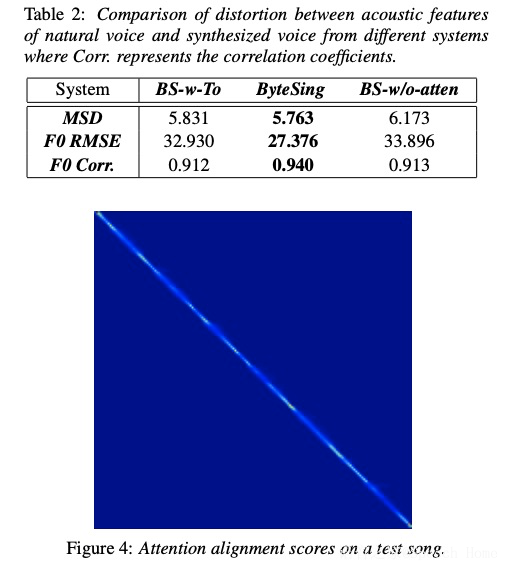
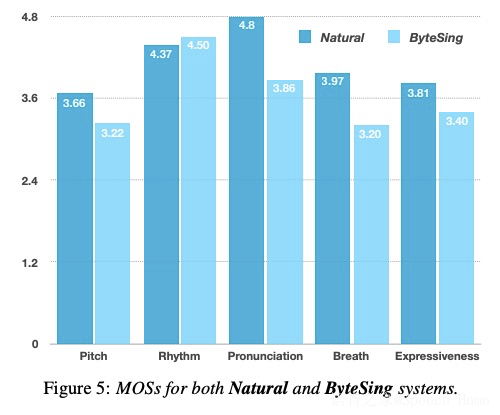
2)XiaoiceSing: A High-Quality and Integrated Singing Voice Synthesis System
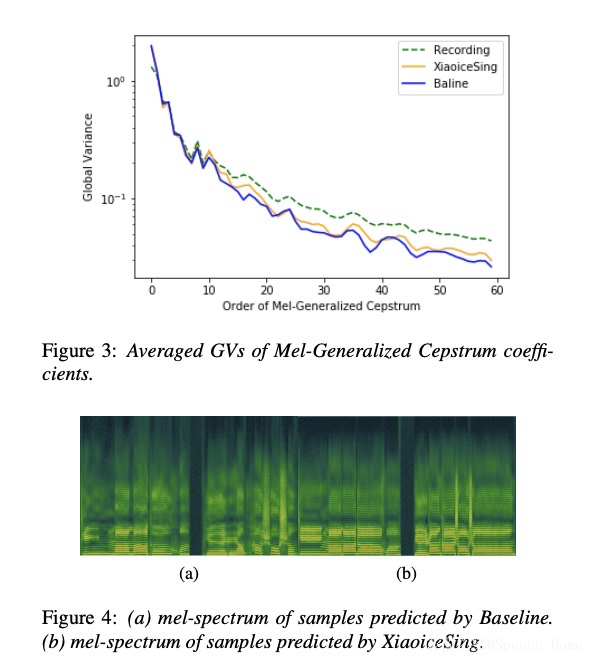
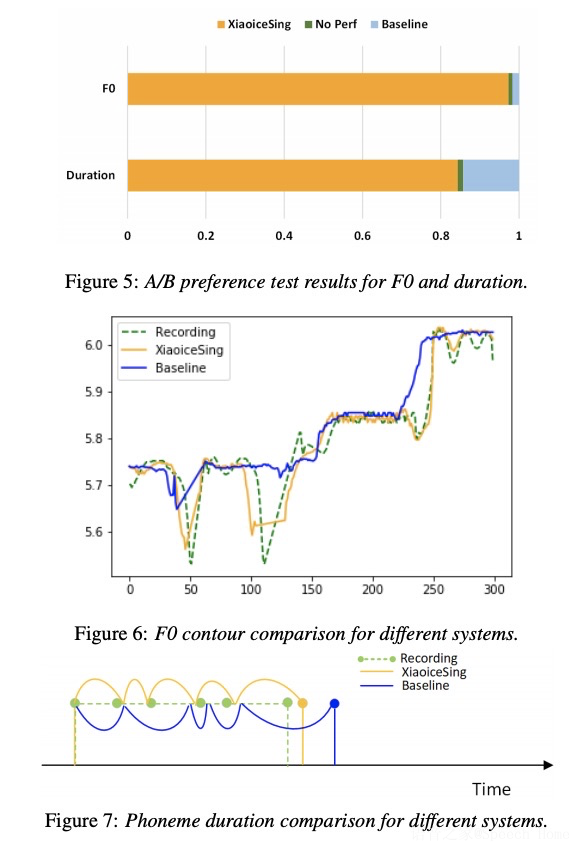
本文使用的系统架构是FastSpeech,声码器为world vocoder,具体系统架构为图1所示。该系统主要注意以下几点。第一,输入的内容是从乐谱中提取的phoneme, pitch和duration,具体的格式为图二。第二,encoder和decoder之间的durtion训练时候不仅考虑phoneme的loss,也考虑syllable的loss,因此此处的loss为公式1。第三,decoder输出的特征mgc+bap+v/uv+pitch,其中pitch使用残差的方式进行拼接,其loss为公式2和3。
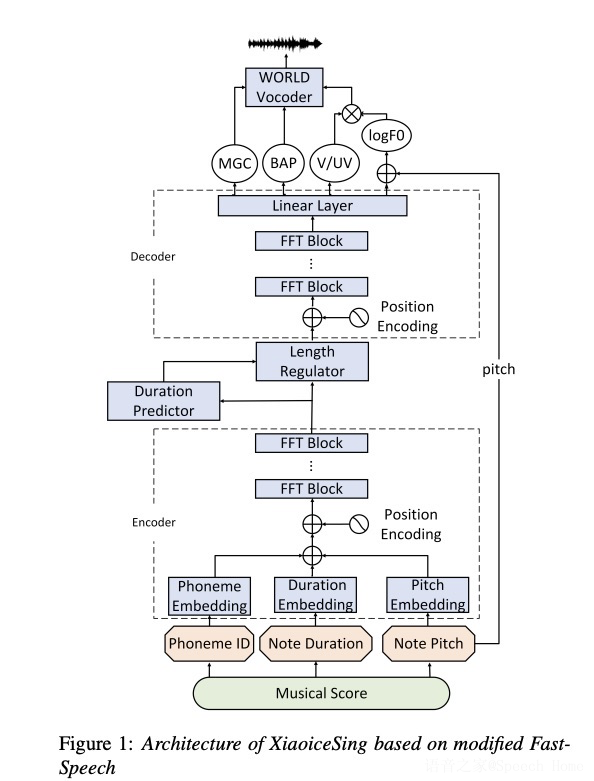
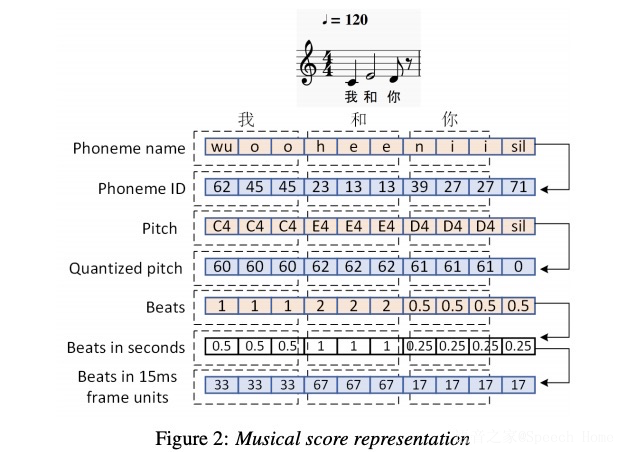
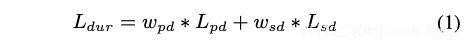
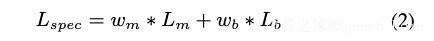
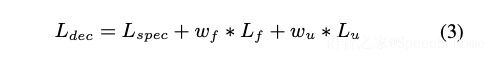
高采样率数据
1)HiFiSinger: Towards High-Fidelity Neural Singing Voice Synthesis
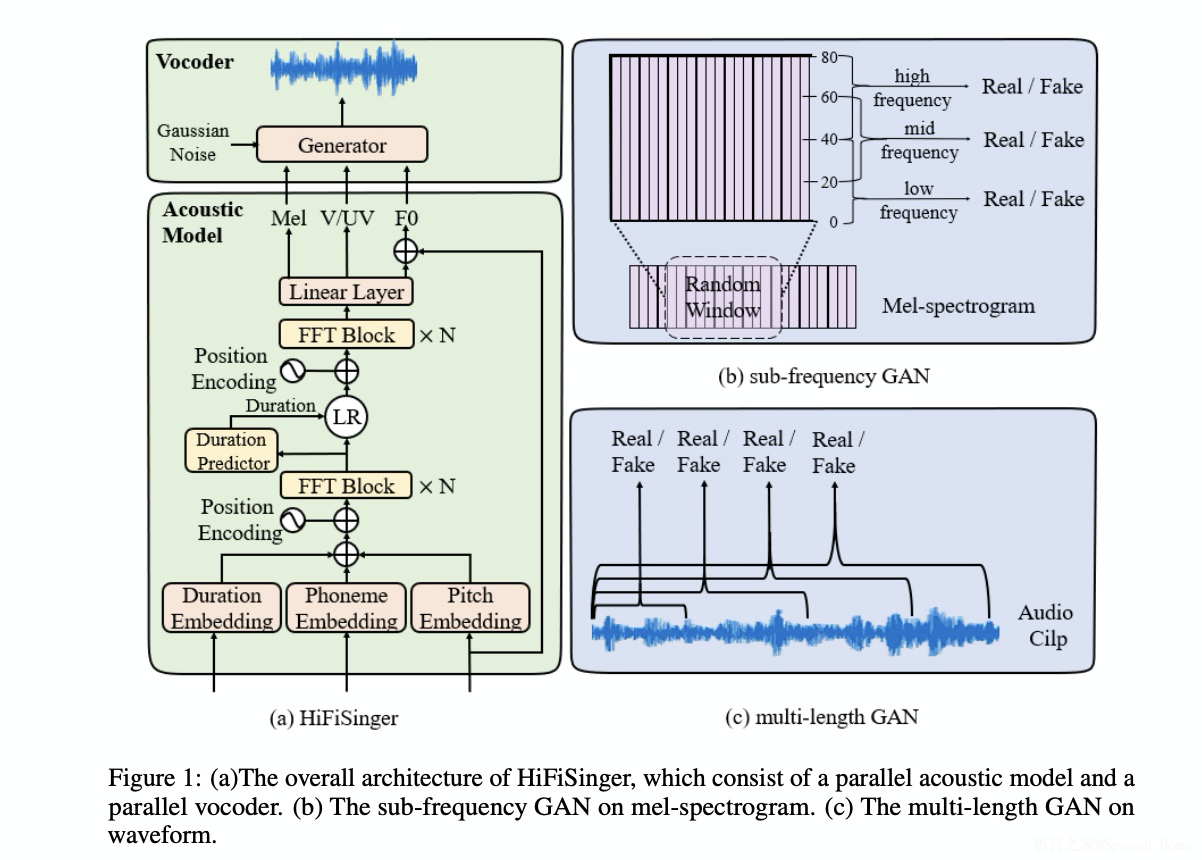
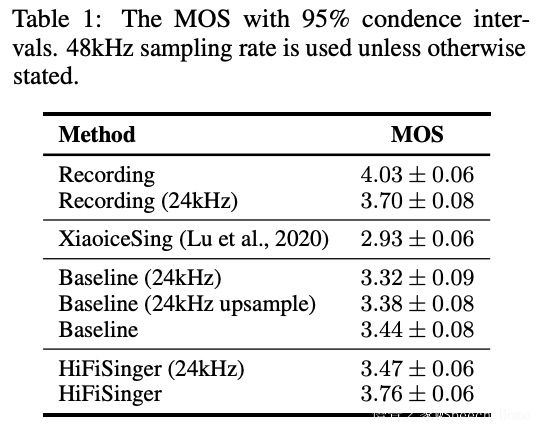
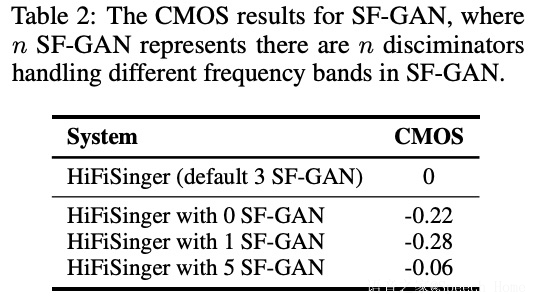
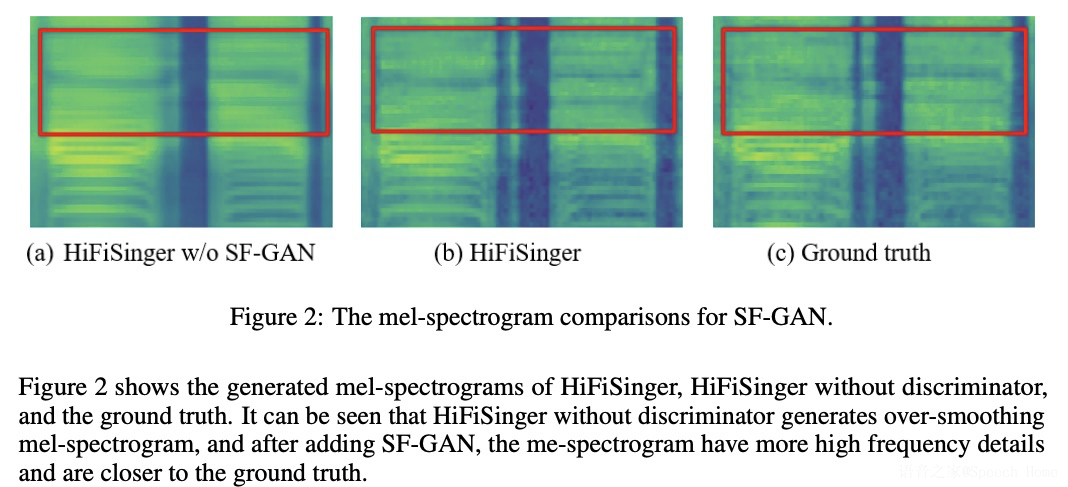
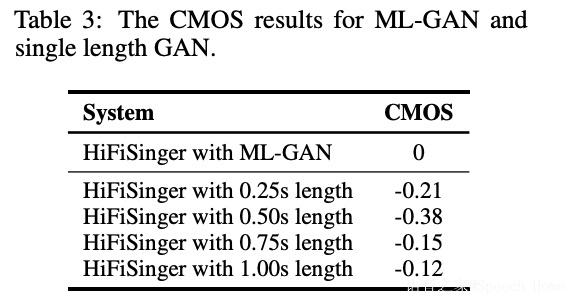
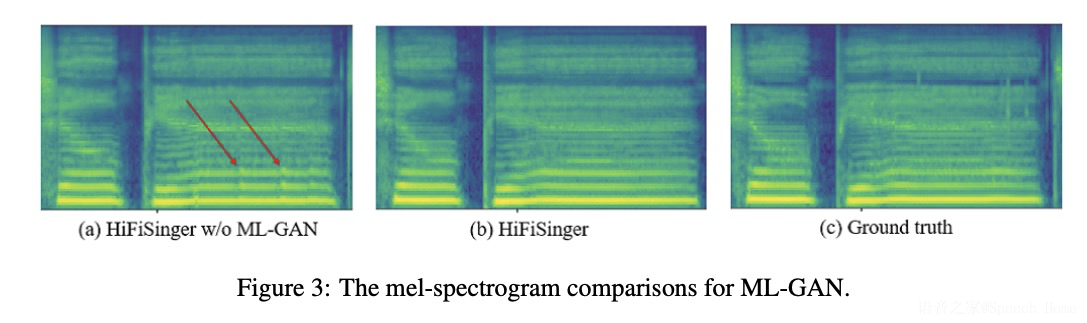
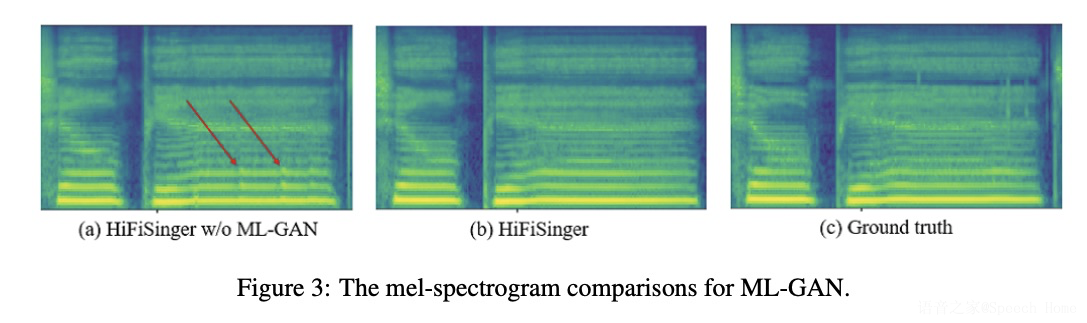
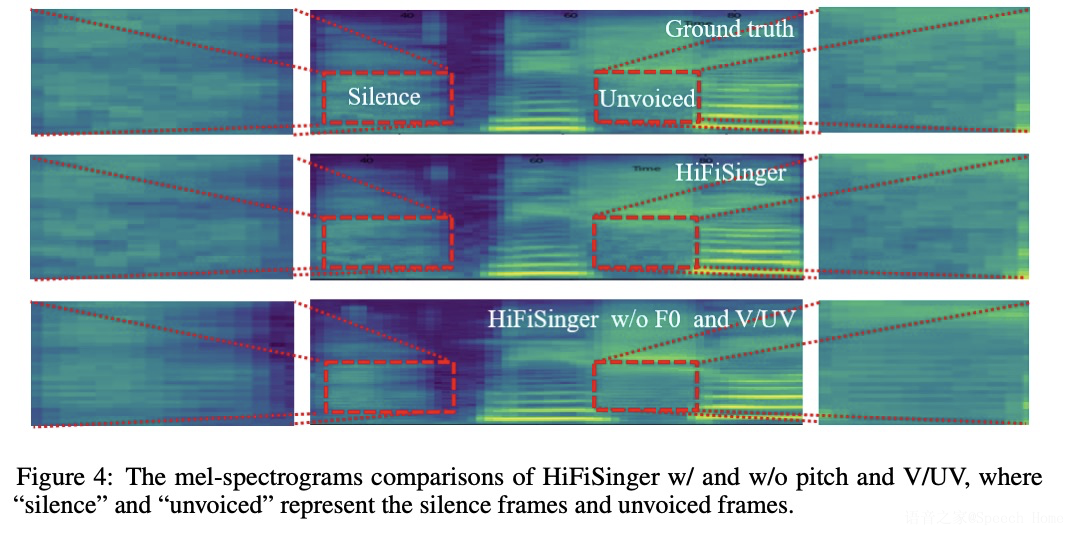
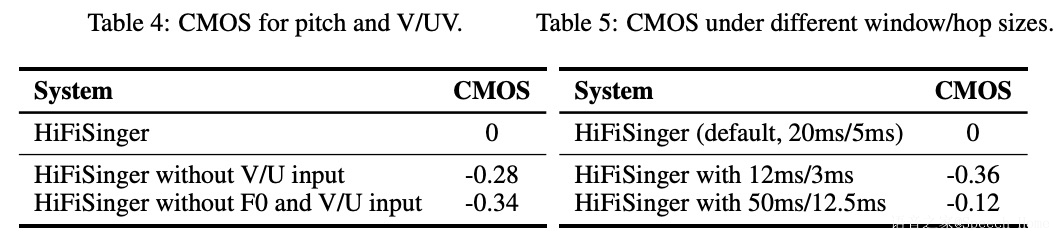
高仿真的音频合成需要处理高采样率的音频数据,尤其是歌唱合成。相对于使用16kHz和24kHz的音频,使用48kHz的音频将会覆盖更宽的频带和更长的音频序列,这将给音频合成造成极大的挑战。本文针对使用48kHz音频带来的问题,提出了HiFiSinger。该系统由FastSpeech和Parallel wavegan组成,具体的如图1所示。音乐合成的输入是从歌词和乐谱提取的特征(如图一(a)的phoneme从歌词中转换,duration embedding 和pitch embedding从乐谱中提取),整个流程跟fastspeech差不多。不过因为使用48kHz的音频,因此80维的mel特征刻画的频带更广,因此本文提出了SF-GAN进行子带划分和辨别,具体如图一的(b)所示,把80维分为低中高三个频带(0~40,20~60,40~80),其目标函数为公式1和2。另外,为解决生成的音频序列增长的问题,本文对声码器添加ML-GAN,具体如图1的(c)所示,使用不同长度的音频进行辨别,其目标函数为公式3和4。另外本文也测试了使用特征pitch和v/uv,window/hop size 和larger receptive field对结果的影响。
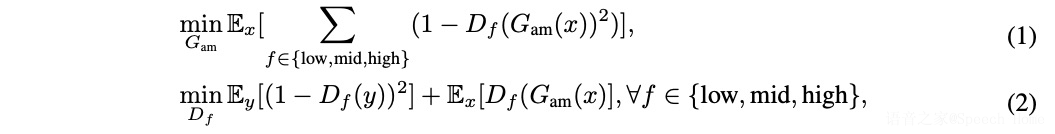
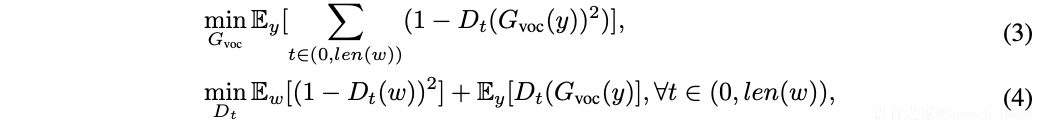
数据匮乏
低质数据
1)Deepsinger: Singing voice synthesis with data mined from the web
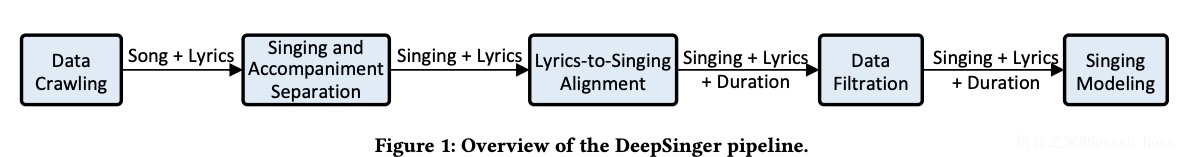
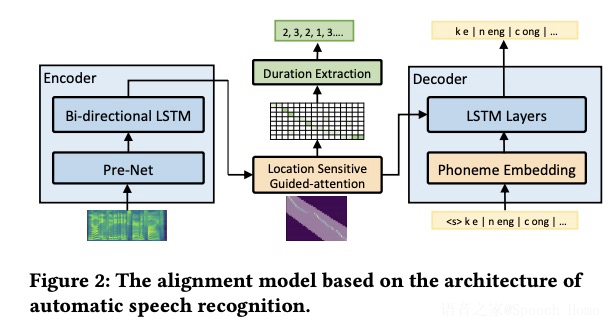
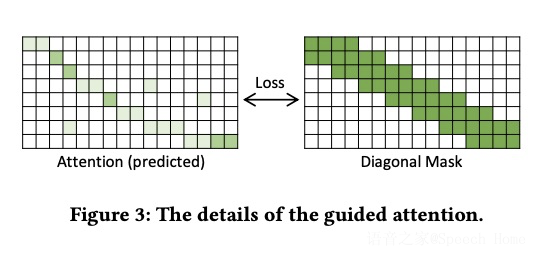
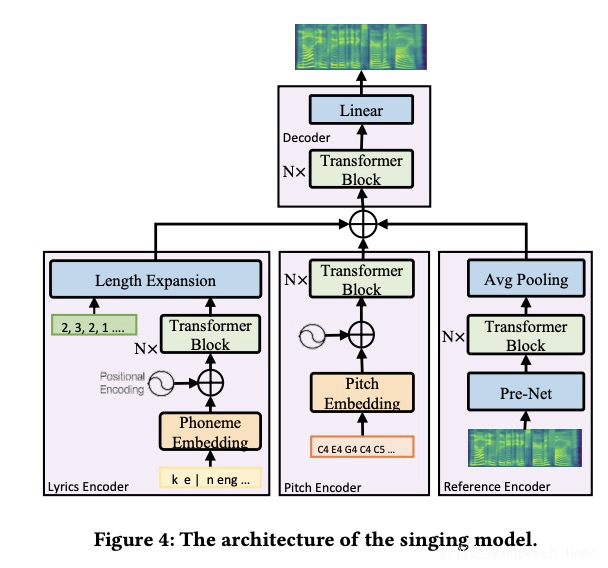
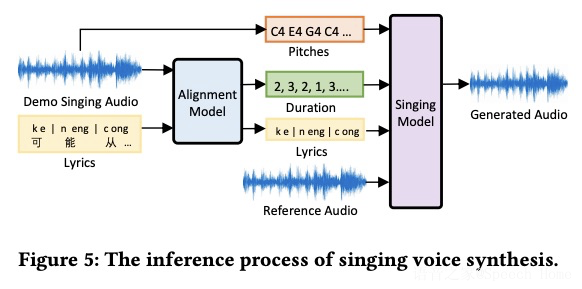
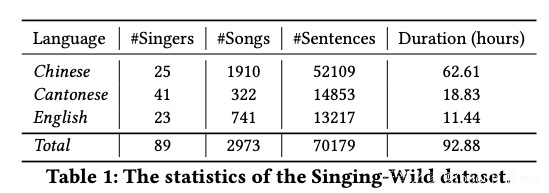
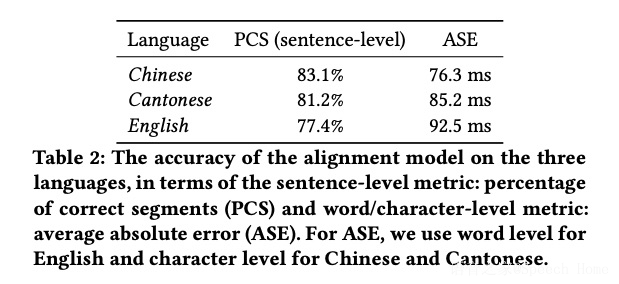
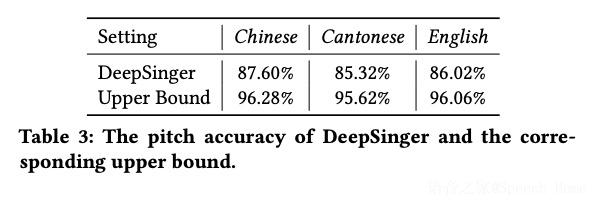
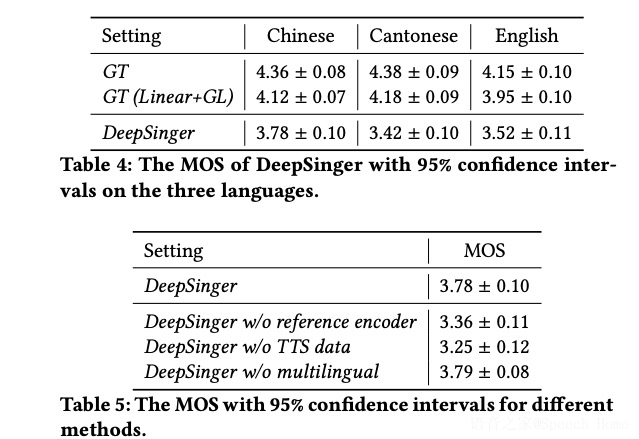
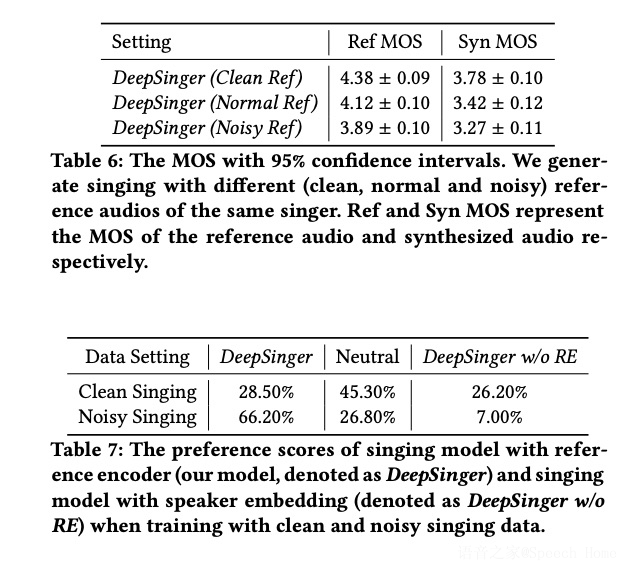
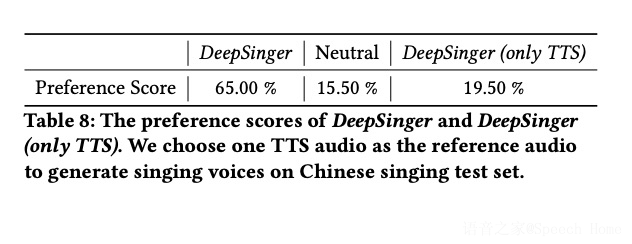
歌唱合成是一项非常有趣的研究,但歌唱合成的训练语料十分昂贵,往往获得较好的训练语料需要花费上百万的成本,因此很少有企业和研究所能够承担此种开销。为了解决数据的问题,本文是首次使用网络爬取的数据进行模型训练,总体效果还算不错,也为很多研究者提供思路。先来看一下DeepSinger整体的流程(图1所示):1)网上爬取歌曲和相应的歌词;2)使用Spleeter进行歌曲的歌声和伴奏的分离,获取干声;3)歌词和歌声之间的对齐,获取时长信息;4)进行数据筛选,获取较好的训练语料;5)歌唱合成系统的训练;
歌声转换
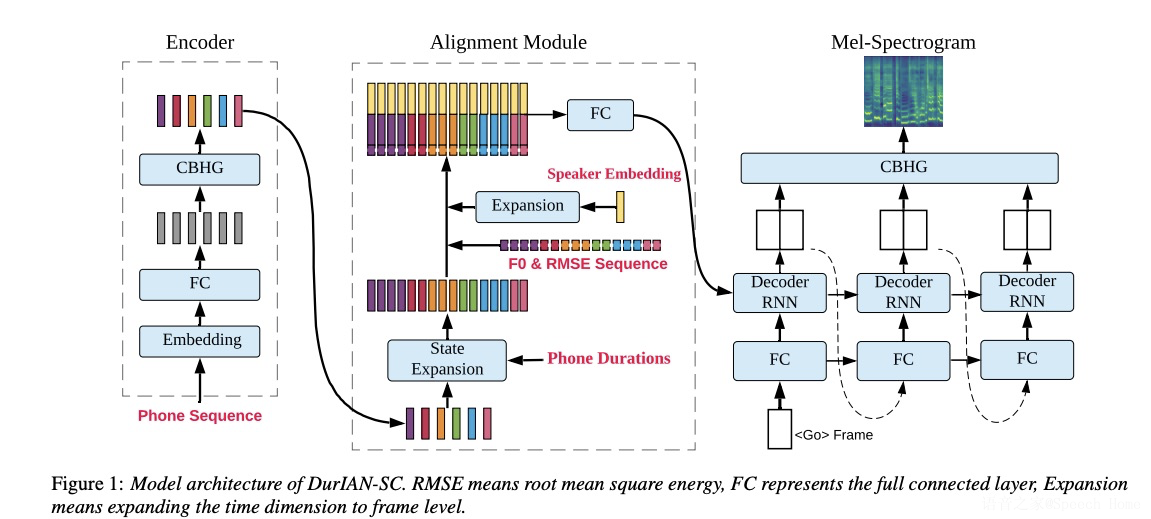
1)Durian-sc: Duration informed attention network based singing voice conversion system
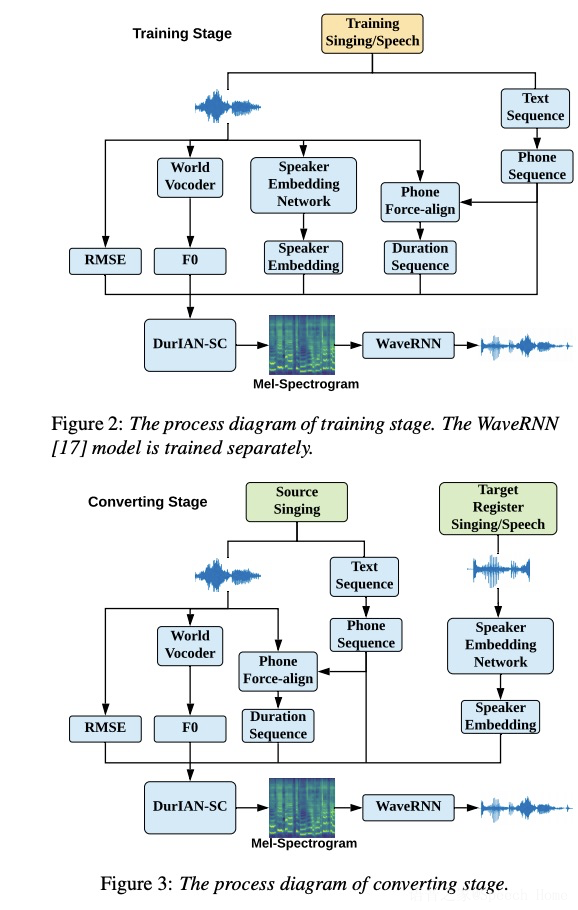
本文的研究方向是把普通的音频转换成歌唱音频。本文在DurIAN(duration informed attention network)基础上提出了DurIAN-SC (sing conversion),本系统如图2所示主要包括三个部分:encoder, alignment module 和 decoder。其中encoder主要把音素序列转成隐向量。对齐模块则把音素级别根据时长扩展成帧级别的特征。最后,最回归模式的decoder根据对齐模块的输出进行逐帧推理。
迁移学习
1)learn2sing target speaker singing voice synthesis by learning from a singing teacher
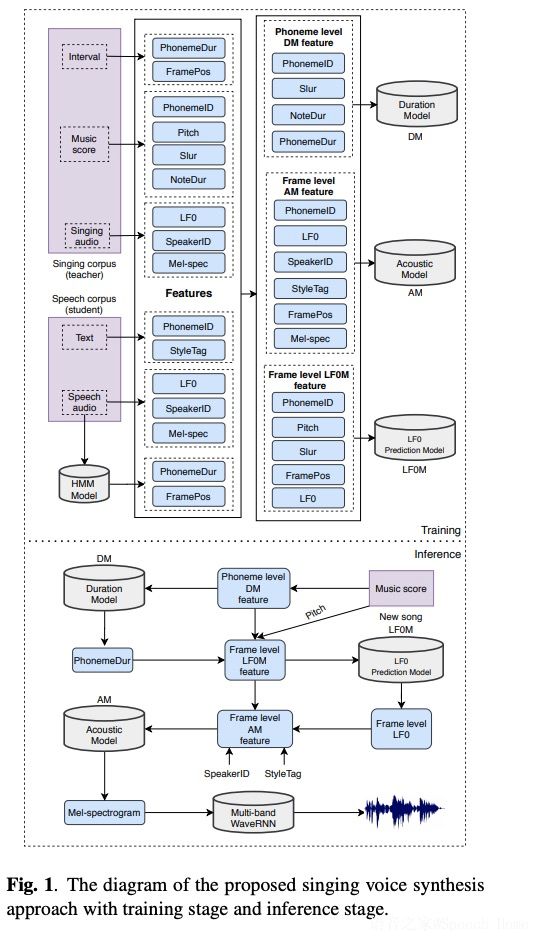
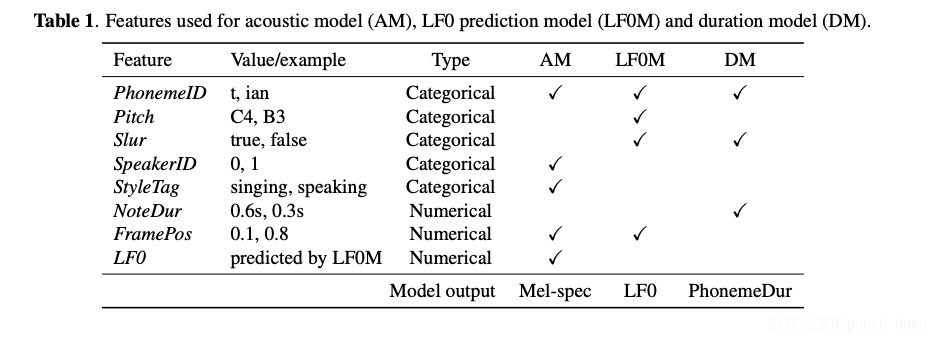
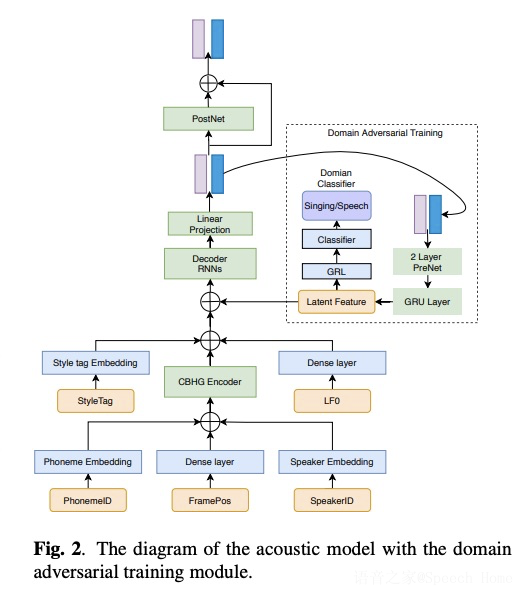
本文设计了一种只输入歌词和乐谱就可以让普通语音合成歌声的系统,实验验证本方法可行。该系统主要包含三个模型(图1所示):Duration model (DM), LF0 prediction model (LF0M)和Acoustic model(AM),其中AM模型使用可domain adversarial training(DAT)进行歌唱类型解耦。另外,训练和推理阶段如图一所示,简单明了,而且每个模型的输入特征如table 1列出。其中声学模型如图2所示的encoder-decoder架构,其decoder为自回归模式(AM就是去掉attention的tacotron,因为已经有duration model了)。当进行推理阶段,先使用乐谱进行音素的duration预测,然后进行LF0的预测,最后设定目标speaker id和sing 的style tag进行声学特征的推理,最后使用声码器合成音频。
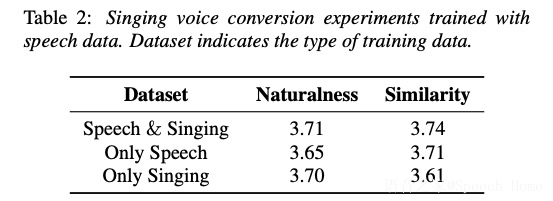
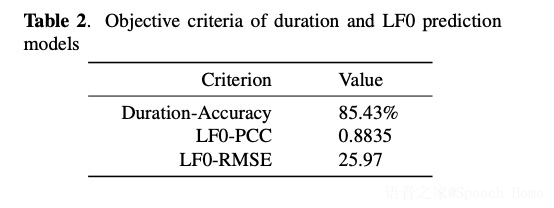
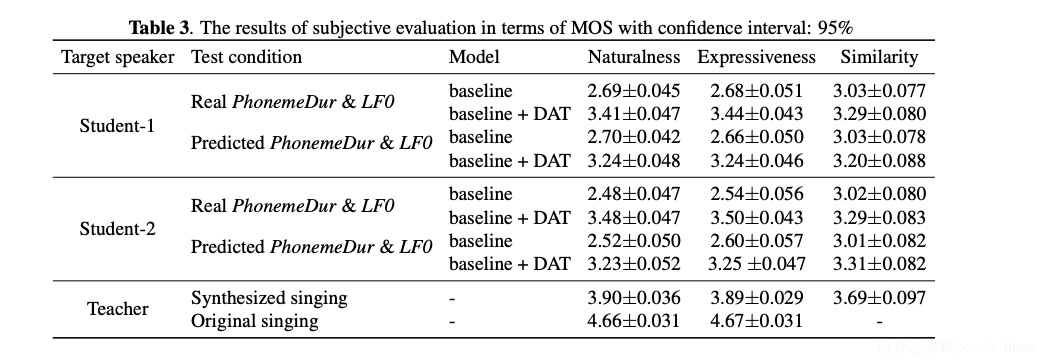
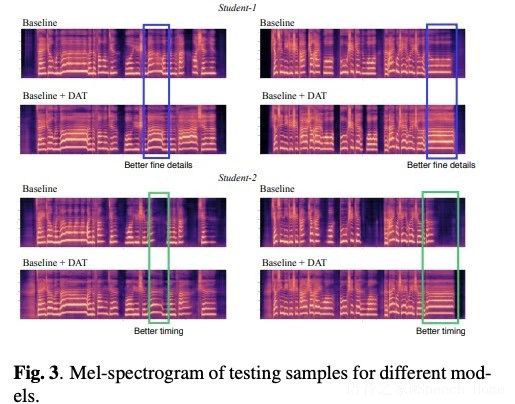
首先对比客观的指标,由table 2显示三个指标结果,其实最主要还是主观的听感。table 3的主观MOS测试显示,普通语句student 1和2 可以合成音乐,而且使用DAT网络效果更好,由图3的语谱图也可以看出使用DAT的频谱刻画更清晰。
引用
【1】Xue H, Yang S, Lei Y, et al. Learn2Sing: Target Speaker Singing Voice Synthesis by learning from a Singing Teacher[J]. arXiv preprint arXiv:2011.08467, 2020.
【2】Zhang L, Yu C, Lu H, et al. Durian-sc: Duration informed attention network based singing voice conversion system[J]. arXiv preprint arXiv:2008.03009, 2020.
【3】Chen J, Tan X, Luan J, et al. HiFiSinger: Towards High-Fidelity Neural Singing Voice Synthesis[J]. arXiv preprint arXiv:2009.01776, 2020.
【4】Lu P, Wu J, Luan J, et al. XiaoiceSing: A High-Quality and Integrated Singing Voice Synthesis System[J]. arXiv preprint arXiv:2006.06261, 2020.
【5】Gu Y, Yin X, Rao Y, et al. ByteSing: A Chinese Singing Voice Synthesis System Using Duration Allocated Encoder-Decoder Acoustic Models and WaveRNN Vocoders[J]. arXiv preprint arXiv:2004.11012, 2020.
【6】Ren Y, Tan X, Qin T, et al. Deepsinger: Singing voice synthesis with data mined from the web[C]//Proceedings of the 26th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining. 2020: 1979-1989.
