文章来源于音频语音与语言处理研究组,作者琚雨恺
实时通信 (RTC) 在我们的日常生活中变得不可或缺,诸如腾讯会议在内的语音RTC应用已经成为我们日常使用的高频在线交流工具。然而,在通话过程中语音质量往往受到背景噪声、混响、无关说话人等干扰的显著影响。有效的语音增强在 RTC 系统中起着至关重要的作用。典型的语音增强方案主要侧重于去除背景噪声和混响,无法过滤掉干扰人声。为此,个性化语音增强(Personalized Speech Enhancement, PSE)技术应运而生,该技术旨在根据目标说话人注册语音片段作为先验,从带有干扰(包括噪声、干扰人声)的语音中提取目标说话人的语音,因此该技术又称为目标说话人提取(Target Speaker Extraction)。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)和腾讯天籁实验室(TEA Lab)合作论文“TEA-PSE 2.0: SUB-BAND NETWORK FOR REAL-TIME PERSONALIZED SPEECH ENHANCEMENT”被语音旗舰会议SLT 2022接收。该工作在之前ICASSP 2022深度噪声抑制(DNS2022)挑战赛个性化语音增强赛道排名第一的TEA-PSE系统上进行了进一步优化,将其扩展到子带版本 - TEA-PSE 2.0,以降低计算复杂度并进一步提高性能。具体而言,采用有限脉冲响应滤波器组和频谱分割来降低计算复杂度。在系统中引入了一个时频卷积模块 (TFCM),用于通过小卷积核来增加感受野。此外探索了训练策略来优化两阶段网络,并研究了 PSE 任务中的各种损失函数的影响。TEA-PSE 2.0 在语音增强性能和计算复杂度上都明显优于 TEA-PSE。在 DNS2022 盲测集上的实验结果表明,与之前的 TEA-PSE 相比,TEA-PSE 2.0 带来了 0.102 OVRL pDNSMOS 改进,乘法累加操作数仅为TEA-PSE的 1/5。
论文题目:TEA-PSE 2.0: SUB-BAND NETWORK FOR REAL-TIME PERSONALIZED SPEECH ENHANCEMENT
作者列表:琚雨恺,张是民,饶为,王燕南,余涛,谢磊,商世东
论文&Demo:https://jvyvkai.github.io/TEAPSE2/
图1 发表论文截图
近期的ICASSP 2022 DNS竞赛[1]Track2旨在促进全频段实时个性化语音增强技术的发展。基于两阶段框架的TEA-PSE[2]在该赛道上获得第一名的优异成绩。但该模型具有每秒 27.84G乘法累加运算 (MAC) 的高计算复杂度,并且由于作用在全频带信号上,该系统的实时因子(RTF)高达0.96 。此外正如文献[3]中指出卷积感受野受限,TEA-PSE 中使用的编码器-解码器结构无法有效地捕获特征长时相关性。
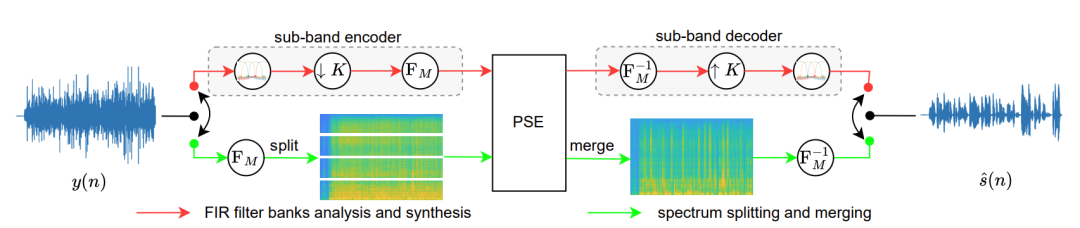
为了降低计算复杂度,一种直观的方法是特征压缩。例如,RNNoise和Personalized PercepNet分别使用 Bark 尺度和等效矩形带宽 (ERB) 尺度压缩全频带输入特征。这种特征压缩方法不可避免地丢失关键的频带信息,影响性能。第二种方式是频谱分割,这在近期语音增强(SE)研究中很常见。文献 [4]和[5] 在短时傅里叶变换(STFT)之后进行频谱分割,将堆叠的子带作为一个batch,而不是直接对全带特征进行建模。与此类批处理方法不同,DMF-Net 和 SF-Net 使用具有级联结构的频谱分割。在处理高频段时,预处理后的低频段将给予外部的知识指导。第三种方式是基于有限脉冲响应(FIR)的子带分析和合成,可以有效降低经典数字信号处理中的带宽[6]。在语音合成领域,多频带 WaveRNN 和多频带MelGAN 使用子带获得了更高的MOS得分;在音乐分离(MSS)任务上,子带处理明显优于全带处理。另一方面,最近的多阶段语音增强方法表现出优越的性能,其直观的假设是原始复杂的语音增强问题可以分解为多个更简单的子问题,并且可以在每个阶段逐步获得更好的解决方案。尽管有专门设计的模型结构,但我们也注意到这些方法中采用的优化策略非常不同。具体来说,SDD-Net和 TEA-PSE[6]在训练当前模块时冻结前一阶段的模块。不同的是,CTS-Net以较低的学习率微调先前的模块。不同于分阶段训练,Wang 等人[7]采用端到端的训练方法,其中不同的模块同时使用单个损失函数进行优化。为此,我们仍然需要进行对比分析,旨在找到多阶段方法的最佳训练策略。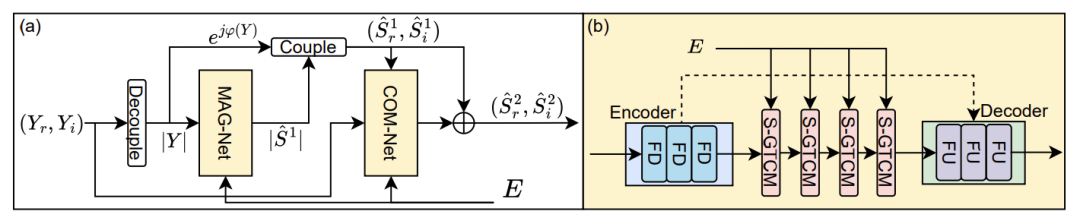
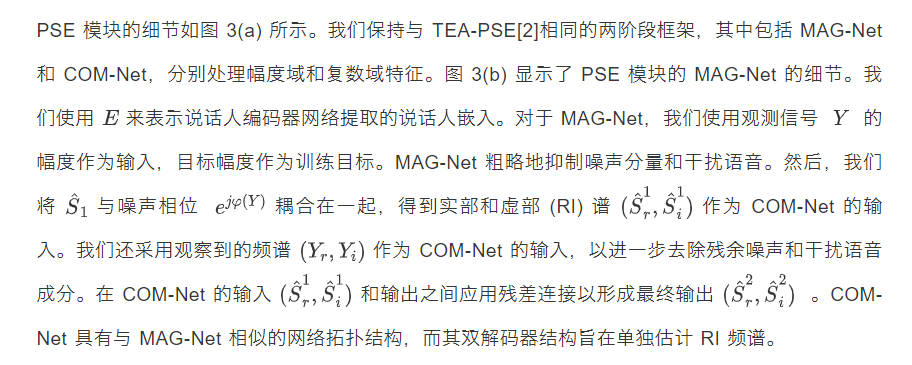
图3(a)PSE 模块的详细信息;(b)MAG-Net 的网络细节
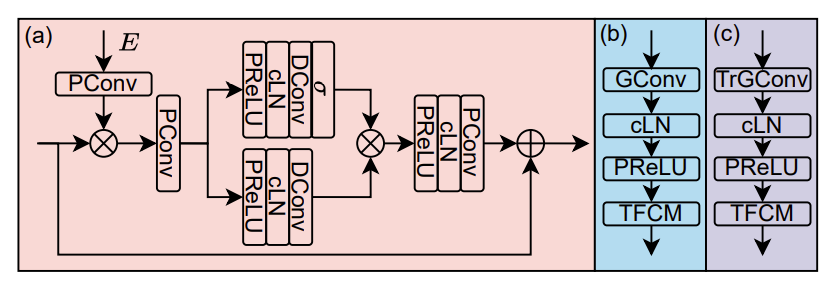
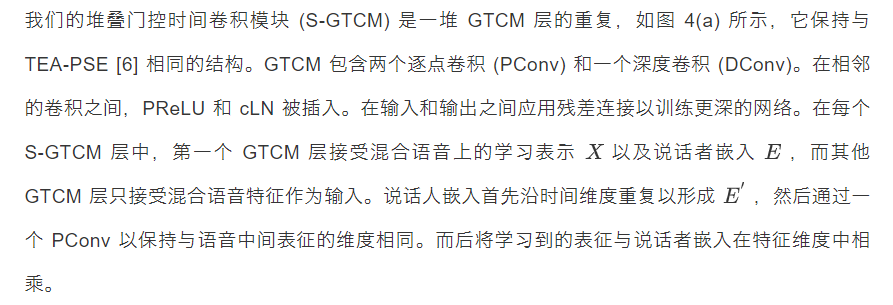
图4 网络子模块细节
编码器和解码器
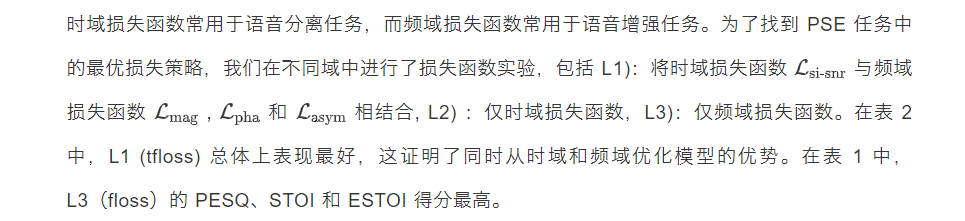
编码器由三个频率下采样 (FD) 层组成。图 4(b) 显示了 FD 层的细节。门控卷积 (GConv) 之后是累积层范数 (cLN)、PReLU 和时频卷积模块 (TFCM)[8] 。我们使用 TFCM 来增加感受野,以解决原始卷积编码器-解码器结构 [7] 中感受野有限的问题。解码器具有三个频率上采样 (FU) 层,其结构详细如图 4(c) 所示。它使用镜像结构作为 FD 层并使用转置门控 Conv (TrGConv) 来代替 GConv。损失函数主要由以下四个部分构成,其中幅度和复数MSE Loss用于衡量增强后的语音和干净语音在幅度域和复频域的相似性,SISNR Loss用于衡量时域的相似性。非对称损失函数用于对幅度域上的目标说话人语音过度抑制现象进行额外的惩罚。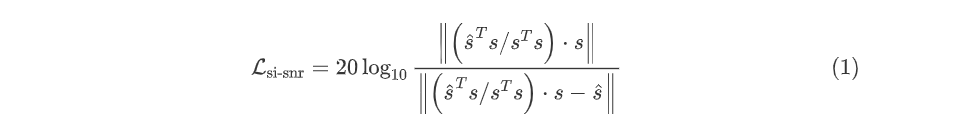
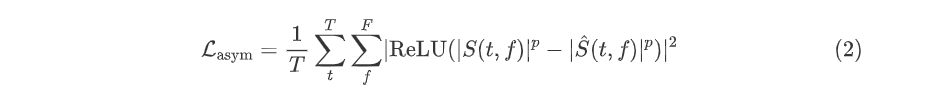
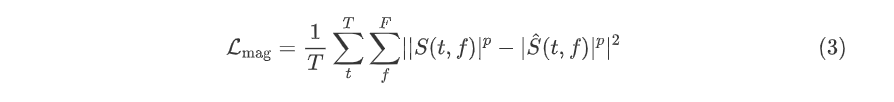
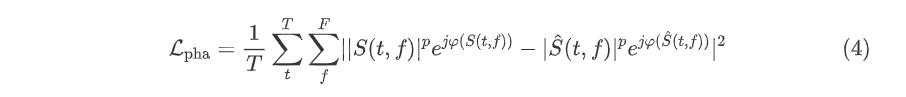
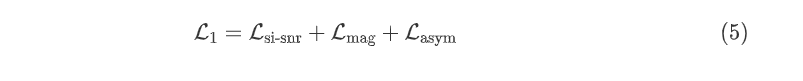
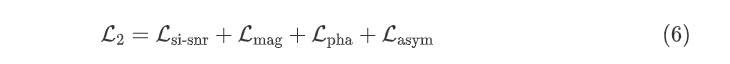
我们使用 ICASSP 2022 DNS-challenge 全频带(full-band)数据集 [5] 进行实验。大约 750 小时的干净语音和 181 小时的噪音片段构成了个性化 DNS (PDNS) 训练集。共有 3230 位说话人。噪声数据来自 DEMAND、Freesound 和 Audio Set数据库。训练数据是动态生成的,并在每批(batch)中分割成 10秒片段,SNR 和 SIR 范围分别为 [-5, 20] dB 和 [-5, 20] dB。混合语音音量调整为 [−35, −15] dBFS。此外,训练期间 50% 的源语音数据与 RIR 进行卷积以模拟混响场景。此外,20% 的训练数据只包含一个干扰说话人,30% 包含一个干扰说话人和一种噪声,30% 只包含一种噪声,剩下的 20% 包含两种噪声。测试集分为两个部分,第一部分为我们用KING-ASR-215数据集生成的集外仿真测试集;另一部分为DNS竞赛官方的盲测集。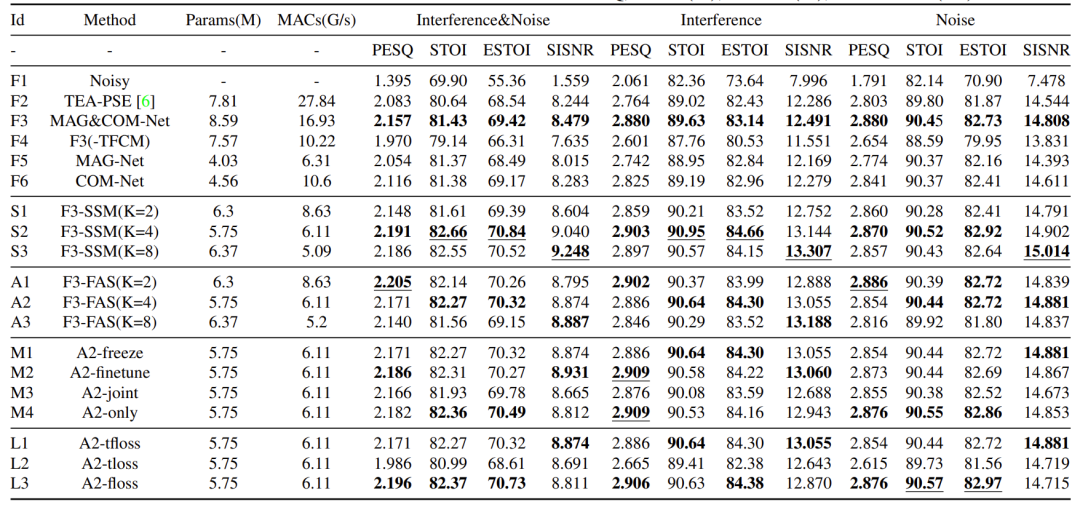
全带输入消融实验
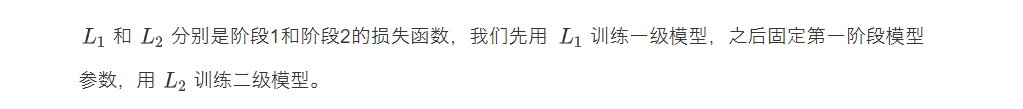
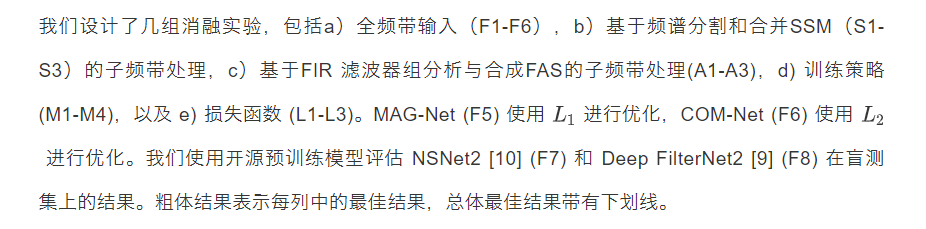
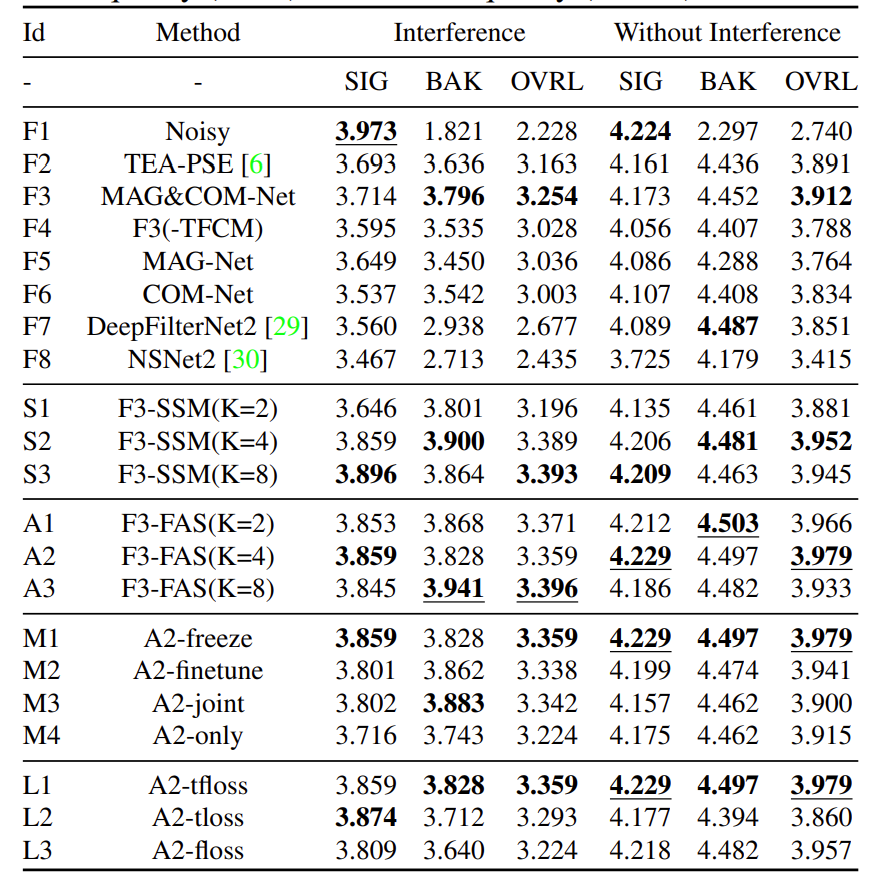
从表 1 中可以看出,两阶段 MAG&COM-Net (F3) 在所有指标中都超越了其他方法。将 F3 与 F2 (TEA-PSE) 进行比较,MAG&COM-Net 的性能优于 TEA-PSE,它的复杂度仅为 TEA-PSE 的 60%。比较 F3 和 F4(MAG&COM-Net without TFCM),TFCM 模块可以有效地扩展感受野来学习编码器和解码器的时序相关性。在表 2 中,TFCM 带来了 0.116 SIG、0.081 BAK 和 0.136 OVRL 的性能提升。将 F5(MAG-Net)和 F6(COM-Net)与 F3 进行比较,使用两级网络进一步抑制噪声和干扰说话人声是非常有效的。对于表 2 中的 DNS 盲测集,MAG&COM-Net 优于其他基线系统。基于 FAS 和 SSM 的子带处理优于全带功能,同时大大降低了计算复杂性。这是因为子带输入使模型能够将不同的能力分配给不同的子带,而具有全带输入的模型由于高频和低频能量的差异而往往具有高频损耗。对于基于SSM的子带处理,S2(SSM,K=4)和S3(SSM,K=8)的性能相近,优于S1(SSM,K=2)。这可以归因于随着步幅变小,模型具有更好的频率建模能力。对于基于FAS的子带处理,随着子带数量的增加,信号重构误差会变大。所以在表 1 中,A3 (FAS, K=8) 的效果不如 A1 (FAS, K=2) 和 A2 (FAS, K=4)。一般来说,4 个子带输入在子带输入实验中表现最好。A2 是我们随后在训练策略和损失函数的消融研究中进行实验的基线。我们探索了 4 种不同的两阶段网络训练策略,包括 M1):预训练 MAG-Net,然后在训练 COM-Net 时将其冻结,M2):预训练 MAG-Net,然后以较小的学习率对其进行微调训练 COM-Net ,M3):使用 L1 + L2 同时训练 MAG-Net 和 COM-Net, M4):仅使用 L2 训练整个网络。结果表明,M1(冻结)提供最佳的整体性能,如表 2 所示,而 M2(微调)也具有良好的性能。对于 M4(仅优化最终输出,不对中间结果做约束),仅优化 L2 会对性能产生负面影响,这表明对中间结果进行显式约束的重要性。根据以上实验结果,我们得出结论,顺序训练,即逐个优化网络模块,是PSE任务中首选的两阶段模型训练策略, 尽管这需要更多的训练时间。第一组(with speaker interference)
Noisy:
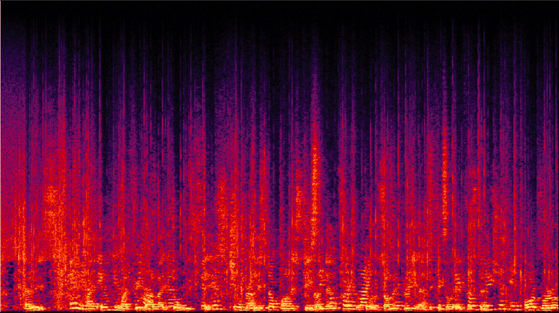
TEA-PSE:
Full-band TEA-PSE 2.0:
Sub-band TEA-PSE 2.0:
第二组(without speaker interference)
Noisy:noisy_2音频
TEA-PSE:
Full-band TEA-PSE 2.0:
Sub-band TEA-PSE 2.0:
更多样例敬请访问:
https://jvyvkai.github.io/TEAPSE2/
[1] H. Dubey, V. Gopal, R. Cutler, A. Aazami, S. Matusevych, S. Braun, S. E. Eskimez, M. Thakker, T. Yoshioka, H. Gamper, et al., “ICASSP 2022 deep noise suppression challenge,” in ICASSP. IEEE, 2022, pp. 9271– 9275.[2] Y. Ju, W. Rao, X. Yan, Y. Fu, S. Lv, L. Cheng, Y. Wang, L. Xie, and S. Shang, “TEA-PSE: Tencent-ethereal-audio-lab Personalized Speech Enhancement System for ICASSP 2022 DNS CHALLENGE,” in ICASSP. IEEE, 2022, pp. 9291–9295.[3] S. Zhao, B. Ma, K. N. Watcharasupat, and W. Gan, “FRCRN: Boosting feature representation using frequency recurrence for monaural speech enhancement,” in ICASSP. IEEE, 2022, pp. 9281–9285.[4] S. Lv, Y. Hu, S. Zhang, and L. Xie, “DCCRN+: Channel-Wise Subband DCCRN with SNR Estimation for Speech Enhancement,” in Interspeech, 2021, pp. 2816–2820.[5] J. Li, D. Luo, Y. Liu, Y. Zhu, Z. Li, G. Cui, W. Tang, and W. Chen, “Densely connected multi-stage model with channel wise subband feature for real-time speech enhancement,” in ICASSP. IEEE, 2021, pp. 6638–6642.[6] T. Q. Nguyen, “Near-perfect-reconstruction pseudo-qmf banks,” IEEE Trans. Signal Process., vol. 42, no. 1, pp. 65–76, 1994.[7] H. Wang and D. Wang, “Cross-domain speech enhancement with a neural cascade architecture,” in ICASSP. IEEE, 2022, pp. 7862–7866.[8] G. Zhang, L. Yu, C. Wang, and J. Wei, “Multi-scale temporal frequency convolutional network with axial attention for speech enhancement,” in ICASSP. IEEE, 2022, pp. 9122–9126.[9] H. Schroter, T. Rosenkranz, A. Maier, et al., “Deepfilternet2: Towards real-time speech enhancement on embedded devices for full-band audio,” arXiv preprint arXiv:2205.05474, 2022.[10] S. Braun and I. Tashev, “Data augmentation and loss normalization for deep noise suppression,” in International Conference on Speech and Computer. Springer, 2020, pp. 79–86.
 西工大音频语音与语言处理研究组